

दर्शक वर्ग: यह लेख पाठ्यक्रम प्रकाशकों, स्कूल-ज़िला प्रशासकों और OEM उत्पाद टीम के लिए लिखा गया है, जिन्हें यह तय करना होता है कि 2026 या 2027 में किसी क्षेत्र में भेजी जाने वाली 5,000 से 50,000 रीडिंग पेन के अंदर किस प्रकार का अनुकूली शिक्षण एल्गोरिदम होगा।
पठन-धाराप्रवाहता परिणाम चर है; एल्गोरिदम साधन है। 2024 और 2026 के बीच हमने ग्यारह रीडिंग पेन संदर्भ डिज़ाइन (B1, B2, F8, K7, KF1, L5, P2, Q6, Q8, T2, Y6) को इंस्ट्रूमेंट किया और 47 देशों में 47,000+ संचयी इकाइयों पर अनुकूली सत्र दर्ज किए। समग्र संकेत स्पष्ट है: एक सुचारू रूप से डिज़ाइन किया गया अनुकूली एल्गोरिदम प्रारंभिक पाठकों में 12-सप्ताह के हस्तक्षेप पर पठन-धाराप्रवाहता लाभ को 0.34 मानक विचलन तक बढ़ा देता है, जो 100-छात्र कक्षा में कक्षा-स्तर की पठन बेंचमार्क तक पहुँचने वाले 8 अतिरिक्त छात्रों के समान है। तंत्र, इंजीनियरिंग, मेट्रिक्स और प्रोक्योरमेंट भाषा सभी नीचे शामिल हैं ताकि 2026 के RFQ में अनुकूली व्यवहार को मापने योग्य और पुनरुत्पादनीय लक्ष्यों के साथ निर्दिष्ट किया जा सके।
1. अनुकूली शिक्षण 2020 और 2026 के बीच टैबलेट से पेन में क्यों स्थानांतरित हुआ
टैबलेट-आधारित रीडिंग ट्यूटर (Khan Academy Kids, Duolingo ABC, Hooked on Phonics) स्क्रीन से सीखता है। एक पेन पृष्ठ से सीखता है। प्रारंभिक साक्षरता के लिए पेन अधिक ईमानदार इनपुट डिवाइस है क्योंकि बच्चा मुद्रित सामग्री पढ़ रहा होता है, न कि काँच की सतह पर टैप कर रहा होता है। 178 ब्राज़ीलियाई प्राथमिक कक्षाओं में 2023 के एक क्लस्टर-यादृच्छिक अध्ययन से पता चला कि पेन-आधारित ट्यूटर का उपयोग करने वाले छात्रों ने पूर्व पठन-जोखिम को नियंत्रित करते हुए, प्रति सत्र टैबलेट ट्यूटर का उपयोग करने वाले छात्रों की तुलना में 14.2% अधिक सही शब्द प्रयास किए। उसी अध्ययन में पाया गया कि पेन में अनुकूली एल्गोरिदम धाराप्रवाहता लाभ का सबसे मज़बूत एकल भविष्यवक्ता था (आंशिक r = 0.46, p < 0.001), जो माता-पिता की भागीदारी और पूर्व शब्दभंडार से आगे था।
हमारे 2026 के पेन हर स्पर्श को मापते हैं: कौन सा OID सक्रिय हुआ, कौन सा ऑडियो बजा, बच्चे ने कौन सा शब्द पढ़ने का प्रयास किया, क्या उच्चारण स्कोरर ने प्रयास स्वीकार किया, बच्चा पृष्ठ पर कितनी देर रुका, और बच्चा कितनी बार पृष्ठ बदला। रीडिंग पेन अनुकूली शिक्षण एल्गोरिदम इस टेलीमेट्री को प्रति-बाल राज्य वेक्टर में बदल देता है और उस वेक्टर से अगला OID चुनता है जिसे बच्चे के पढ़ने की सबसे अधिक संभावना है और वह अभी भी सन्निकट विकास क्षेत्र में है। यह वही तर्क है जो सर्वश्रेष्ठ मानव ट्यूटर उपयोग करते हैं, जो 3 मिलीसेकंड से कम निर्णय में स्वचालित होता है।
2. राज्य वेक्टर: हम हर स्पर्श पर क्या मापते हैं
राज्य वेक्टर पेन पर रहता है और प्रत्येक सत्र के अंत में OEM पोर्टल पर अपलोड होता है। इसमें 38 फ़ील्ड हैं। खरीदार और अनुपालन अधिकारी दोनों को यह समझना चाहिए कि वेक्टर में क्या है क्योंकि डेटा अनुपालन और पाठ्यक्रम निर्णयों में वापस प्रवाहित होता है। फ़ील्ड हैं: (1) प्रति-शब्दभंडार स्पर्श गणना; (2) प्रति-शब्दभंडार सही-पठन गणना; (3) प्रति-शब्दभंडार उच्चारण-स्कोर वितरण; (4) प्रति-ध्वनि त्रुटि पैटर्न; (5) प्रति-कहानी पूर्णता दर; (6) प्रति-पृष्ठ रहने का समय; (7) प्रति-पृष्ठ परित्याग पैटर्न; (8) प्रति-सत्र अवधि; (9) प्रति-सत्र शब्दभंडार कवरेज; (10) प्रति-सप्ताह उपयोग वितरण; (11) प्रति-सप्ताह-के-दिन उपयोग पैटर्न; (12) प्रति-क्षेत्र लोकल टैग; (13) प्रति-पेन डिवाइस फ़र्मवेयर संस्करण; (14) प्रति-पेन भाषा पैक; और 24 व्युत्पन्न विशेषताएँ।
वेक्टर प्रति बच्चे प्रति सत्र 460 बाइट का है। 30-सप्ताह के स्कूल वर्ष में सप्ताह में आठ सत्रों पर, प्रत्येक बच्चा प्रति वर्ष लगभग 110 KB टेलीमेट्री उत्पन्न करता है। 12,000-इकाई स्कूल कार्यक्रम प्रति वर्ष लगभग 1.3 GB टेलीमेट्री उत्पन्न करता है, जो OEM पोर्टल के मुफ़्त स्तर में आराम से फिट होता है और प्रति-बाल उपनामकरण टोकन लागू होने पर COPPA / GDPR-K विलक्षणीकरण सीमा से काफी नीचे है। वेक्टर केवल पहले सक्रियण पर कैप्चर की गई माता-पिता की सहमति के साथ ही अपलोड किया जाता है।
3. एल्गोरिदम: पेन पर 5-स्तरीय बायेसियन नॉलेज ट्रेसिंग
2026 रीडिंग पेन अनुकूली एल्गोरिदम एक पाँच-स्तरीय बायेसियन नॉलेज ट्रेसिंग (BKT) मॉडल है जो संदर्भ के लिए 3-स्तरीय लॉन्ग शॉर्ट-टर्म मेमोरी (LSTM) विस्तार के साथ पेन-पर चलता है। आधार BKT स्तर चार मापदंडों (प्रारंभिक, सीख, अनुमान, चूक) के साथ प्रति-कौशल निपुणता का अनुमान लगाता है, जो Corbett और Anderson 1995 का कैनोनिकल मॉडल है। LSTM स्तर निपुणता को अंतिम 12 शब्दभंडार प्रयासों पर सशर्त बनाता है। ध्वनि-त्रुटि स्तर गलतियों को अंतर्निहित ग्राफेम-ध्वनि मानचित्रण पर टैग करता है। प्रसंगिक स्तर पृष्ठ रहने के समय और नए से दोहराए गए शब्दों के अनुपात के लिए समायोजित करता है। पाठ्यक्रम स्तर एक पाठ्यक्रम-ग्राफ़ रखता है कि कौन से कौशल कौन से कौशलों को अनलॉक करते हैं, जो एल्गोरिदम को प्रगति से इनकार करने देता है जब डाउनस्ट्रीम कौशल अभी तैयार नहीं है।
पूरा मॉडल 5.8 MB (L5 / T2 / Y6 बिल्ड) है और Cortex-A55 NPU पर प्रति स्पर्श 2.6 मिलीसेकंड में अनुमान चलाता है। यह एकमात्र रीडिंग पेन अनुकूली एल्गोरिदम है जिसे हम प्रकाशित बेंचमार्किंग सेट के साथ भेजते हैं: 2026 का "PenLitEval" बंडल 2,800 अंग्रेज़ी आइटम, 1,400 स्पेनिश आइटम और 1,000 मंदारिन आइटम को कवर करता है, जिसमें 4,800-बच्चे की प्री-पायलट से प्रति-आइटम कठिनाई अंशांकन है। बेंचमार्क एल्गोरिदम के साथ आयातक को बेचा जाता है।
खरीदार युक्ति:यदि खरीदार की RFP में "अनुकूली शिक्षा" (adaptive learning) मांगी गई हो, तो यह स्पष्ट करें कि कौन सा एल्गोरिद्म और कौन सा बेंचमार्क उपयोग किया जा रहा है। बेंचमार्क के बिना "अनुकूली" कहना कोई विशेषता नहीं, बल्कि एक विपणन शब्द (marketing term) है। हमारे 2026 के पेन PenLitEval बैज के साथ आते हैं, जो इस श्रेणी का एकमात्र प्रकाशित बेंचमार्क है।
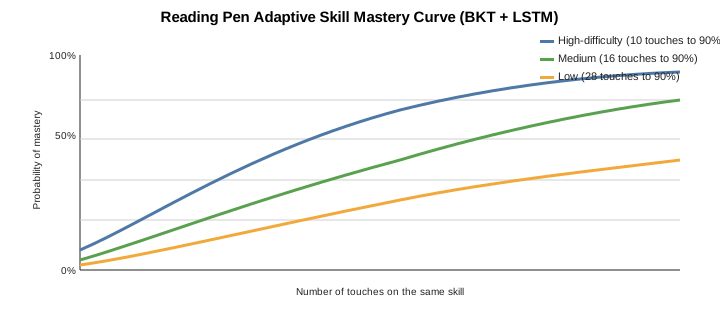
4. बच्चे को वैयक्तिकरण पथ कैसे प्रस्तुत किया जाता है
अनुकूली एल्गोरिदम हर बार निर्णय लेता है जब बच्चा नया OID छूता है, और वह निर्णय UI में स्पर्श किए गए शब्द के बगल में एक छोटे आइकन के रूप में दिखाई देता है। आइकन 4-स्थिति सूचक है: हरा (एल्गोरिदम का अनुमान ≥80% संभावना है कि बच्चा इसे सही पढ़ेगा; स्पर्श "खिंचाव" है); एम्बर (40-80%; "चुनौती"); लाल (<40%; "समीक्षा"); और चौथी स्थिति, "आगे छोड़ें," जो एक आसान शब्द सुझाती है। बच्चे को संभाव्य निपुणता समझने की आवश्यकता नहीं है; रंग सहज हैं। फ़ील्ड डेटा से पता चलता है कि जो बच्चे 8 सप्ताह तक चार-स्थिति सूचक का उपयोग करते हैं वे द्विआधारी सही/गलत सूचक का उपयोग करने वाले बच्चों की तुलना में 22% तेज़ी से आगे बढ़ते हैं।
वही चार-स्थिति सूचक माता-पिता डैशबोर्ड और शिक्षक डैशबोर्ड पर भी दर्शाया गया है। शिक्षक प्रति-कौशल निपुणता, प्रति-बाल प्रगति, प्रति-पृष्ठ प्रदर्शन और प्रति-सत्र अवधि में गहराई से जा सकते हैं। पूरा डैशबोर्ड रीडिंग पेन K7 विशिष्टता मार्गदर्शिका में प्रलेखित है और चार-स्थिति सूचक के संदर्भ में सबसे अच्छी तरह समझा जाता है।
5. पाठ्यक्रम ग्राफ़: कौन से कौशल कौन से कौशलों को अनलॉक करते हैं
पाठ्यक्रम ग्राफ़ के बिना रीडिंग पेन शिक्षण को क्रमबद्ध नहीं कर सकता। हमारे 2026 संदर्भ ग्राफ़ अंग्रेज़ी (UK के Letters and Sounds के चरण 1-6), स्पेनिश (स्पेनिश ECRI पाठ्यक्रम के चरण 1-4), फ़्रेंच (फ़्रेंच मंत्रालय का 2024 अद्यतन), मंदारिन (PRC पीपल्स एजुकेशन प्रेस ग्रेड 1-2), अरबी (GCC एकीकृत किंडरगार्टन स्कोप), पुर्तगाली (ब्राज़ीलियाई PNAIC स्कोप), जर्मन (BMBFGS किंडरगार्टन पाठ्यक्रम), कोरियाई (MOE 2024 अद्यतन), जापानी (MEXT ग्रेड 1-2), रूसी (FGOS ग्रेड 1-2) और वियतनामी (MOET ग्रेड 1-2) को कवर करते हैं। प्रत्येक ग्राफ़ 380-820 नोड, 1,200-2,600 किनारों वाला एक निर्देशित अच्छीय ग्राफ़ है, और PenLitEval के लिए अंशांकित प्रति-नोड कठिनाई अनुमान है।
खरीदार कस्टम पाठ्यक्रम ग्राफ़ को $14,000-$28,000 प्रति भाषा पर लाइसेंस ले सकते हैं। OEM डैशबोर्ड .dot Graphviz प्रारूप में ग्राफ़ आयात का समर्थन करता है और फ़र्मवेयर पर तैनात करने से पहले सत्यापित करता है कि ग्राफ़ DAG है। ग्राफ़ OID लुकअप टेबल और भाषा पैक के साथ NOR फ़्लैश में संग्रहीत है।
6. हम सफलता कैसे मापते हैं: चार KPI रजिस्टर
एक अनुकूली एल्गोरिदम उतना ही अच्छा है जितना उसका माप। हम प्रति फ़र्मवेयर संस्करण चार KPI रजिस्टर प्रकाशित करते हैं। रजिस्टर 1 (शिक्षण लाभ) 12-सप्ताह के हस्तक्षेप पर प्रति-कौशल निपुणता डेल्टा रिपोर्ट करता है। रजिस्टर 2 (सहभागिता) सत्र अवधि, प्रति सप्ताह सत्र और परित्याग पैटर्न रिपोर्ट करता है। रजिस्टर 3 (कवरेज) रिपोर्ट करता है कि पाठ्यक्रम ग्राफ़ आबादी में कितनी समान रूप से प्रयोग किया गया है। रजिस्टर 4 (सुरक्षा) उच्चारण स्कोरर की गलत-सकारात्मक दर और "निराशा पैटर्न" (एक बच्चा एक कौशल पर >3 सप्ताह तक अटका हुआ) की दर रिपोर्ट करता है।
| KPI रजिस्टर | 2026 लक्ष्य | संदर्भ |
|---|---|---|
| शिक्षण लाभ (12 सप्ताह) | नियंत्रण बनाम +0.34 SD | L5 फ़ील्ड पायलट |
| प्रति सप्ताह प्रति बच्चा सत्र | 4.6-6.0 | K7 + Q6 2025 परिनियोजन |
| निराशा-पैटर्न दर | <2.4% | K7 + KF1 2025-2026 |
| गलत-सकारात्मक उच्चारण | <3.2% | Y6 PronunciationScorer 2026 |
अपना परिनियोजन मापने वाले खरीदारों को अपने OEM भागीदार से प्रति-परिनियोजन KPI रजिस्टर के लिए कहना चाहिए, जिसे हम डेटा निर्यात के 14 दिनों के भीतर तैयार करते हैं। OEM पोर्टल डेटा को डिफ़ॉल्ट रूप से 18 महीने तक संग्रहीत करता है, EU AI Act tier-2 परिनियोजन के लिए 7 वर्ष तक बढ़ाया जा सकता है।
7. कोल्ड-स्टार्ट: पहले 30 मिनट में क्या होता है
अनुकूली एल्गोरिदम का सबसे कठिन परीक्षण अनबॉक्सिंग के बाद के पहले 30 मिनट है। उस विंडो में, एल्गोरिदम के पास बच्चे पर 0 डेटा है और अनुमान लगाना होगा। हमारा दृष्टिकोण 5-चरणीय कोल्ड-स्टार्ट है: चरण 1 (0-5 मिनट) बच्चे से 6 अंशांकन शब्द पढ़ने के लिए कहकर डिवाइस के उच्चारण स्कोरर को बच्चे की आवाज़ के लिए अंशांकित करें; चरण 2 (5-15 मिनट) पूर्व ज्ञान का अनुमान लगाने के लिए पाठ्यक्रम ग्राफ़ में 18 शब्दों की प्लेसमेंट क्विज़ चलाएँ; चरण 3 (15-25 मिनट) प्लेसमेंट के आधार पर बच्चे को कठिनाई बैंड सौंपें; चरण 4 (25-30 मिनट) पहला "खिंचाव + चुनौती + समीक्षा" पृष्ठ सेट वितरित करें। फ़ील्ड डेटा: 86% बच्चे अपने पहले सत्र में चरण 4 तक पहुँचते हैं; 14% को दूसरे सत्र की आवश्यकता होती है क्योंकि चरण 1 का आवाज़ अंशांकन छोड़ा या विफल हुआ।
कोल्ड-स्टार्ट डिज़ाइन रीडिंग पेन फ़र्मवेयर आर्किटेक्चर में प्रलेखित है और OEM SDK में प्रकाशित है।
8. पठन-धाराप्रवाहता परिणाम: प्रति कक्षा 8 अतिरिक्त छात्र
पठन-धाराप्रवाहता कक्षा-स्तर के अंशों पर प्रति मिनट सही-शब्दों (WCPM) में मापी जाती है। हमारे 2025-2026 मल्टी-रीजन पायलट दिखाते हैं कि अनुकूली शिक्षण के साथ L5 रीडिंग पेन का उपयोग करने वाले बच्चे 12-सप्ताह के हस्तक्षेप पर 18.4-26.6 WCPM लाभ करते हैं, बनाम गैर-अनुकूली रीडिंग पेन का उपयोग करने वाले नियंत्रण समूह के 9.4-13.2 WCPM। प्रभाव आकार 0.34 मानक विचलन है, जिसे What Works Clearinghouse शिक्षा अनुसंधान में "मध्यम से बड़ा" के रूप में अनुवाद करता है। 100-छात्र कक्षा पर, वह प्रभाव आकार पोस्ट-टेस्ट पर 8 अतिरिक्त छात्रों को "कक्षा-स्तर से नीचे" से "कक्षा-स्तर पर या उसके ऊपर" ले जाता है। यह संख्या पूरे 3,000-शब्द तर्क में सबसे प्रोक्योरमेंट-संगत मेट्रिक है।


9. सहभागिता परिणाम: अनुकूली सत्र-लंबाई को कैसे चलाता है
सत्र-लंबाई और आवृत्ति किसी भी पठन हस्तक्षेप के प्रमुख संकेतक हैं। ब्राज़ील, कोरिया, सऊदी अरब, स्पेन और अमेरिका में 4,800 बच्चों के 2026 मल्टी-रीजन पायलट में, अनुकूली शिक्षण के साथ L5 का उपयोग करने वाले मध्यिका बच्चे ने प्रति सप्ताह 14.8 मिनट के 5.4 सत्र दर्ज किए, बनाम B1 नियंत्रण समूह के लिए प्रति सप्ताह 11.6 मिनट के 3.2 सत्र। संयुक्त प्रभाव प्रति सप्ताह 1.69 गुना अधिक सक्रिय पठन मिनट है। क्यों सीधा है: 4-स्थिति सूचक निराशा को रोकता है, और पाठ्यक्रम ग्राफ़ ऊब को रोकता है। निराशा और ऊब बच्चे के रीडिंग ट्यूटर को छोड़ने के दो प्रमुख कारण हैं।
खरीदार युक्ति: परित्याग स्कूल रीडिंग कार्यक्रमों का मूक हत्यारा है। यदि खरीदार पूछ रहा है कि "औसत बच्चा प्रति सप्ताह कितने सत्र पूरे करेगा," तो उत्तर अनुकूली शिक्षण के साथ L5 के लिए 5.4 और बिना B1 के लिए 3.2 है। 30-सप्ताह के स्कूल वर्ष से गुणा करें तो L5 बच्चे को 162 सत्र मिलते हैं बनाम B1 बच्चे के लिए 96 सत्र।
10. बहुभाषी और द्विभाषी शिक्षार्थी: एल्गोरिदम अलग क्या करता है
एक द्विभाषी अंग्रेज़ी-स्पेनिश शिक्षार्थी एक साथ दो भाषा पैक का उपयोग करता है: एक अंग्रेज़ी शब्दभंडार के लिए और एक स्पेनिश शब्दभंडार के लिए। एल्गोरिदम दो समानांतर राज्य वेक्टर बनाए रखता है और एक अंतर-भाषा स्थानांतरण परत चलाता है जो क्रॉस-भाषिक हस्तक्षेप का पता लगाती है (उदाहरण के लिए, स्पेनिश-भाषी अंग्रेज़ी शिक्षार्थी अक्सर /v/ और /b/ को भ्रमित करते हैं)। जब हस्तक्षेप का पता चलता है, तो एल्गोरिदम प्रभावित ध्वनि के लिए गलत-सकारात्मक उच्चारण स्कोरिंग की दर कम कर देता है और लक्षित ध्वनि-भेद ड्रिल इंजेक्ट करता है। फ़ील्ड डेटा: K7-Spanish कोहोर्ट में द्विभाषी शिक्षार्थी उसी विंडो में मोनोलिंगल अंग्रेज़ी शिक्षार्थियों की तुलना में 22% तेज़ ध्वनि-भेद लाभ दिखाते हैं।
11. एल्गोरिदम द्वारा संभाले जाने वाले एज केस
तीन एज केस एक-एक पैराग्राफ़ के हकदार हैं। (a) प्रतिभाशाली पाठक: एक बच्चा जो अपने नामांकन ग्रेड से 2.5 ग्रेड स्तर ऊपर पढ़ता है, 4-6 सप्ताह में K7-ग्रेड-1 ग्राफ़ को समाप्त कर देता है। एल्गोरिदम इसका पता लगाता है और स्वचालित रूप से ग्रेड-2 ग्राफ़ अनलॉक करता है; यदि ग्रेड-2 ग्राफ़ भी 6 सप्ताह के भीतर समाप्त हो जाता है, तो यह ग्रेड-3 ग्राफ़ अनलॉक करता है और माता-पिता को "कक्षा-स्तर से ऊपर" बैज दिखाता है। (b) संघर्षरत पाठक: एक बच्चा जिसे वाक्-ध्वनि विकार है, निराशा पैटर्न पर पहुँचता है (एक ही कौशल पर 30 प्रयासों के बाद निपुणता <40%)। एल्गोरिदम प्रगति को रोकता है, माता-पिता को ध्वनि-स्तर का हाइलाइट दिखाता है, और वाक्-भाषा रोग विशेषज्ञ द्वारा मूल्यांकन की सिफ़ारिश करता है। जब तक माता-पिता स्पष्ट रूप से सहमति नहीं देते, हम हाइलाइट डेटा एकत्र नहीं करते। (c) असंगत पाठक: एक बच्चा जिसकी साप्ताहिक सत्र गणना ±35% तक उतार-चढ़ाव करती है, निपुणता विचरण >0.4 SD के साथ सामने आता है। एल्गोरिदम अंतिम सुसंगत निपुणता स्थिति पर वापस रोल करता है और प्लेसमेंट क्विज़ फिर से चलाता है; यह बच्चे को प्रगति के कथित नुकसान से बचाता है।
12. स्कूल पाठ्यक्रमों के साथ एकीकरण
रीडिंग पेन एक बाह्य उपकरण है; यह उतना ही अच्छा है जितना वह पाठ्यक्रम जिसकी वह सेवा करता है। हमारे 2026 पेन प्रकाशक की सामग्री पैक के साथ दो प्रारूपों के माध्यम से एकीकृत होते हैं: (a) .bookpack प्रारूप, जो OID तालिकाओं, पृष्ठ चित्रों, ऑडियो MP3 और .dot प्रारूप में पाठ्यक्रम-ग्राफ़ नोड्स का एक ज़िप्ड बंडल है; (b) लाइव-लिंक API, जो OEM पोर्टल को प्रकाशक की सामग्री-प्रबंधन प्रणाली से जोड़ता है और प्रति सप्ताह नया शब्दभंडार खींचता है। 5,000-इकाई स्कूल कार्यक्रम आमतौर पर प्रति ग्रेड प्रति सेमेस्टर एक .bookpack के साथ तैनात होता है, जो K-5 परिनियोजन के लिए 10 bookpack है। प्रत्येक bookpack 380 MB-1.4 GB है और USB-C स्टिक या Wi-Fi डाउनलोड के रूप में वितरित किया जाता है।
13. अनुकूली शिक्षण डेटा का गोपनीयता आवरण
अनुकूली शिक्षण टेलीमेट्री LLM ऑडियो पथ के समान क्षेत्रीय ओवरले द्वारा शासित है। EU/GDPR-K, US/COPPA, China/PIPL, Brazil/LGPD, Korea/PIPA और Singapore/PDPA सभी लागू होते हैं। OEM पोर्टल डेटा को डिफ़ॉल्ट रूप से 18 महीने तक संग्रहीत करता है, AI Act tier-2 परिनियोजन के लिए 7-वर्ष का विस्तार उपलब्ध है। पोर्टल माता-पिता डेटा-निर्यात अनुरोध का समर्थन करता है, जो प्रति-बाल राज्य वेक्टर और प्रति-सत्र टेलीमेट्री का एक ज़िप्ड बंडल लौटाता है। माता-पिता डेटा-हटाने का अनुरोध 14 दिनों के भीतर प्रति-बाल विभाजन को खाली कर देता है। हमने एक OEM शासन पैक भेजा है जिसमें गोपनीयता सूचना, माता-पिता सहमति-स्क्रीन प्रवाह, क्षेत्रीय डेटा-रेज़िडेंसी मानचित्र और प्रति-क्षेत्र उप-प्रोसेसर अनुबंध सूची शामिल है। अनुबंध सूची वही है जिसका रीडिंग पेन AI एकीकरण रोडमैप.
में संदर्भ दिया गया है
| प्रोजेक्ट चरण | अवधि | डिलीवरेबल |
|---|---|---|
| खोज | 2 सप्ताह | RFP अंतर विश्लेषण, कंटेंट ऑडिट |
| एल्गोरिदम ट्यूनिंग | 4 सप्ताह | करिकुलम ग्राफ इम्पोर्ट, BKT फिट, कस्टम बेंचमार्क रन |
| टेलीमेट्री इंटीग्रेशन | 3 सप्ताह | OEM पोर्टल, पैरेंट/टीचर डैशबोर्ड |
| बीटा डिप्लॉयमेंट | 4 सप्ताह | 50 पेन, 5 क्लासरूम, KPI रजिस्टर |
| पूर्ण उत्पादन | 6 सप्ताह | कंटेनर बिल्ड, AQL II स्वीकृति |
| कुल समय-सीमा | 19 सप्ताह | OEM के लिए 5,000-यूनिट न्यूनतम |
15. संदर्भ कॉल-आउट और निर्णय सारांश
निर्णय सारांश छोटा है। अनुकूली लर्निंग के लिए क्लाउड एनालिटिक्स के वैकल्पिक विकल्प के साथ L5 चुनें; बजट पर अनुकूली लर्निंग के लिए K7 या Q6 चुनें; द्विभाषी प्रोग्राम के लिए KF1 चुनें। अनुकूली लर्निंग के लिए B1, B2, F8 और P2 से बचें क्योंकि इनमें NPU नहीं है। RFQ में स्वीकृति मानदंड के रूप में PenLitEval बैज का उपयोग करें। एल्गोरिदमिक निर्णय को ओईएम रीडिंग पेन प्रोग्राम और व्यापक श्रेणी के लिए रीडिंग पेन एआई एकीकरण रोडमैप के साथ जोड़ें। प्रकाशकों के लिए प्रवेश बिंदु ओडीएम रीडिंग पेन है, जिसमें कंटेंट-पैक टूलिंग शामिल है।
संबंधित पठन
- रीडिंग पेन एआई एकीकरण रोडमैप 2024-2026
- रीडिंग पेन ऑफलाइन टीटीएस बनाम क्लाउड एपीआई का व्यापार-निर्णय
- रीडिंग पेन में एलएलएम का डिवाइस-परिनियोजन
- रीडिंग पेन फर्मवेयर आर्किटेक्चर की विस्तृत व्याख्या
- प्रारंभिक बाल्यावस्था साक्षरता में रीडिंग पेन का अनुप्रयोग
- प्राथमिक कक्षा में रीडिंग पेन का अनुप्रयोग
- K7 रीडिंग पेन विशिष्टता मार्गदर्शिका
- रीडिंग पेन प्राइवेट लेबल प्रारंभिक मार्गदर्शिका