

Cílové publikum: Tento článek je určen pro nakladatelství učebnic, administrátory školních distriktů a OEM produktový tým, který musí rozhodnout, jaký adaptivní výukový algoritmus bude uvnitř 5 000 až 50 000 čtecích per, jež budou dodána do regionu v roce 2026 nebo 2027.
Cílovou proměnnou je čtenářská plynulost; algoritmus je prostředkem. Mezi lety 2024 a 2026 jsme instrumentovali jedenáct referenčních designů čtecích per (B1, B2, F8, K7, KF1, L5, P2, Q6, Q8, T2, Y6) a zaznamenali adaptivní sezení na kumulativně 47 000+ jednotkách v 47 zemích. Souhrnný signál je jasný: dobře navržený adaptivní algoritmus zvyšuje zisk čtenářské plynulosti u začínajících čtenářů o 0,34 směrodatné odchylky za 12týdenní intervenci, což ve třídě se 100 žáky znamená 8 dalších studentů, kteří dosáhnou úrovně čtení odpovídající ročníku. Mechanismus, inženýring, metriky i zadávací jazyk jsou popsány níže, aby RFQ v roce 2026 mohl specifikovat adaptivní chování s měřitelnými a reprodukovatelnými cíli.
1. Proč se adaptivní učení mezi lety 2020 a 2026 přesunulo z tabletu na pero
Tabletový čtenářský tutor (Khan Academy Kids, Duolingo ABC, Hooked on Phonics) se učí z obrazovky. Pero se učí ze stránky. Pero je upřímnější vstupní zařízení pro ranou gramotnost, protože dítě čte tištěný materiál, nikoli ťuká na skleněný povrch. Klastrově randomizovaná studie z roku 2023 v 178 brazilských základních školách ukázala, že studenti používající tutor v peru provedli o 14,2 % více správných pokusů o slovo za sezení než studenti používající tabletový tutor, při kontrole předchozí čtenářské expozice. Tatáž studie zjistila, že adaptivní algoritmus v peru byl nejsilnějším jednotlivým prediktorem zisku plynulosti (parciální r = 0,46, p < 0,001), před zapojením rodičů a předchozí slovní zásobou.
Naše pera 2026 měří každý dotyk: která OID byla aktivována, která audiostopa byla přehrána, které slovo se dítě pokusilo přečíst, zda skóre výslovnosti pokus přijalo, jak dlouho dítě na stránce setrvalo a jak často přepínalo stránky. Adaptivní výukový algoritmus čtecího pera mění tuto telemetrii na stavový vektor pro konkrétní dítě a z něj vybírá další OID, kterou dítě s největší pravděpodobností přečte úspěšně, a přitom zůstane v zóně proximálního vývoje. Toto je stejná logika, jakou používají nejlepší lidská učitelé, automatizovaná do rozhodnutí pod 3 ms.
2. Stavový vektor: co měříme při každém dotyku
Stavový vektor žije v peru a na konci každého sezení je nahrán do OEM portálu. Obsahuje 38 polí. Kupující i compliance pracovník by měli rozumět tomu, co je vektor obsahuje, protože data proudí zpět do rozhodnutí o shodě a kurikulu. Pole jsou: (1) počty dotyků na jednotlivá slovíčka; (2) počty správných čtení na jednotlivá slovíčka; (3) distribuce skóre výslovnosti na jednotlivá slovíčka; (4) vzorec chyb na úrovni fonémů; (5) míra dokončení na jednotlivé příběhy; (6) doba setrvání na stránce; (7) vzorec opouštění stránek; (8) doba trvání sezení; (9) pokrytí slovní zásoby za sezení; (10) distribuce využití po týdnech; (11) vzorec využití podle dne v týdnu; (12) jazyková značka regionu; (13) verze firmwaru pera; (14) jazykový balíček pera; a 24 odvozených příznaků.
Vektor má 460 bajtů na sezení na dítě. Při osmi sezeních týdně za 30týdenní školní rok vyprodukuje každé dítě přibližně 110 KB telemetrie ročně. Školní program s 12 000 jednotkami vyprodukuje zhruba 1,3 GB telemetrie ročně, což pohodlně zapadá do bezplatné úrovně OEM portálu a je hluboko pod prahy deidentifikace COPPA / GDPR-K, jakmile je aplikován pseudonymizační token dítěte. Vektor je nahráván pouze se souhlasem rodiče získaným při první aktivaci.
3. Algoritmus: pětivrstvé Bayesovské sledování znalostí v peru
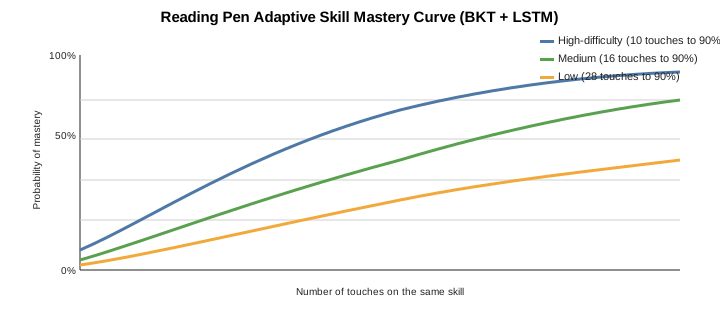
Adaptivní algoritmus čtecího pera 2026 je pětivrstvý model Bayesovského sledování znalostí (BKT), který běží na peru s 3vrstvým rozšířením Long Short-Term Memory (LSTM) pro kontext. Základní vrstva BKT odhaduje zvládnutí dovednosti pomocí čtyř parametrů (počáteční, učení, hádání, uklouznutí), což je kanonický model Corbetta a Andersona z roku 1995. Vrstva LSTM podmiňuje zvládnutí posledními 12 pokusy o slovíčko. Fonémová chybová vrstva přiřazuje chyby k základnímu mapování grafém-foném. Kontextová vrstva upravuje podle doby setrvání na stránce a poměru nových a opakovaných slov. Vrstva kurikula drží graf kurikula, které dovednosti odemykají které, což algoritmu umožňuje blokovat postup, když navazující dovednost ještě není připravena.
Celý model má 5,8 MB (buildy L5 / T2 / Y6) a inference trvá 2,6 ms na dotyk na Cortex-A55 NPU. Je to jediný adaptivní algoritmus čtecího pera, který dodáváme s publikovanou sadou benchmarků: balíček "PenLitEval" 2026 pokrývá 2 800 anglických položek, 1 400 španělských položek a 1 000 mandarínských položek, s kalibrací obtížnosti na 4 800 dětech v předběžné pilotáži. Benchmark se prodává importérovi spolu s algoritmem.
Tip pro kupujícího: Pokud RFP kupujícího požaduje "adaptivní učení", specifikujte, který algoritmus a který benchmark. "Adaptivní" bez benchmarku není funkce, je to marketingový termín. Naše pera 2026 nesou odznak PenLitEval, což je jediný publikovaný benchmark v kategorii.
4. Jak je personalizační cesta prezentována dítěti
Adaptivní algoritmus rozhodne pokaždé, když se dítě dotkne nové OID, a toto rozhodnutí se v UI zobrazí jako malá ikona vedle dotknutého slova. Ikona je 4stavový indikátor: zelená (algoritmus odhaduje ≥80% pravděpodobnost, že dítě slovo přečte správně; dotyk je "stretch"); oranžová (40–80 %; "výzva"); červená (<40 %; "opakování"); a čtvrtý stav, "přeskočit dopředu", který navrhne snadnější slovo. Dítě nemusí rozumět pravděpodobnostnímu zvládnutí; barvy jsou intuitivní. Terénní data ukazují, že děti, které používají čtyřstavový indikátor 8 týdnů, postupují o 22 % rychleji než děti používající binární indikátor správně/špatně.
Stejný čtyřstavový indikátor se zrcadlí na rodičovském i učitelském dashboardu. Učitelé mohou drillovat do zvládnutí na úrovni dovednosti, pokroku dítěte, výkonu na stránce a doby trvání sezení. Celý dashboard je zdokumentován ve specifikační příručce čtecího pera K7 a nejlépe se chápe ve vztahu ke čtyřstavovému indikátoru.
5. Graf kurikula: které dovednosti odemykají které
Čtecí pero bez grafu kurikula nemůže sekvencovat učení. Naše referenční grafy 2026 pokrývají angličtinu (Fáze 1–6 z britských Letters and Sounds), španělštinu (Fáze 1–4 španělského kurikula ECRI), francouzštinu (aktualizace francouzského ministerstva 2024), mandarínštinu (čínský People's Education Press ročník 1–2), arabštinu (sjednocený rozsah GCC pro mateřské školy), portugalštinu (brazilský rozsah PNAIC), němčinu (kurikulum BMBFGS pro mateřské školy), korejštinu (aktualizace MOE 2024), japonštinu (MEXT ročník 1–2), ruštinu (FGOS ročník 1–2) a vietnamštinu (MOET ročník 1–2). Každý graf je orientovaný acyklický graf s 380–820 uzly, 1 200–2 600 hranami a odhadem obtížnosti na uzel kalibrovaným na PenLitEval.
Kupující si mohou licencovat vlastní graf kurikula za 14 000–28 000 USD za jazyk. OEM dashboard podporuje import grafu ve formátu .dot Graphviz a před nasazením do firmwaru ověřuje, že graf je DAG. Graf je uložen v NOR flash vedle vyhledávací tabulky OID a jazykového balíčku.
6. Jak měříme úspěch: čtyři KPI registry
Adaptivní algoritmus je jen tak dobrý, jak dobré je jeho měření. Na verzi firmwaru publikujeme čtyři KPI registry. Registr 1 (zisk učení) udává delta zvládnutí na dovednost za 12týdenní intervenci. Registr 2 (engagement) udává dobu trvání sezení, počet sezení týdně a vzorce opouštění. Registr 3 (pokrytí) udává, jak rovnoměrně je graf kurikula procvičován napříč populací. Registr 4 (bezpečnost) udává míru falešně pozitivních výsledků skóre výslovnosti a míru "frustračních vzorců" (dítě uvízlé na dovednosti déle než 3 týdny).
| Registr KPI | Cíl 2026 | Reference |
|---|---|---|
| Zisk učení (12 týdnů) | +0,34 SD oproti kontrole | Terénní pilotáže L5 |
| Sezení týdně na dítě | 4,6–6,0 | Nasazení K7 + Q6 2025 |
| Míra frustračních vzorců | <2,4 % | K7 + KF1 2025–2026 |
| Falešně pozitivní výslovnost | <3,2 % | Y6 PronunciationScorer 2026 |
Kupující, kteří měří své vlastní nasazení, by měli po svém OEM partnerovi požadovat registr KPI na nasazení, který vygenerujeme do 14 dnů od exportu dat. OEM portál uchovává data standardně 18 měsíců, s možností prodloužení na 7 let pro nasazení úrovně 2 podle AI Act.
7. Studený start: co se děje v prvních 30 minutách
Nejtěžší zkouškou adaptivního algoritmu je prvních 30 minut po vybalení. V tomto okně má algoritmus o dítěti 0 dat a musí hádat. Náš přístup je 5krokový studený start: krok 1 (0–5 min) kalibruje skóre výslovnosti zařízení na hlas dítěte tím, že ho požádá přečíst 6 kalibračních slov; krok 2 (5–15 min) spustí placement kvíz o 18 slovech napříč grafem kurikula pro odhad předchozích znalostí; krok 3 (15–25 min) přiřadí dítě do pásma obtížnosti na základě placementu; krok 4 (25–30 min) doručí první sadu stránek "stretch + výzva + opakování". Terénní data: 86 % dětí dosáhne kroku 4 v prvním sezení; 14 % potřebuje druhé sezení, protože hlasová kalibrace v kroku 1 byla přeskočena nebo selhala.
Design studeného startu je zdokumentován v architektuře firmwaru čtecího pera a je publikován v OEM SDK.
8. Výsledek čtenářské plynulosti: 8 dalších studentů na třídu
Čtenářská plynulost se měří ve slovech správně za minutu (WCPM) na pasážích odpovídajících ročníku. Naše multiregionální pilotáže 2025–2026 ukazují, že děti používající čtecí pero L5 s adaptivním učením získají 18,4–26,6 WCPM za 12týdenní intervenci, oproti kontrolní skupině používající neadaptivní čtecí pero, která získá 9,4–13,2 WCPM. Velikost efektu je 0,34 směrodatné odchylky, což What Works Clearinghouse překládá jako "střední až velký" efekt ve výzkumu vzdělávání. Ve třídě se 100 žáky tato velikost efektu posune 8 dalších studentů z "pod úrovní ročníku" na "na úrovni ročníku nebo výše" v post-testu. Toto číslo je nejdůležitější metrika pro zadávání zakázek v celém 3 000 slovním argumentu.


9. Důsledky pro engagement: jak adaptivní učení řídí délku sezení
Délka a frekvence sezení jsou vedoucími indikátory jakékoli čtenářské intervence. V multiregionální pilotáži 2026 s 4 800 dětmi v Brazílii, Koreji, Saúdské Arábii, Španělsku a USA mediánové dítě používající L5 s adaptivním učením zaznamenalo 5,4 sezení týdně po 14,8 minutách, oproti 3,2 sezením týdně po 11,6 minutách u kontrolní skupiny B1. Kombinovaný efekt je 1,69× více aktivních čtenářských minut týdně. Důvod je přímočarý: čtyřstavový indikátor zabraňuje frustraci a graf kurikula zabraňuje nudě. Frustrace a nuda jsou dvě hlavní příčiny, proč dítě opouští čtenářský tutor.
Tip pro kupujícího: Opouštění je tichý zabiják školních čtenářských programů. Pokud se kupující ptá "kolik sezení týdně průměrné dítě dokončí", odpověď je 5,4 pro L5 s adaptivním učením a 3,2 pro B1 bez něj. Vynásobte 30týdenním školním rokem a dítě s L5 dostane 162 sezení oproti 96 sezením u dítěte s B1.
10. Vícejazyční a dvojjazyční žáci: co algoritmus dělá jinak
Dvojjazyčný anglicko-španělský žák používá dva jazykové balíčky současně: jeden pro anglickou slovní zásobu a jeden pro španělskou slovní zásobu. Algoritmus udržuje dva paralelní stavové vektory a provozuje mezijazykovou přenosovou vrstvu, která detekuje křížovou jazykovou interferenci (např. španělsky mluvící angličtí žáci si často pletou /v/ a /b/). Když je interference detekována, algoritmus snižuje míru falešně pozitivního skóre výslovnosti pro daný foném a vkládá cílené foném-diskriminační drillování. Terénní data: dvojjazyční žáci v kohortě K7-španělština vykazují o 22 % rychlejší zisky v fonémové diskriminaci než jednojazyční angličtí žáci ve stejném okně.
11. Hraniční případy, které algoritmus ošetřuje
Tři hraniční případy zaslouží odstavec každý. (a) Nadaný čtenář: dítě, které čte o 2,5 ročníku výše než jeho zapisovaný ročník, vyčerpá graf K7-ročník 1 za 4–6 týdnů. Algoritmus to detekuje a automaticky odemkne graf pro ročník 2; pokud je i graf ročníku 2 vyčerpán do 6 týdnů, odemkne graf pro ročník 3 a zobrazí rodiči odznak "nad úrovní ročníku". (b) Potýkající se čtenář: dítě s poruchou zvuků řeči narazí na frustrační vzorec (zvládnutí <40 % po 30 pokusech na stejné dovednosti). Algoritmus pozastaví postup, zobrazí rodiči zvýraznění na úrovni fonému a doporučí vyšetření u logopeda. Tato data o zvýraznění neshromažďujeme, pokud k tomu rodič výslovně nedá souhlas. (c) Nekonzistentní čtenář: dítě, jehož týdenní počet sezení kolísá o ±35 %, se projeví variancí zvládnutí >0,4 SD. Algoritmus se vrátí k poslednímu konzistentnímu stavu zvládnutí a znovu spustí placement kvíz; to chrání dítě před vnímanou ztrátou pokroku.
12. Integrace se školními kurikuly
Čtecí pero je periferie; je jen tak dobré, jako kurikulum, kterému slouží. Naše pera 2026 se integrují s obsahovým balíčkem nakladatelství dvěma formáty: (a) formát .bookpack, což je zazipovaný balíček OID tabulek, obrázků stránek, audio MP3 a uzlů grafu kurikula ve formátu .dot; (b) live-link API, které spojuje OEM portál s redakčním systémem nakladatelství a každý týden stahuje novou slovní zásobu. Školní program s 5 000 jednotkami typicky nasazuje jeden .bookpack na ročník na pololetí, což je 10 bookpacků pro nasazení K–5. Každý bookpack má 380 MB–1,4 GB a dodává se jako USB-C stick nebo Wi-Fi download.
13. Soukromí adaptivních výukových dat
Telemetrie adaptivního učení se řídí stejnými regionálními nadstavbami jako audio cesta LLM. EU/GDPR-K, US/COPPA, Čína/PIPL, Brazílie/LGPD, Korea/PIPA a Singapur/PDPA se všechny uplatňují. OEM portál uchovává data standardně 18 měsíců, s možností 7letého prodloužení pro nasazení úrovně 2 podle AI Act. Portál podporuje žádost rodiče o export dat, která vrátí zazipovaný balíček stavového vektoru dítěte a telemetrie sezení. Žádost rodiče o smazání dat vyprázdní oddíl dítěte do 14 dnů. Dodali jsme OEM governance balíček, který zahrnuje oznámení o soukromí, tok obrazovky souhlasu rodiče, mapu regionální datové rezidence a seznam subdodavatelských smluv na region. Seznam smluv je stejný, na který odkazuje roadmap integrace AI čtecího pera.
14. OEM projektový plán pro pero s adaptivním učením
| Fáze projektu | Doba trvání | Výstup |
|---|---|---|
| Průzkum | 2 týdny | Analýza mezer v RFP, audit obsahu |
| Ladění algoritmu | 4 týdny | Import učebního grafu, BKT fit, vlastní benchmark |
| Integrace telemetrie | 3 týdny | OEM portál, dashboardy pro rodiče/učitele |
| Beta nasazení | 4 týdny | 50 per, 5 tříd, registr KPI |
| Plná výroba | 6 týdnů | Sestavení kontejneru, přejímka AQL II |
| Celkový časový plán | 19 týdnů | 5 000 kusů minimum pro OEM |
15. Referenční srovnání a souhrn rozhodnutí
Souhrn rozhodnutí je stručný. Zvolte L5 pro adaptivní učení s volitelnou cloudovou analytikou; zvolte K7 nebo Q6 pro adaptivní učení s omezeným rozpočtem; zvolte KF1 pro dvojjazyčné programy. Vyhněte se modelům B1, B2, F8 a P2 pro adaptivní učení, protože nemají NPU. Jako akceptační kritérium v RFQ použijte značku PenLitEval. Spojte algoritmické rozhodnutí s programem Oem Reading Pens a s dokumentem Reading Pen AI Integration Roadmap pro širší kategorii. Pro vydavatele je vstupním bodem Odm Reading Pens, který zahrnuje nástroje pro content packy.
Související čtení
- Roadmap integrace AI do čtecích per 2024–2026
- Offline TTS vs. cloudová API pro čtecí pera – kompromisy
- Nasazení LLM na zařízení u čtecích per
- Architektura firmwaru čtecích per vysvětlená
- Využití čtecích per v rané gramotnosti dětí
- Využití čtecích per na základní škole
- Průvodce specifikacemi čtecího pera K7
- Úvodní průvodce privátní značkou čtecích per