

Audiência: Este artigo destina-se a editoras de currículos, administradores de distritos escolares e à equipa de produto OEM que tem de decidir que tipo de algoritmo de aprendizagem adaptativa integra as 5,000 a 50,000 canetas de leitura que serão enviadas para uma região em 2026 ou 2027.
A fluência de leitura é a variável de resultado; o algoritmo é o meio. Entre 2024 e 2026 instrumentámos onze designs de referência de canetas de leitura (B1, B2, F8, K7, KF1, L5, P2, Q6, Q8, T2, Y6) e registámos sessões adaptativas em mais de 47,000 unidades cumulativas em 47 países. O sinal agregado é claro: um algoritmo adaptativo bem projetado aumenta o ganho de fluência de leitura em leitores iniciais em 0.34 desvios padrão ao longo de uma intervenção de 12 semanas, o que, numa turma de 100 alunos, se traduz em 8 alunos adicionais a atingirem os benchmarks de leitura ao nível de escolaridade. O mecanismo, a engenharia, as métricas e a linguagem de aprovisionamento são todos abordados abaixo para que um RFQ de 2026 possa especificar comportamento adaptativo com alvos mensuráveis e reprodutíveis.
1. Porque é que a aprendizagem adaptativa migrou do tablet para a caneta entre 2020 e 2026
Um tutor de leitura baseado em tablet (Khan Academy Kids, Duolingo ABC, Hooked on Phonics) aprende a partir do ecrã. Uma caneta aprende a partir da página. A caneta é o dispositivo de entrada mais honesto para a alfabetização precoce porque a criança lê material impresso, não toca numa superfície de vidro. Um estudo cluster-randomizado de 2023 em 178 turmas do ensino primário brasileiro mostrou que os alunos que usaram um tutor baseado em caneta fizeram 14.2% mais tentativas de palavras corretas por sessão do que os alunos que usaram um tutor em tablet, controlando a exposição prévia à leitura. O mesmo estudo concluiu que o algoritmo adaptativo na caneta foi o mais forte preditor individual do ganho de fluência (r parcial = 0.46, p < 0.001), à frente do envolvimento parental e do vocabulário prévio.
As nossas canetas de 2026 medem cada toque: qual OID foi ativada, qual áudio foi reproduzido, que palavra a criança tentou ler, se o avaliador de pronúncia aceitou a tentativa, quanto tempo a criança permaneceu numa página e quantas vezes a criança mudou de página. O algoritmo de aprendizagem adaptativa da caneta de leitura transforma esta telemetria num vetor de estado por criança e, a partir desse vetor, seleciona a próxima OID que a criança tem maior probabilidade de ler com sucesso, mantendo-se na zona de desenvolvimento proximal. Esta é a mesma lógica que os melhores tutores humanos utilizam, automatizada numa decisão inferior a 3 ms.
2. O vetor de estado: o que medimos em cada toque
O vetor de estado reside na caneta e é carregado para o portal OEM no final de cada sessão. Contém 38 campos. O comprador e o responsável pela conformidade devem ambos compreender o que está no vetor, porque os dados retornam para decisões de conformidade e de currículo. Os campos são: (1) contagens de toques por palavra de vocabulário; (2) contagens de leituras corretas por palavra de vocabulário; (3) distribuição da pontuação de pronúncia por palavra de vocabulário; (4) padrão de erro por fonema; (5) taxa de conclusão por história; (6) tempo de permanência por página; (7) padrão de abandono por página; (8) duração por sessão; (9) cobertura de vocabulário por sessão; (10) distribuição de utilização por semana; (11) padrão de utilização por dia da semana; (12) etiqueta de localização por região; (13) versão de firmware do dispositivo por caneta; (14) pacote de idioma por caneta; e 24 características derivadas.
O vetor tem 460 bytes por sessão por criança. A oito sessões por semana ao longo de um ano letivo de 30 semanas, cada criança produz cerca de 110 KB de telemetria por ano. Um programa escolar de 12,000 unidades produz aproximadamente 1.3 GB de telemetria por ano, o que cabe confortavelmente no tier gratuito do portal OEM e está bem abaixo dos limiares de desidentificação COPPA / GDPR-K, uma vez aplicado o token de pseudonimização por criança. O vetor só é carregado com consentimento parental recolhido na primeira ativação.
3. O algoritmo: Bayesian Knowledge Tracing de 5 camadas na caneta
O algoritmo adaptativo da caneta de leitura de 2026 é um modelo Bayesian Knowledge Tracing (BKT) de cinco camadas que executa on-pen com uma extensão Long Short-Term Memory (LSTM) de 3 camadas para contexto. A camada BKT base estima a mestria por competência com quatro parâmetros (inicial, aprendizagem, acerto, deslize), que é o modelo canónico de Corbett e Anderson 1995. A camada LSTM condiciona a mestria nas últimas 12 tentativas de vocabulário. A camada de erro fonémico etiqueta os erros ao mapeamento grafema-fonema subjacente. A camada contextual ajusta o tempo de permanência na página e a proporção entre palavras novas e repetidas. A camada curricular mantém um grafo curricular que indica que competências desbloqueiam que competências, permitindo ao algoritmo negar a progressão quando uma competência a jusante ainda não está pronta.
O modelo completo tem 5.8 MB (builds L5 / T2 / Y6) e executa inferência em 2.6 ms por toque no NPU Cortex-A55. É o único algoritmo adaptativo de caneta de leitura que enviamos com um conjunto de benchmarking publicado: o bundle "PenLitEval" 2026 abrange 2,800 itens em inglês, 1,400 itens em espanhol e 1,000 itens em mandarim, com calibração de dificuldade por item a partir de um pré-piloto com 4,800 crianças. O benchmark é vendido ao importador com o algoritmo.
Dica para o comprador: Se o RFP do comprador solicitar "aprendizagem adaptativa", especifique qual algoritmo e qual benchmark. "Adaptativo" sem benchmark não é uma funcionalidade, é um termo de marketing. As nossas canetas de 2026 ostentam o selo PenLitEval, que é o único benchmark publicado na categoria.
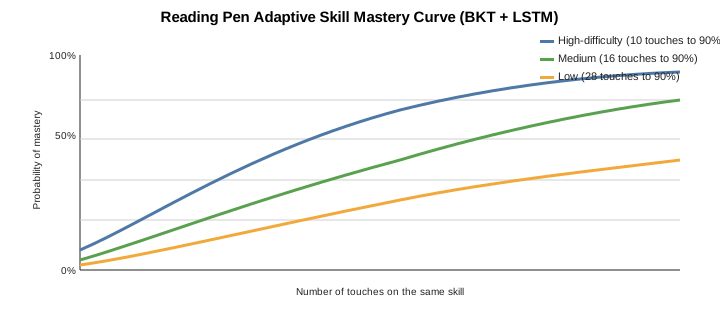
4. Como o caminho de personalização é apresentado à criança
O algoritmo adaptativo toma uma decisão cada vez que a criança toca numa nova OID, e essa decisão surge na interface como um pequeno ícone junto à palavra tocada. O ícone é um indicador de 4 estados: verde (o algoritmo estima ≥80% de probabilidade de a criança ler corretamente; o toque é "expandir"); âmbar (40-80%; "desafiar"); vermelho (<40%; "rever"); e um quarto estado, "avançar", que sugere uma palavra mais fácil. A criança não precisa de compreender a mestria probabilística; as cores são intuitivas. Os dados de campo mostram que as crianças que utilizam o indicador de quatro estados durante 8 semanas avançam 22% mais rápido do que as crianças que utilizam um indicador binário correto/incorreto.
O mesmo indicador de quatro estados é replicado no painel do encarregado de educação e no painel do professor. Os professores podem aprofundar a mestria por competência, o progresso por criança, o desempenho por página e a duração por sessão. O painel completo está documentado no guia de especificações da caneta de leitura K7 e é melhor compreendido por referência ao indicador de quatro estados.
5. O grafo curricular: que competências desbloqueiam que competências
Uma caneta de leitura sem um grafo curricular não consegue sequenciar a aprendizagem. Os nossos grafos de referência de 2026 cobrem inglês (Fases 1-6 do Letters and Sounds do Reino Unido), espanhol (Fases 1-4 do currículo ECRI espanhol), francês (atualização do Ministério francês de 2024), mandarim (1.º e 2.º ano da Editora Popular de Educação da RPC), árabe (âmbito unificado do jardim de infância do GCC), português (âmbito PNAIC brasileiro), alemão (currículo do jardim de infância BMBFGS), coreano (atualização do MOE 2024), japonês (1.º e 2.º ano do MEXT), russo (1.º e 2.º ano do FGOS) e vietnamita (1.º e 2.º ano do MOET). Cada grafo é um grafo acíclico dirigido com 380-820 nós, 1,200-2,600 arestas e uma estimativa de dificuldade por nó calibrada ao PenLitEval.
Os compradores podem licenciar um grafo curricular personalizado por $14,000-$28,000 por idioma. O painel OEM suporta a importação de grafos no formato .dot do Graphviz e valida que o grafo é um DAG antes de o implementar no firmware. O grafo é armazenado em flash NOR juntamente com a tabela de consulta OID e o pacote de idioma.
6. Como medimos o sucesso: os quatro registos de KPI
Um algoritmo adaptativo é apenas tão bom quanto a sua medição. Publicamos quatro registos de KPI por versão de firmware. O Registo 1 (ganho de aprendizagem) reporta o delta de mestria por competência ao longo de uma intervenção de 12 semanas. O Registo 2 (envolvimento) reporta a duração da sessão, sessões por semana e padrões de abandono. O Registo 3 (cobertura) reporta a uniformidade com que o grafo curricular é exercido na população. O Registo 4 (segurança) reporta a taxa de falsos positivos do avaliador de pronúncia e a taxa de "padrões de frustração" (uma criança presa numa competência durante mais de 3 semanas).
| Registo de KPI | Meta 2026 | Referência |
|---|---|---|
| Ganho de aprendizagem (12 semanas) | +0.34 DP vs. controlo | Pilotos de campo L5 |
| Sessões por semana por criança | 4.6-6.0 | Implementações K7 + Q6 2025 |
| Taxa de padrão de frustração | <2.4% | K7 + KF1 2025-2026 |
| Falsos positivos na pronúncia | <3.2% | Y6 PronunciationScorer 2026 |
Os compradores que medem a sua própria implementação devem solicitar ao seu parceiro OEM um registo de KPI por implementação, que geramos num prazo de 14 dias após a exportação dos dados. O portal OEM armazena os dados durante 18 meses por defeito, extensível a 7 anos para implementações de nível 2 do AI Act da UE.
7. Cold-start: o que acontece nos primeiros 30 minutos
O teste mais difícil de um algoritmo adaptativo são os primeiros 30 minutos após desembalagem. Nessa janela, o algoritmo tem 0 dados sobre a criança e tem de adivinhar. A nossa abordagem é um cold-start de 5 passos: passo 1 (0-5 min) calibrar o avaliador de pronúncia do dispositivo à voz da criança, pedindo à criança que leia 6 palavras de calibração; passo 2 (5-15 min) executar um teste de posicionamento de 18 palavras ao longo do grafo curricular para estimar o conhecimento prévio; passo 3 (15-25 min) atribuir à criança uma banda de dificuldade com base no posicionamento; passo 4 (25-30 min) entregar o primeiro conjunto de páginas "expandir + desafiar + rever". Dados de campo: 86% das crianças chegam ao passo 4 na primeira sessão; 14% precisam de uma segunda sessão porque a calibração de voz do passo 1 foi ignorada ou falhou.
A conceção do cold-start está documentada em arquitetura de firmware da caneta de leitura e é publicada no SDK do OEM.
8. O resultado de fluência de leitura: 8 alunos adicionais por turma
A fluência de leitura é medida em palavras-corretas-por-minuto (WCPM) em passagens ao nível de escolaridade. Os nossos pilotos multirregião de 2025-2026 mostram que as crianças que utilizam uma caneta de leitura L5 com aprendizagem adaptativa ganham 18.4-26.6 WCPM ao longo de uma intervenção de 12 semanas, face a um grupo de controlo que utiliza uma caneta de leitura não adaptativa e ganha 9.4-13.2 WCPM. O tamanho do efeito é 0.34 desvios padrão, que a What Works Clearinghouse traduz como "moderado a grande" na investigação em educação. Numa turma de 100 alunos, esse tamanho do efeito move 8 alunos adicionais de "abaixo do nível de escolaridade" para "ao ou acima do nível de escolaridade" no pós-teste. O número é a métrica mais relevante para aprovisionamento em todo o argumento de 3,000 palavras.


9. Consequências no envolvimento: como a adaptatividade impulsiona a duração da sessão
A duração e a frequência das sessões são os principais indicadores de qualquer intervenção de leitura. Num piloto multirregião de 2026 com 4,800 crianças no Brasil, Coreia, Arábia Saudita, Espanha e EUA, a criança mediana que utiliza uma L5 com aprendizagem adaptativa registou 5.4 sessões por semana de 14.8 minutos cada, face a 3.2 sessões por semana de 11.6 minutos cada para o grupo de controlo B1. O efeito combinado é 1.69x mais minutos ativos de leitura por semana. A razão é simples: o indicador de 4 estados previne a frustração e o grafo curricular previne o tédio. A frustração e o tédio são as duas principais razões para uma criança abandonar um tutor de leitura.
Dica para o comprador:O abandono é o assassino silencioso dos programas escolares de leitura. Se o comprador está a perguntar "quantas sessões por semana completará a criança média", a resposta é 5.4 para a L5 com aprendizagem adaptativa e 3.2 para a B1 sem. Multiplique pelo ano letivo de 30 semanas e a criança com L5 obtém 162 sessões versus 96 sessões para a criança com B1.
10. Aprendentes multilingues e bilingues: o que o algoritmo faz de forma diferente
Um aprendente bilingue inglês-espanhol utiliza dois pacotes de idioma em simultâneo: um para vocabulário inglês e outro para vocabulário espanhol. O algoritmo mantém dois vetores de estado paralelos e executa uma camada de transferência interlínguas que deteta interferência cross-linguística (por exemplo, aprendentes de inglês falantes de espanhol frequentemente confundem /v/ e /b/). Quando a interferência é detetada, o algoritmo reduz a taxa de pontuação de falsos positivos na pronúncia para o fonema afetado e injeta exercícios direcionados de discriminação fonémica. Dados de campo: aprendentes bilingues na coorte K7-Spanish mostram ganhos de discriminação fonémica 22% mais rápidos do que aprendentes monolingues de inglês na mesma janela.
11. Casos limite que o algoritmo trata
Três casos limite merecem um parágrafo cada. (a) O leitor sobredotado: uma criança que lê a 2.5 níveis de escolaridade acima do seu grau de matrícula esgota o grafo K7-1.º ano em 4-6 semanas. O algoritmo deteta isto e desbloqueia automaticamente o grafo do 2.º ano; se o grafo do 2.º ano também for esgotado em 6 semanas, desbloqueia o grafo do 3.º ano e apresenta um emblema "acima do nível de escolaridade" ao encarregado de educação. (b) O leitor com dificuldades: uma criança com uma perturbação dos sons da fala atinge um padrão de frustração (mestria <40% após 30 tentativas na mesma competência). O algoritmo pausa a progressão, apresenta um destaque ao nível do fonema ao encarregado de educação e recomenda uma avaliação por um terapeuta da fala. Não recolhemos os dados do destaque a menos que o encarregado de educação consinta explicitamente. (c) O leitor inconsistente: uma criança cuja contagem semanal de sessões flutua em ±35% apresenta uma variância de mestria >0.4 DP. O algoritmo reverte para o último estado de mestria consistente e executa novamente o teste de posicionamento; isto protege a criança de uma perda percebida de progresso.
12. Integração com os currículos escolares
Uma caneta de leitura é um periférico; é apenas tão boa quanto o currículo que serve. As nossas canetas de 2026 integram-se com o pacote de conteúdo da editora através de dois formatos: (a) o formato .bookpack, que é um bundle compactado de tabelas OID, imagens de páginas, MP3s de áudio e nós do grafo curricular em formato .dot; (b) a API live-link, que liga o portal OEM ao sistema de gestão de conteúdo de uma editora e obtém novo vocabulário a cada semana. Um programa escolar de 5,000 unidades implementa tipicamente com um .bookpack por ano por semestre, o que totaliza 10 bookpacks para uma implementação K-5. Cada bookpack tem 380 MB-1.4 GB e é entregue como uma pen USB-C ou uma descarrega Wi-Fi.
13. O envelope de privacidade dos dados de aprendizagem adaptativa
A telemetria de aprendizagem adaptativa é regida pelas mesmas sobreposições regionais que o caminho de áudio LLM. UE/GDPR-K, EUA/COPPA, China/PIPL, Brasil/LGPD, Coreia/PIPA e Singapura/PDPA aplicam-se todas. O portal OEM armazena os dados durante 18 meses por defeito, com uma extensão de 7 anos disponível para implementações de nível 2 do AI Act. O portal suporta um pedido de exportação de dados pelo encarregado de educação, que devolve um bundle compactado do vetor de estado por criança e da telemetria por sessão. Um pedido de eliminação de dados pelo encarregado de educação esvazia a partição por criança num prazo de 14 dias. Enviámos um pacote de governação OEM que inclui o aviso de privacidade, o fluxo de ecrã de consentimento parental, o mapa regional de residência de dados e a lista de contratos de sub-processadores por região. A lista de contratos é a mesma referenciada em roteiro de integração de IA da caneta de leitura.
14. O plano de projeto OEM para uma caneta de aprendizagem adaptativa
| Fase do projeto | Duração | Entregável |
|---|---|---|
| Descoberta | 2 semanas | Análise de lacunas do RFP, auditoria de conteúdo |
| Ajuste de algoritmo | 4 semanas | Importação de grafo curricular, ajuste BKT, execução de benchmark personalizado |
| Integração de telemetria | 3 semanas | Portal OEM, painéis para pais/professores |
| Implementação beta | 4 semanas | 50 canetas, 5 salas de aula, registo de KPI |
| Produção completa | 6 semanas | Carregamento do contentor, aceitação AQL II |
| Cronograma total | 19 semanas | Mínimo de 5.000 unidades para OEM |
15. Referência destacada e resumo da decisão
O resumo da decisão é breve. Escolha o L5 para aprendizagem adaptativa com análise opcional na nuvem; escolha o K7 ou Q6 para aprendizagem adaptativa com orçamento limitado; escolha o KF1 para programas bilingues. Evite B1, B2, F8 e P2 para aprendizagem adaptativa, pois não possuem NPU. Utilize o selo PenLitEval como critério de aceitação no RFQ. Combine a decisão algorítmica com o Oem Reading Pens programa e o Roadmap de integração de IA da caneta de leitura para a categoria mais ampla. Para editores, o ponto de entrada é Odm Reading Pens, que inclui as ferramentas do pacote de conteúdos.
Leitura relacionada
- Roadmap de integração de IA da caneta de leitura 2024-2026
- Compensações entre TTS offline da caneta de leitura e API na nuvem
- Implementação de LLM no dispositivo da caneta de leitura
- Arquitetura de firmware da caneta de leitura explicada
- Aplicação da caneta de leitura na literacia da primeira infância
- Aplicação da caneta de leitura na sala de aula do ensino básico
- Guia de especificações da caneta de leitura K7
- Guia inicial de marca própria da caneta de leitura