

Målgruppe: Denne artikkelen er skrevet for læreplanforlag, skolekretsadministratorer og OEM-produktteamet som må avgjøre hvilken type adaptiv læringsalgoritme som skal sitte i de 5 000 til 50 000 lesepennene de skal sende til en region i 2026 eller 2027.
Leseflyt er utfallsvariabelen; algoritmen er midlet. Mellom 2024 og 2026 instrumenterte vi elleve referansedesign av lesepenner (B1, B2, F8, K7, KF1, L5, P2, Q6, Q8, T2, Y6) og loggførte adaptive økter på tvers av 47 000+ akkumulerte enheter i 47 land. Det samlede signalet er tydelig: en godt designet adaptiv algoritme øker fremgangen i leseflyt hos tidlige lesere med 0,34 standardavvik over et 12-ukers tiltak, noe som i en klasse på 100 elever tilsvarer 8 ekstra elever som når lesenivået for klassetrinnet. Mekanismen, teknologien, beregningene og innkjøpsspråket dekkes nedenfor, slik at en RFQ for 2026 kan spesifisere adaptiv atferd med målbare og reproduserbare mål.
1. Hvorfor adaptiv læring flyttet fra nettbrett til penn mellom 2020 og 2026
En nettbrettbasert leseveileder (Khan Academy Kids, Duolingo ABC, Hooked on Phonics) lærer fra skjermen. En penn lærer fra siden. Pennen er den mer ærlige inndataenheten for tidlig leseferdighet, fordi barnet leser trykt materiale, ikke trykker på en glassoverflate. En cluster-randomisert studie i 2023 i 178 brasilianske barneskoleklasser viste at elever som brukte en pennbasert veileder, gjorde 14,2 % flere riktige ordforsøk per økt enn elever som brukte en nettbrettveileder, kontrollert for tidligere leseeksponering. Samme studie fant at den adaptive algoritmen i pennen var den sterkeste enkeltstående prediktoren for fremgang i flyt (partial r = 0,46, p < 0,001), foran foreldreinvolvering og tidligere ordforråd.
Våre 2026-penner måler hvert trykk: hvilken OID som ble aktivert, hvilken lyd som ble spilt, hvilket ord barnet forsøkte å lese, om uttalescoreren godtok forsøket, hvor lenge barnet ble på en side, og hvor ofte barnet byttet side. Den adaptive læringsalgoritmen i lesepennen gjør denne telemetrien om til en tilstandsvektor per barn, og fra den vektoren velger den neste OID som barnet med størst sannsynlighet vil lese riktig, samtidig som det fortsatt er i den proksimale utviklingssonen. Dette er den samme logikken de beste menneskelige veilederne bruker, automatisert i en avgjørelse på under 3 ms.
2. Tilstandsvektoren: hva vi måler ved hvert trykk
Tilstandsvektoren ligger på pennen og lastes opp til OEM-portalen ved slutten av hver økt. Den inneholder 38 felt. Både kjøperen og compliance-ansvarlig bør forstå hva som er i vektoren, fordi dataene flyter tilbake til compliance- og læreplanbeslutninger. Feltene er: (1) antall trykk per vokabularord; (2) antall riktige avlesninger per vokabularord; (3) uttalescore-fordeling per vokabularord; (4) feilmønster per fonem; (5) fullføringsgrad per historie; (6) oppholdstid per side; (7) forlatelsesmønster per side; (8) varighet per økt; (9) vokabulerdekning per økt; (10) bruksfordeling per uke; (11) bruksmønster per ukedag; (12) lokalitetskode per region; (13) firmwareversjon per penn; (14) språkpakke per penn; og 24 avledede funksjoner.
Vektoren er 460 byte per økt per barn. Med åtte økter per uke over et 30-ukers skoleår produserer hvert barn omtrent 110 KB telemetri per år. Et skoleprogram på 12 000 enheter produserer rundt 1,3 GB telemetri per år, som komfortabelt passer innenfor OEM-portalens gratisnivå og er godt under de anonymiserte tersklene i COPPA / GDPR-K når pseudonymiseringstokenet per barn er brukt. Vektoren lastes bare opp med samtykke fra foreldre, innhentet ved første aktivering.
3. Algoritmen: 5-lags Bayesian Knowledge Tracing på pennen
Den adaptive algoritmen for 2026-lesepennen er en fem-lags Bayesian Knowledge Tracing-modell (BKT) som kjører på pennen med en 3-lags Long Short-Term Memory-utvidelse (LSTM) for kontekst. BKT-grunnlaget estimerer ferdighetsmestring per ferdighet med fire parametere (initial, læring, gjetning, glipp), som er den kanoniske modellen fra Corbett og Anderson 1995. LSTM-laget betinger mestring på de siste 12 vokabularforsøkene. Fonemfeillaget knytter feil til den underliggende grafem-fonem-kartleggingen. Kontekstlaget justerer for oppholdstid på siden og forholdet mellom nye og gjentatte ord. Læreplanlaget holder en læreplangraf over hvilke ferdigheter som låser opp hvilke, slik at algoritmen kan nekte progresjon når en nedstrøms ferdighet ennå ikke er klar.
Hele modellen er 5,8 MB (L5 / T2 / Y6-bygg) og kjører inferens på 2,6 ms per trykk på Cortex-A55 NPU. Det er den eneste adaptive algoritmen for lesepenner vi leverer med et publisert benchmarksett: 2026-bunten "PenLitEval" dekker 2 800 engelske elementer, 1 400 spanske elementer og 1 000 mandarin-elementer, med per-element vanskelighetskalibrering fra et 4 800-barns for-pilot. Benchmarket selges til importøren sammen med algoritmen.
Innkjøpstips: Hvis kjøperens RFP spør etter "adaptiv læring", spesifiser hvilken algoritme og hvilket benchmark. "Adaptiv" uten et benchmark er ikke en funksjon, det er et markedsføringsord. Våre 2026-penner bærer PenLitEval-merket, som er det eneste publiserte benchmarket i kategorien.
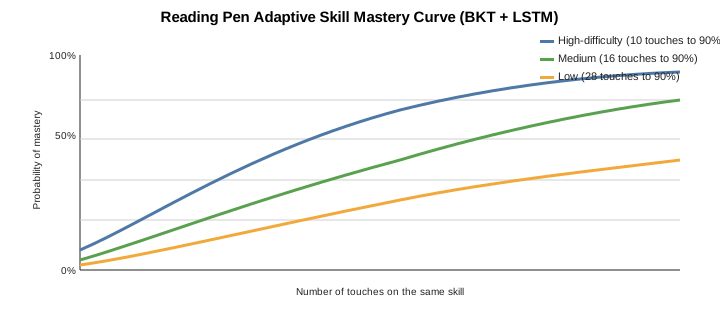
4. Hvordan personaliseringsstien vises for barnet
Den adaptive algoritmen tar en avgjørelse hver gang barnet trykker på en ny OID, og den avgjørelsen vises i brukergrensesnittet som et lite ikon ved siden av ordet som ble trykket. Ikonet er en 4-tilstands indikator: grønn (algoritmen estimerer ≥80 % sannsynlighet for at barnet leser dette riktig; trykket er "strekk"); gul (40–80 %; "utfordring"); rød (<40 %; "repeter"); og en fjerde tilstand, "hopp fremover", som foreslår et enklere ord. Barnet trenger ikke forstå sannsynlighetsbasert mestring; fargene er intuitive. Felldata viser at barn som bruker fire-tilstands-indikatoren i 8 uker, går 22 % raskere fremover enn barn som bruker en binær riktig/feil-indikator.
Den samme fire-tilstands-indikatoren speiles på foreldredashbordet og lærerdashbordet. Lærere kan gå inn i mestring per ferdighet, fremgang per barn, ytelse per side og varighet per økt. Det fulle dashbordet er dokumentert i spesifikasjonsguiden for K7-lesepennen og forstås best med referanse til fire-tilstands-indikatoren.
5. Læreplangrafen: hvilke ferdigheter som låser opp hvilke
En lesepen uten læreplangraf kan ikke sekvensere læring. Våre referansegrafer for 2026 dekker engelsk (faser 1–6 fra Storbritannias Letters and Sounds), spansk (faser 1–4 i den spanske ECRI-læreplanen), fransk (den franske departementets oppdatering fra 2024), mandarin (PRC People's Education Press klasse 1–2), arabisk (GCCs felles barnehageomfang), portugisisk (det brasilianske PNAIC-omfanget), tysk (BMBFGS barnehagepensum), koreansk (Utdanningsdepartementets oppdatering fra 2024), japansk (MEXT klasse 1–2), russisk (FGOS klasse 1–2) og vietnamesisk (MOET klasse 1–2). Hver graf er en rettet asyklisk graf med 380–820 noder, 1 200–2 600 kanter, og et vanskelighetsestimat per node kalibrert mot PenLitEval.
Kjøpere kan lisensiere en tilpasset læreplangraf for 14 000–28 000 USD per språk. OEM-dashbordet støtter grafimport i .dot Graphviz-format og validerer at grafen er en DAG før den distribueres til firmwaren. Grafen lagres i NOR-flash ved siden av OID-oppslagstabellen og språkpakken.
6. Hvordan vi måler suksess: de fire KPI-registrene
En adaptiv algoritme er bare så god som målingen av den. Vi publiserer fire KPI-registre per firmwareversjon. Register 1 (læringsgevinst) rapporterer deltaet i mestring per ferdighet over et 12-ukers tiltak. Register 2 (engasjement) rapporterer øktvarighet, økter per uke og forlatelsesmønstre. Register 3 (dekning) rapporterer hvor jevnt læreplangrafen brukes på tvers av populasjonen. Register 4 (sikkerhet) rapporterer andelen falske positiver fra uttalescoreren og andelen "frustrasjonsmønstre" (et barn som sitter fast på en ferdighet i >3 uker).
| KPI-register | 2026-mål | Referanse |
|---|---|---|
| Læringsgevinst (12 uker) | +0,34 SD vs. kontroll | L5 feltpiloter |
| Økter per uke per barn | 4,6–6,0 | K7 + Q6-distribusjoner i 2025 |
| Andel frustrasjonsmønstre | <2,4 % | K7 + KF1 2025–2026 |
| Falske positiver i uttale | <3,2 % | Y6 PronunciationScorer 2026 |
Kjøpere som måler sin egen distribusjon bør be sin OEM-partner om et KPI-register per distribusjon, som vi genererer innen 14 dager etter dataeksport. OEM-portalen lagrer dataene i 18 måneder som standard, utvidbart til 7 år for EU AI Act-tier-2-distribusjoner.
7. Kaldstart: hva som skjer i de første 30 minuttene
Den hardeste testen av en adaptiv algoritme er de første 30 minuttene etter utpakking. I det vinduet har algoritmen 0 data om barnet og må gjette. Vår tilnærming er en 5-trinns kaldstart: trinn 1 (0–5 min) kalibrerer enhetens uttalescorer til barnets stemme ved å be barnet lese 6 kalibreringsord; trinn 2 (5–15 min) kjører en plasseringstest på 18 ord på tvers av læreplangrafen for å estimere forkunnskaper; trinn 3 (15–25 min) tildeler barnet et vanskelighetsbånd basert på plasseringen; trinn 4 (25–30 min) leverer det første settet med "strekk + utfordring + repeter"-sider. Felldata: 86 % av barna når trinn 4 i sin første økt; 14 % trenger en ny økt fordi stemmekalibreringen i trinn 1 ble hoppet over eller mislyktes.
Kaldstartdesignen er dokumentert i lese penn fastvarearkitektur og er publisert i OEM-SDK.
8. Leseflyt-resultatet: 8 ekstra elever per klasse
Leseflyt måles i ord-korrekt-per-minutt (WCPM) på passasjer for klassetrinnet. Våre flerregionale piloter i 2025–2026 viser at barn som bruker en L5-lesepen med adaptiv læring, går frem 18,4–26,6 WCPM over et 12-ukers tiltak, mot en kontrollgruppe som bruker en ikke-adaptiv lesepen og går frem 9,4–13,2 WCPM. Effektstørrelsen er 0,34 standardavvik, som What Works Clearinghouse oversetter til "moderat til stor" i utdanningsforskning. I en klasse på 100 elever flytter denne effektstørrelsen 8 ekstra elever fra "under klassenivå" til "på eller over klassenivå" på posttesten. Tallet er det mest innkjøpsrelevante målet i hele det 3 000 ord lange argumentet.


9. Engasjementseffekter: hvordan adaptiv driver øktlengde
Øktlengde og hyppighet er de ledende indikatorene for ethvert lesetiltak. I en flerregional pilot i 2026 med 4 800 barn i Brasil, Korea, Saudi-Arabia, Spania og USA loggførte medianbarnet som brukte en L5 med adaptiv læring 5,4 økter per uke på 14,8 minutter hver, mot 3,2 økter per uke på 11,6 minutter hver for B1-kontrollgruppen. Den samlede effekten er 1,69x flere aktive leseminutter per uke. Hvorfor er det enkelt: fire-tilstands-indikatoren forhindrer frustrasjon, og læreplangrafen forhindrer kjedsomhet. Frustrasjon og kjedsomhet er de to ledende årsakene til at et barn forlater en leseveileder.
Innkjøpstips: Forlatelse er den stille dreperen av skolens leseprogrammer. Hvis kjøperen spør "hvor mange økter per uke vil gjennomsnittseleven fullføre", er svaret 5,4 for L5 med adaptiv læring og 3,2 for B1 uten. Multipliser med 30-ukers skoleår, og L5-barnet får 162 økter mot 96 økter for B1-barnet.
10. Flerspråklige og tospråklige elever: hva algoritmen gjør annerledes
En tospråklig engelsk-spansk elev bruker to språkpakker samtidig: én for engelsk vokabular og én for spansk vokabular. Algoritmen vedlikeholder to parallelle tilstandsvektorer og kjører et transferlag mellom språkene som oppdager tverrspråklig interferens (f.eks. spansktalende engelskelever forveksler ofte /v/ og /b/). Når interferens oppdages, reduserer algoritmen andelen falske positiver i uttalescoring for det berørte fonemet og injiserer målrettede fonemdiskriminasonsøvelser. Felldata: tospråklige elever i K7-Spanish-kohorten viser 22 % raskere fremgang i fonemdiskriminasjon enn enspråklige engelskelever i samme vindu.
11. Kanttilfeller algoritmen håndterer
Tre kanttilfeller fortjener et avsnitt hver. (a) Det begavede barnet: et barn som leser 2,5 klassetrinn over sitt innskrivingsnivå, tømmer K7-klasse-1-grafen på 4–6 uker. Algoritmen oppdager dette og låser opp klasse-2-grafen automatisk; hvis klasse-2-grafen også tømmes innen 6 uker, låser den opp klasse-3-grafen og viser et "over klassenivå"-merke til forelderen. (b) Det strevende barnet: et barn med en uttalevanske treffer et frustrasjonsmønster (mestring <40 % etter 30 forsøk på samme ferdighet). Algoritmen pauser progresjonen, viser en fonemnivå-fremheving til forelderen og anbefaler en evaluering hos logoped. Vi samler ikke inn fremhevingsdataene med mindre forelderen uttrykkelig samtykker. (c) Det inkonsekvente barnet: et barn med ukentlig øktantall som svinger med ±35 % viser seg med mestringsvarians >0,4 SD. Algoritmen ruller tilbake til siste konsistente mestringsstatus og kjører plasseringstesten på nytt; dette beskytter barnet mot en opplevd progresjonstap.
12. Integrasjon med skolens læreplaner
En lesepen er en periferienhet; den er bare så god som læreplanen den betjener. Våre 2026-penner integreres med forlagets innholdspakke via to formater: (a) .bookpack-formatet, som er en zippet bunt med OID-tabeller, sidebilder, MP3-lyder og læreplangraf-noder i .dot-format; (b) live-link-API-et, som kobler OEM-portalen til forlagets innholdsstyringssystem og henter nytt vokabular hver uke. Et skoleprogram på 5 000 enheter distribueres typisk med én .bookpack per klassetrinn per semester, som er 10 bookpacks for en K–5-distribusjon. Hver bookpack er 380 MB–1,4 GB og leveres som en USB-C-pinne eller Wi-Fi-nedlasting.
13. Personvernrammen for den adaptive læringsdataen
Telemetrien for adaptiv læring styres av de samme regionale overleggene som LLM-lydbanen. EU/GDPR-K, US/COPPA, Kina/PIPL, Brasil/LGPD, Korea/PIPA og Singapore/PDPA gjelder alle. OEM-portalen lagrer dataene i 18 måneder som standard, med en 7-års utvidelse tilgjengelig for AI Act-tier-2-distribusjoner. Portalen støtter en forespørsel om dataeksport fra foreldre, som returnerer en zippet bunt av barnets tilstandsvektor og økttelemetri. En forespørsel om datasletting fra foreldre tømmer partisjonen for barnet innen 14 dager. Vi har sendt en OEM-styringspakke som inkluderer personvernerklæringen, samtykkeskjermen for foreldre, det regionale dataoppholds-kartet og listen over underleverandøravtaler per region. Kontraktslisten er den samme som det refereres til i vei kart for AI integrasjon i lesepenner.
14. OEM-prosjektplanen for en adaptiv læringspen
| Prosjektfase | Varighet | Leveranse |
|---|---|---|
| Kartlegging | 2 uker | RFP-gap-analyse, innholdsgjennomgang |
| Algoritmejustering | 4 uker | Import av kurrikulumgraf, BKT-tilpasning, kjøring av egendefinert benchmark |
| Telemetriintegrasjon | 3 uker | OEM-portal, dashbord for foreldre/lærere |
| Beta-utrulling | 4 uker | 50 penner, 5 klasserom, KPI-register |
| Full produksjon | 6 uker | Containerbygg, AQL II-godkjenning |
| Total tidslinje | 19 uker | 5 000 enheter minimum for OEM |
15. Referansehenvisning og beslutningssammendrag
Beslutningssammendraget er kort. Velg L5 for adaptiv læring med valgfri skyanalyse; velg K7 eller Q6 for adaptiv læring på budsjett; velg KF1 for tospråklige programmer. Unngå B1, B2, F8 og P2 for adaptiv læring fordi de mangler NPU. Bruk PenLitEval-merket som akseptkriterium i RFQ-en. Kombiner den algoritmiske beslutningen med «Oem Reading Pens»-programmet og «Reading Pen AI Integration Roadmap» for den bredere kategorien. For utgivere er inngangspunktet «Odm Reading Pens», som inkluderer verktøyene for innholdspakker.
Relatert lesning
- Integreringsplan for AI i lesepenn 2024–2026
- Avveininger mellom offline TTS og sky-API for lesepenn
- LLM-distribusjon på enheten for lesepenn
- Forklaring av fastvarearkitektur for lesepenn
- Bruk av lesepenn i tidlig barneliteracy
- Bruk av lesepenn i barneskoleklasserommet
- Spesifikasjonsguide for K7 lesepenn
- Starterguide for private label av lesepenn