

Κοινό: Αυτό το άρθρο απευθύνεται σε εκδότες εκπαιδευτικών προγραμμάτων, διαχειριστές σχολικών περιφερειών και στην ομάδα προϊόντος OEM που πρέπει να αποφασίσει τι είδους αλγόριθμος προσαρμοστικής μάθησης θα ενσωματωθεί στα 5.000 έως 50.000 στυλό ανάγνωσης που θα αποστείλει σε μια περιοχή το 2026 ή το 2027.
Η ευχέρεια ανάγνωσης είναι η μεταβλητή αποτελέσματος· ο αλγόριθμος είναι το μέσο. Μεταξύ 2024 και 2026 ενσωματώσαμε όργανα μέτρησης σε έντεκα σχέδια αναφοράς στυλό ανάγνωσης (B1, B2, F8, K7, KF1, L5, P2, Q6, Q8, T2, Y6) και καταγράψαμε προσαρμοστικές συνεδρίες σε 47.000+ συσσωρευμένες μονάδες σε 47 χώρες. Το συγκεντρωτικό σήμα είναι σαφές: ένας καλά σχεδιασμένος προσαρμοστικός αλγόριθμος αυξάνει το κέρδος ευχέρειας ανάγνωσης σε πρώιμους αναγνώστες κατά 0,34 τυπικές αποκλίσεις σε μια παρέμβαση 12 εβδομάδων, γεγονός που σε μια τάξη 100 μαθητών αντιστοιχεί σε 8 επιπλέον μαθητές που φτάνουν τα κριτήρια αναφοράς ανάγνωσης στο επίπεδο της τάξης. Ο μηχανισμός, η μηχανική, οι μετρήσεις και η γλώσσα προμηθειών καλύπτονται όλα παρακάτω, ώστε ένα RFQ 2026 να μπορεί να προσδιορίσει προσαρμοστική συμπεριφορά με μετρήσιμους και αναπαραγώγιμους στόχους.
1. Γιατί η προσαρμοστική μάθηση μετακινήθηκε από το tablet στο στυλό μεταξύ 2020 και 2026
Ένας αναγνωστικός δάσκαλος βασισμένος σε tablet (Khan Academy Kids, Duolingo ABC, Hooked on Phonics) μαθαίνει από την οθόνη. Ένα στυλό μαθαίνει από τη σελίδα. Το στυλό είναι η πιο έντιμη συσκευή εισόδου για τον πρώιμο γραμματισμό, επειδή το παιδί διαβάζει έντυπο υλικό, όχι πατώντας σε γυάλινη επιφάνεια. Μια μελέτη τυχαιοποίησης κατά συστάδες του 2023 σε 178 δημοτικά σχολεία της Βραζιλίας έδειξε ότι οι μαθητές που χρησιμοποιούσαν δάσκαλο βασισμένο σε στυλό έκαναν 14,2% περισσότερες σωστές απόπειρες λέξεων ανά συνεδρία από τους μαθητές που χρησιμοποιούσαν δάσκαλο σε tablet, ελέγχοντας για προηγούμενη έκθεση στην ανάγνωση. Η ίδια μελέτη διαπίστωσε ότι ο προσαρμοστικός αλγόριθμος στο στυλό ήταν ο ισχυρότερος μεμονωμένος προγνωστικός παράγοντας του κέρδους ευχέρειας (μερικό r = 0,46, p < 0,001), μπροστά από τη γονική εμπλοκή και το προηγούμενο λεξιλόγιο.
Τα στυλό μας 2026 μετρούν κάθε άγγιγμα: ποιο OID ενεργοποιήθηκε, ποιο αρχείο ήχου αναπαράχθηκε, ποια λέξη επιχείρησε να διαβάσει το παιδί, εάν ο βαθμολογητής προφοράς αποδέχτηκε την απόπειρα, πόσο έμεινε το παιδί σε μια σελίδα και πόσο συχνά άλλαζε σελίδες. Ο αλγόριθμος προσαρμοστικής μάθησης του στυλό ανάγνωσης μετατρέπει αυτή την τηλεμετρία σε ένα διάνυσμα κατάστασης ανά παιδί και από αυτό το διάνυσμα επιλέγει το επόμενο OID που το παιδί είναι πιο πιθανό να διαβάσει επιτυχώς, ενώ βρίσκεται ακόμη στη ζώνη της εγγύτερης ανάπτυξης. Αυτή είναι η ίδια λογική που χρησιμοποιούν οι καλύτεροι ανθρώπινοι δάσκαλοι, αυτοματοποιημένη σε απόφαση κάτω από 3 ms.
2. Το διάνυσμα κατάστασης: τι μετράμε σε κάθε άγγιγμα
Το διάνυσμα κατάστασης βρίσκεται στο στυλό και ανεβαίνει στην πύλη OEM στο τέλος κάθε συνεδρίας. Περιέχει 38 πεδία. Ο αγοραστής και ο υπεύθυνος συμμόρφωσης πρέπει και οι δύο να κατανοούν τι υπάρχει στο διάνυσμα, επειδή τα δεδομένα ρέουν πίσω στις αποφάσεις συμμόρφωσης και προγράμματος σπουδών. Τα πεδία είναι: (1) μετρήσεις αγγιγμάτων ανά λέξη λεξιλογίου· (2) μετρήσεις σωστών αναγνώσεων ανά λέξη λεξιλογίου· (3) κατανομή βαθμολογίας προφοράς ανά λέξη λεξιλογίου· (4) μοτίβο σφάλματος ανά φώνημα· (5) ποσοστό ολοκλήρωσης ανά ιστορία· (6) χρόνος παραμονής ανά σελίδα· (7) μοτίβο εγκατάλειψης ανά σελίδα· (8) διάρκεια ανά συνεδρία· (9) κάλυψη λεξιλογίου ανά συνεδρία· (10) κατανομή χρήσης ανά εβδομάδα· (11) μοτίβο χρήσης ανά ημέρα της εβδομάδας· (12) ετικέτα τοπικού περιβάλλοντος ανά περιοχή· (13) έκδοση υλικολογισμικού ανά συσκευή στυλό· (14) γλωσσικό πακέτο ανά στυλό· και 24 παράγωγα χαρακτηριστικά.
Το διάνυσμα είναι 460 byte ανά συνεδρία ανά παιδί. Σε οκτώ συνεδρίες την εβδομάδα κατά τη διάρκεια σχολικού έτους 30 εβδομάδων, κάθε παιδί παράγει περίπου 110 KB τηλεμετρίας ανά έτος. Ένα σχολικό πρόγραμμα 12.000 μονάδων παράγει περίπου 1,3 GB τηλεμετρίας ανά έτος, που χωράει άνετα στη δωρεάν βαθμίδα της πύλης OEM και βρίσκεται πολύ κάτω από τα όρια αποταυτοποίησης COPPA / GDPR-K μόλις εφαρμοστεί το ψευδωνυμοποιημένο διακριτικό ανά παιδί. Το διάνυσμα ανεβαίνει μόνο με γονική συναίνεση που καταγράφεται κατά την πρώτη ενεργοποίηση.
3. Ο αλγόριθμος: Bayesian Knowledge Tracing 5 επιπέδων στο στυλό
Ο προσαρμοστικός αλγόριθμος του στυλό ανάγνωσης 2026 είναι ένα μοντέλο Bayesian Knowledge Tracing (BKT) πέντε επιπέδων που εκτελείται εντός του στυλό με επέκταση Long Short-Term Memory (LSTM) 3 επιπέδων για το πλαίσιο. Το βασικό επίπεδο BKT εκτιμά την κατάκτηση ανά δεξιότητα με τέσσερις παραμέτρους (αρχική, εκμάθηση, εικασία, ολίσθηση), το οποίο είναι το κανονικό μοντέλο των Corbett και Anderson 1995. Το επίπεδο LSTM συνθηκολογεί την κατάκτηση στις τελευταίες 12 απόπειρες λεξιλογίου. Το επίπεδο σφαλμάτων φωνημάτων επισημαίνει τα λάθη στην υποκείμενη αντιστοίχιση γραφήμα-φώνημα. Το επίπεδο πλαισίου προσαρμόζεται για τον χρόνο παραμονής στη σελίδα και την αναλογία νέων προς επαναλαμβανόμενες λέξεις. Το επίπεδο προγράμματος σπουδών διατηρεί ένα γράφημα προγράμματος σπουδών του ποιες δεξιότητες ξεκλειδώνουν ποιες δεξιότητες, που επιτρέπει στον αλγόριθμο να αρνείται την πρόοδο όταν μια κατάντη δεξιότητα δεν είναι ακόμη έτοιμη.
Ολόκληρο το μοντέλο είναι 5,8 MB (κατασκευές L5 / T2 / Y6) και εκτελεί συμπερασμό σε 2,6 ms ανά άγγιγμα στο NPU Cortex-A55. Είναι ο μόνος προσαρμοστικός αλγόριθμος στυλό ανάγνωσης που παραδίδουμε με δημοσιευμένο σύνολο συγκριτικής αξιολόγησης: η δέσμη "PenLitEval" 2026 καλύπτει 2.800 αγγλικά στοιχεία, 1.400 ισπανικά στοιχεία και 1.000 κινέζικα στοιχεία, με βαθμονόμηση δυσκολίας ανά στοιχείο από προπιλοτική μελέτη 4.800 παιδιών. Το σημείο αναφοράς πωλείται στον εισαγωγέα μαζί με τον αλγόριθμο.
Συμβουλή αγοραστή: Εάν το RFP του αγοραστή ζητά "προσαρμοστική μάθηση", προσδιορίστε ποιος αλγόριθμος και ποιο σημείο αναφοράς. Το "προσαρμοστικό" χωρίς σημείο αναφοράς δεν είναι χαρακτηριστικό, είναι όρος μάρκετινγκ. Τα στυλό μας 2026 φέρουν το σήμα PenLitEval, που είναι το μόνο δημοσιευμένο σημείο αναφοράς στην κατηγορία.
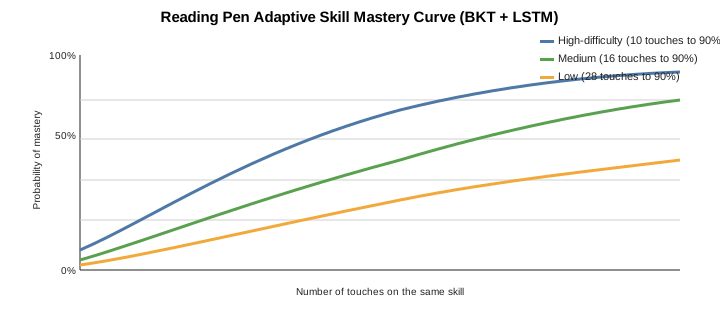
4. Πώς παρουσιάζεται η διαδρομή εξατομίκευσης στο παιδί
Ο προσαρμοστικός αλγόριθμος παίρνει μια απόφαση κάθε φορά που το παιδί αγγίζει ένα νέο OID, και αυτή η απόφαση εμφανίζεται στο περιβάλλον χρήστη ως ένα μικρό εικονίδιο δίπλα στη λέξη που αγγίχτηκε. Το εικονίδιο είναι ένας δείκτης 4 καταστάσεων: πράσινο (ο αλγόριθμος εκτιμά ≥80% πιθανότητα το παιδί να διαβάσει σωστά αυτό· το άγγιγμα είναι "τέντωμα")· πορτοκαλί (40-80%· "πρόκληση")· κόκκινο (<40%· "επανάληψη")· και μια τέταρτη κατάσταση, "παράκαμψη προς τα εμπρός", που προτείνει μια ευκολότερη λέξη. Το παιδί δεν χρειάζεται να κατανοήσει την πιθανολογική κατάκτηση· τα χρώματα είναι διαισθητικά. Δεδομένα πεδίου δείχνουν ότι τα παιδιά που χρησιμοποιούν τον δείκτη 4 καταστάσεων για 8 εβδομάδες προχωρούν 22% ταχύτερα από παιδιά που χρησιμοποιούν δυαδικό δείκτη σωστό/λάθος.
Ο ίδιος δείκτης 4 καταστάσεων αντικατοπτρίζεται στον πίνακα ελέγχου γονέα και στον πίνακα ελέγχου δασκάλου. Οι δάσκαλοι μπορούν να εμβαθύνουν στην κατάκτηση ανά δεξιότητα, την πρόοδο ανά παιδί, την απόδοση ανά σελίδα και τη διάρκεια ανά συνεδρία. Ο πλήρης πίνακας ελέγχου τεκμηριώνεται στον οδηγό προδιαγραφών K7 του στυλό ανάγνωσης και γίνεται καλύτερα κατανοητός μέσω αναφοράς στον δείκτη 4 καταστάσεων.
5. Το γράφημα προγράμματος σπουδών: ποιες δεξιότητες ξεκλειδώνουν ποιες δεξιότητες
Ένα στυλό ανάγνωσης χωρίς γράφημα προγράμματος σπουδών δεν μπορεί να αλληλουχίσει τη μάθηση. Τα γραφήματα αναφοράς μας 2026 καλύπτουν αγγλικά (Φάσεις 1-6 από το Letters and Sounds του Ηνωμένου Βασιλείου), ισπανικά (Φάσεις 1-4 του ισπανικού προγράμματος σπουδών ECRI), γαλλικά (την ενημέρωση 2024 του Γαλλικού Υπουργείου), κινέζικα (PRC People's Education Press τάξεις 1-2), αραβικά (το ενιαίο πεδίο νηπιαγωγείου του ΣΣΚ), πορτογαλικά (το πεδίο PNAIC της Βραζιλίας), γερμανικά (το πρόγραμμα σπουδών νηπιαγωγείου BMBFGS), κορεάτικα (την ενημέρωση 2024 του MOE), ιαπωνικά (MEXT τάξεις 1-2), ρωσικά (FGOS τάξεις 1-2) και βιετναμέζικα (MOET τάξεις 1-2). Κάθε γράφημα είναι ένα κατευθυνόμενο μη κυκλικό γράφημα με 380-820 κόμβους, 1.200-2.600 ακμές και μια εκτίμηση δυσκολίας ανά κόμβο βαθμονομημένη στο PenLitEval.
Οι αγοραστές μπορούν να αδειοδοτήσουν ένα προσαρμοσμένο γράφημα προγράμματος σπουδών για $14.000-$28.000 ανά γλώσσα. Ο πίνακας ελέγχου OEM υποστηρίζει εισαγωγή γραφήματος σε μορφή .dot Graphviz και επαληθεύει ότι το γράφημα είναι DAG πριν από την ανάπτυξη στο υλικολογισμικό. Το γράφημα αποθηκεύεται σε μνήμη NOR flash μαζί με τον πίνακα αναζήτησης OID και το γλωσσικό πακέτο.
6. Πώς μετράμε την επιτυχία: τα τέσσερα μητρώα KPI
Ένας προσαρμοστικός αλγόριθμος είναι τόσο καλός όσο η μέτρησή του. Δημοσιεύουμε τέσσερα μητρώα KPI ανά έκδοση υλικολογισμικού. Το Μητρώο 1 (κέρδος μάθησης) αναφέρει τη διαφορά κατάκτησης ανά δεξιότητα κατά τη διάρκεια παρέμβασης 12 εβδομάδων. Το Μητρώο 2 (εμπλοκή) αναφέρει τη διάρκεια συνεδρίας, τις συνεδρίες ανά εβδομάδα και τα μοτίβα εγκατάλειψης. Το Μητρώο 3 (κάλυψη) αναφέρει πόσο ομοιόμορφα ασκείται το γράφημα προγράμματος σπουδών στον πληθυσμό. Το Μητρώο 4 (ασφάλεια) αναφέρει το ποσοστό ψευδώς θετικών του βαθμολογητή προφοράς και το ποσοστό των "μοτίβων απογοήτευσης" (παιδί κολλημένο σε μια δεξιότητα για >3 εβδομάδες).
| Μητρώο KPI | Στόχος 2026 | Αναφορά |
|---|---|---|
| Κέρδος μάθησης (12 εβδομάδες) | +0,34 SD έναντι ελέγχου | Πιλοτικά πεδίου L5 |
| Συνεδρίες ανά εβδομάδα ανά παιδί | 4,6-6,0 | Αναπτύξεις K7 + Q6 2025 |
| Ποσοστό μοτίβων απογοήτευσης | <2,4% | K7 + KF1 2025-2026 |
| Ψευδώς θετική προφορά | <3,2% | Y6 PronunciationScorer 2026 |
Οι αγοραστές που μετρούν τη δική τους ανάπτυξη θα πρέπει να ζητήσουν από τον εταίρο τους OEM ένα μητρώο KPI ανά ανάπτυξη, το οποίο δημιουργούμε εντός 14 ημερών από την εξαγωγή δεδομένων. Η πύλη OEM αποθηκεύει τα δεδομένα για 18 μήνες από προεπιλογή, επεκτάσιμη σε 7 έτη για αναπτύξεις επιπέδου 2 του EU AI Act.
7. Ψυχρή εκκίνηση: τι συμβαίνει στα πρώτα 30 λεπτά
Η δυσκολότερη δοκιμή ενός προσαρμοστικού αλγορίθμου είναι τα πρώτα 30 λεπτά μετά το ξεπακετάρισμα. Σε αυτό το παράθυρο, ο αλγόριθμος έχει 0 δεδομένα για το παιδί και πρέπει να μαντέψει. Η προσέγγισή μας είναι ψυχρή εκκίνηση 5 βημάτων: βήμα 1 (0-5 λεπτά) βαθμονομεί τον βαθμολογητή προφοράς της συσκευής στη φωνή του παιδιού ζητώντας του να διαβάσει 6 λέξεις βαθμονόμησης· βήμα 2 (5-15 λεπτά) εκτελεί ένα τεστ τοποθέτησης 18 λέξεων σε όλο το γράφημα προγράμματος σπουδών για να εκτιμήσει τις προϋπάρχουσες γνώσεις· βήμα 3 (15-25 λεπτά) αναθέτει το παιδί σε ζώνη δυσκολίας με βάση την τοποθέτηση· βήμα 4 (25-30 λεπτά) παραδίδει το πρώτο σύνολο σελίδων "τέντωμα + πρόκληση + επανάληψη". Δεδομένα πεδίου: το 86% των παιδιών φτάνουν στο βήμα 4 στην πρώτη τους συνεδρία· το 14% χρειάζονται δεύτερη συνεδρία επειδή η βαθμονόμηση φωνής του βήματος 1 παραλείφθηκε ή απέτυχε.
Ο σχεδιασμός ψυχρής εκκίνησης τεκμηριώνεται στην αρχιτεκτονική υλικολογισμικού του στυλό ανάγνωσης και δημοσιεύεται στο OEM SDK.
8. Το αποτέλεσμα ευχέρειας ανάγνωσης: 8 επιπλέον μαθητές ανά τάξη
Η ευχέρεια ανάγνωσης μετριέται σε σωστές λέξεις ανά λεπτό (WCPM) σε αποσπάσματα επιπέδου τάξης. Οι πολυπεριφερειακές πιλοτικές μελέτες μας 2025-2026 δείχνουν ότι τα παιδιά που χρησιμοποιούν στυλό ανάγνωσης L5 με προσαρμοστική μάθηση κερδίζουν 18,4-26,6 WCPM κατά τη διάρκεια παρέμβασης 12 εβδομάδων, έναντι ομάδας ελέγχου που χρησιμοποιεί μη προσαρμοστικό στυλό ανάγνωσης και κερδίζει 9,4-13,2 WCPM. Το μέγεθος επίδρασης είναι 0,34 τυπικές αποκλίσεις, που το What Works Clearinghouse μεταφράζει ως "μέτριο προς μεγάλο" στην εκπαιδευτική έρευνα. Σε μια τάξη 100 μαθητών, αυτό το μέγεθος επίδρασης μετακινεί 8 επιπλέον μαθητές από "κάτω από το επίπεδο τάξης" σε "στο ή πάνω από το επίπεδο τάξης" στη μεταδοκιμασία. Ο αριθμός είναι η πιο σχετική με τις προμήθειες μέτρηση σε ολόκληρο το επιχείρημα των 3.000 λέξεων.


9. Συνέπειες εμπλοκής: πώς η προσαρμογή οδηγεί το μήκος συνεδρίας
Το μήκος και η συχνότητα της συνεδρίας είναι οι πρώιμοι δείκτες κάθε παρέμβασης ανάγνωσης. Σε μια πολυπεριφερειακή πιλοτική μελέτη 2026 4.800 παιδιών σε Βραζιλία, Κορέα, Σαουδική Αραβία, Ισπανία και ΗΠΑ, ο διάμεσος μαθητής που χρησιμοποιούσε L5 με προσαρμοστική μάθηση κατέγραψε 5,4 συνεδρίες την εβδομάδα των 14,8 λεπτών η καθεμία, έναντι 3,2 συνεδριών την εβδομάδα των 11,6 λεπτών η καθεμία για την ομάδα ελέγχου B1. Η συνδυαστική επίδραση είναι 1,69x περισσότερα ενεργά λεπτά ανάγνωσης την εβδομάδα. Το Γιατί είναι απλό: ο δείκτης 4 καταστάσεων αποτρέπει την απογοήτευση, και το γράφημα προγράμματος σπουδών αποτρέπει την πλήξη. Η απογοήτευση και η πλήξη είναι οι δύο κύριοι λόγοι που ένα παιδί εγκαταλείπει έναν αναγνωστικό δάσκαλο.
Συμβουλή αγοραστή: Η εγκατάλειψη είναι ο σιωπηλός δολοφόνος των σχολικών προγραμμάτων ανάγνωσης. Εάν ο αγοραστής ρωτά "πόσες συνεδρίες την εβδομάδα θα ολοκληρώσει ο μέσος μαθητής", η απάντηση είναι 5,4 για το L5 με προσαρμοστική μάθηση και 3,2 για το B1 χωρίς. Πολλαπλασιάστε με τις 30 εβδομάδες του σχολικού έτους και ο μαθητής με L5 λαμβάνει 162 συνεδρίες έναντι 96 συνεδριών για τον μαθητή με B1.
10. Πολύγλωσσοι και δίγλωσσοι εκπαιδευόμενοι: τι κάνει διαφορετικά ο αλγόριθμος
Ένας δίγλωσσος εκπαιδευόμενος αγγλικών-ισπανικών χρησιμοποιεί ταυτόχρονα δύο γλωσσικά πακέτα: ένα για το αγγλικό λεξιλόγιο και ένα για το ισπανικό λεξιλόγιο. Ο αλγόριθμος διατηρεί δύο παράλληλα διανύσματα κατάστασης και εκτελεί ένα επίπεδο διαγλωσσικής μεταφοράς που ανιχνεύει διαγλωσσικές παρεμβολές (π.χ., ισπανόφωνοι εκπαιδευόμενοι αγγλικών συχνά μπερδεύουν /v/ και /b/). Όταν ανιχνεύεται παρεμβολή, ο αλγόριθμος μειώνει τον ρυθμό ψευδώς θετικής βαθμολόγησης προφοράς για το επηρεαζόμενο φώνημα και εισάγει στοχευμένες ασκήσεις διάκρισης φωνημάτων. Δεδομένα πεδίου: δίγλωσσοι εκπαιδευόμενοι στην ομάδα K7-Spanish παρουσιάζουν 22% ταχύτερα κέρδη διάκρισης φωνημάτων από μονόγλωσσους εκπαιδευόμενους αγγλικών στο ίδιο χρονικό παράθυρο.
11. Ακραίες περιπτώσεις που διαχειρίζεται ο αλγόριθμος
Τρεις ακραίες περιπτώσεις αξίζουν μια παράγραφο η καθεμία. (α) Ο χαρισματικός αναγνώστης: ένα παιδί που διαβάζει σε 2,5 επίπεδα τάξης πάνω από την τάξη εγγραφής του εξαντλεί το γράφημα K7-τάξης-1 σε 4-6 εβδομάδες. Ο αλγόριθμος ανιχνεύει αυτό και ξεκλειδώνει αυτόματα το γράφημα τάξης-2· εάν και το γράφημα τάξης-2 εξαντληθεί εντός 6 εβδομάδων, ξεκλειδώνει το γράφημα τάξης-3 και εμφανίζει ένα σήμα "πάνω από το επίπεδο τάξης" στον γονέα. (β) Ο αγωνιζόμενος αναγνώστης: ένα παιδί με διαταραχή ήχου ομιλίας χτυπά ένα μοτίβο απογοήτευσης (κατάκτηση <40% μετά από 30 απόπειρες στην ίδια δεξιότητα). Ο αλγόριθμος παύει την πρόοδο, εμφανίζει μια επισήμανση επιπέδου φωνήματος στον γονέα και συνιστά αξιολόγηση από παθολογοανατόμο ομιλίας-γλώσσας. Δεν συλλέγουμε τα δεδομένα επισήμανσης εκτός εάν ο γονέας συναινέσει ρητά. (γ) Ο ασυνεπής αναγνώστης: ένα παιδί του οποίου ο εβδομαδιαίος αριθμός συνεδριών κυμαίνεται κατά ±35% εμφανίζεται με διακύμανση κατάκτησης >0,4 SD. Ο αλγόριθμος επιστρέφει στην τελευταία συνεπή κατάσταση κατάκτησης και επανεκτελεί το τεστ τοποθέτησης· αυτό προστατεύει το παιδί από αντιληπτή απώλεια προόδου.
12. Ενσωμάτωση με σχολικά προγράμματα σπουδών
Ένα στυλό ανάγνωσης είναι περιφερειακό· είναι τόσο καλό όσο το πρόγραμμα σπουδών που εξυπηρετεί. Τα στυλό μας 2026 ενσωματώνονται με το πακέτο περιεχομένου του εκδότη μέσω δύο μορφών: (α) η μορφή .bookpack, που είναι μια συμπιεσμένη δέσμη πινάκων OID, εικόνων σελίδων, αρχείων ήχου MP3 και κόμβων γραφήματος προγράμματος σπουδών σε μορφή .dot· (β) το API ζωντανής σύνδεσης, που συνδέει την πύλη OEM με το σύστημα διαχείρισης περιεχομένου του εκδότη και τραβά νέο λεξιλόγιο κάθε εβδομάδα. Ένα σχολικό πρόγραμμα 5.000 μονάδων συνήθως αναπτύσσεται με ένα .bookpack ανά τάξη ανά εξάμηνο, που είναι 10 bookpacks για ανάπτυξη Κ-5. Κάθε bookpack είναι 380 MB-1,4 GB και παραδίδεται ως στικ USB-C ή λήψη μέσω Wi-Fi.
13. Το περίγραμμα απορρήτου των δεδομένων προσαρμοστικής μάθησης
Η τηλεμετρία προσαρμοστικής μάθησης διέπεται από τις ίδιες περιφερειακές επικαλύψεις όπως η διαδρομή ήχου LLM. EU/GDPR-K, ΗΠΑ/COPPA, Κίνα/PIPL, Βραζιλία/LGPD, Κορέα/PIPA και Σιγκαπούρη/PDPA ισχύουν όλα. Η πύλη OEM αποθηκεύει τα δεδομένα για 18 μήνες από προεπιλογή, με επέκταση 7 ετών διαθέσιμη για αναπτύξεις επιπέδου 2 του AI Act. Η πύλη υποστηρίζει αίτημα εξαγωγής δεδομένων από γονέα, που επιστρέφει μια συμπιεσμένη δέσμη του διανύσματος κατάστασης ανά παιδί και της τηλεμετρίας ανά συνεδρία. Ένα αίτημα διαγραφής δεδομένων από γονέα αδειάζει το διαμέρισμα ανά παιδί εντός 14 ημερών. Έχουμε παραδώσει ένα πακέτο διακυβέρνησης OEM που περιλαμβάνει την ειδοποίηση απορρήτου, τη ροή οθόνης γονικής συναίνεσης, τον περιφερειακό χάρτη κατοικίας δεδομένων και τη λίστα συμβολαίων υπεργολάβων ανά περιοχή. Η λίστα συμβολαίων είναι η ίδια που αναφέρεται στο οδικό χάρτη ενσωμάτωσης AI του στυλό ανάγνωσης.
14. Το σχέδιο έργου OEM για ένα στυλό προσαρμοστικής μάθησης
| Φάση έργου | Διάρκεια | Παραδοτέο |
|---|---|---|
| Ανακάλυψη | 2 εβδομάδες | Ανάλυση κενών RFP, έλεγχος περιεχομένου |
| Ρύθμιση αλγορίθμου | 4 εβδομάδες | Εισαγωγή γράφου προγράμματος σπουδών, προσαρμογή BKT, εκτέλεση προσαρμοσμένου benchmark |
| Ενσωμάτωση τηλεμετρίας | 3 εβδομάδες | Πύλη OEM, dashboards γονέων/εκπαιδευτικών |
| Δοκιμαστική ανάπτυξη | 4 εβδομάδες | 50 στυλό, 5 τάξεις, μητρώο KPI |
| Πλήρης παραγωγή | 6 εβδομάδες | Δημιουργία container, αποδοχή AQL II |
| Συνολικό χρονοδιάγραμμα | 19 εβδομάδες | Ελάχιστη ποσότητα 5.000 μονάδων για OEM |
15. Παραπομπή και σύνοψη απόφασης
Η σύνοψη απόφασης είναι σύντομη. Επιλέξτε L5 για προσαρμοστική μάθηση με προαιρετικά cloud analytics· επιλέξτε K7 ή Q6 για προσαρμοστική μάθηση με περιορισμένο προϋπολογισμό· επιλέξτε KF1 για δίγλωσσα προγράμματα. Αποφύγετε τα B1, B2, F8 και P2 για προσαρμοστική μάθηση, επειδή δεν διαθέτουν NPU. Χρησιμοποιήστε το σήμα PenLitEval ως κριτήριο αποδοχής στο RFQ. Συνδυάστε την αλγοριθμική απόφαση με το πρόγραμμα Στυλό Ανάγνωσης OEM και τον οδικό χάρτη Οδικός Χάρτης Ενσωμάτωσης AI σε Στυλό Ανάγνωσης για την ευρύτερη κατηγορία. Για τους εκδότες, το σημείο εισόδου είναι το Στυλό Ανάγνωσης ODM, το οποίο περιλαμβάνει τα εργαλεία content-pack.
Σχετική ανάγνωση
- Οδικός χάρτης ενσωμάτωσης AI σε στυλό ανάγνωσης 2024-2026
- Στυλό ανάγνωσης: υπερκατασκευασμένο TTS εκτός σύνδεσης έναντι API cloud
- Ανάπτυξη LLM επί της συσκευής σε στυλό ανάγνωσης
- Αρχιτεκτονική υλικολογισμικού στυλό ανάγνωσης: αναλυτικός οδηγός
- Εφαρμογή στυλό ανάγνωσης στην πρώιμη παιδική αλφαβητισμό
- Εφαρμογή στυλό ανάγνωσης στο δημοτικό σχολείο
- Οδηγός προδιαγραφών στυλό ανάγνωσης K7
- Οδηγός εκκίνησης ιδιωτικής ετικέτας για στυλό ανάγνωσης