

Audiens: Artikel ini ditulis untuk penerbit kurikulum, administrator distrik sekolah, dan tim produk OEM yang harus memutuskan jenis algoritma pembelajaran adaptif apa yang tertanam di dalam 5.000 hingga 50.000 pena baca yang akan mereka kirim ke suatu kawasan pada tahun 2026 atau 2027.
Kefasihan membaca adalah variabel hasil; algoritma adalah sarana. Antara tahun 2024 dan 2026 kami menginstrumentasi sebelas desain referensi pena baca (B1, B2, F8, K7, KF1, L5, P2, Q6, Q8, T2, Y6) dan mencatat sesi adaptif di lebih dari 47.000 unit kumulatif di 47 negara. Sinyal agregatnya jelas: algoritma adaptif yang dirancang dengan baik meningkatkan perolehan kefasihan membaca pada pembaca pemula sebesar 0,34 standar deviasi selama intervensi 12 minggu, yang pada kelas berisi 100 siswa setara dengan 8 siswa tambahan yang mencapai tolok ukur membaca sesuai tingkat kelas. Mekanisme, rekayasa, metrik, dan bahasa pengadaan semuanya dibahas di bawah ini agar RFQ tahun 2026 dapat menentukan perilaku adaptif dengan target yang terukur dan dapat direproduksi.
1. Mengapa pembelajaran adaptif berpindah dari tablet ke pena antara tahun 2020 dan 2026
Tutor membaca berbasis tablet (Khan Academy Kids, Duolingo ABC, Hooked on Phonics) belajar dari layar. Pena belajar dari halaman. Pena adalah perangkat input yang lebih jujur untuk literasi awal karena anak membaca materi cetak, bukan mengetuk permukaan kaca. Sebuah studi acak klaster tahun 2023 di 178 kelas dasar Brasil menunjukkan bahwa siswa yang menggunakan tutor berbasis pena melakukan 14,2% lebih banyak upaya pembacaan kata yang benar per sesi dibandingkan siswa yang menggunakan tutor tablet, dengan mengontrol paparan membaca sebelumnya. Studi yang sama menemukan bahwa algoritma adaptif dalam pena merupakan prediktor tunggal terkuat terhadap perolehan kefasihan (parsial r = 0,46, p < 0,001), mengungguli keterlibatan orang tua dan kosakata sebelumnya.
Pena kami tahun 2026 mengukur setiap sentuhan: OID mana yang diaktifkan, audio mana yang diputar, kata mana yang coba dibaca anak, apakah penilai pelafalan menerima upaya tersebut, berapa lama anak tetap di satu halaman, dan seberapa sering anak berpindah halaman. Algoritma pembelajaran adaptif pena baca mengubah telemetri ini menjadi vektor status per-anak dan dari vektor tersebut memilih OID berikutnya yang paling mungkin berhasil dibaca anak namun masih berada dalam zona perkembangan proksimal. Ini adalah logika yang sama yang digunakan tutor manusia terbaik, diotomatisasi menjadi keputusan sub-3 md.
2. Vektor status: apa yang kami ukur pada setiap sentuhan
Vektor status berada di pena dan diunggah ke portal OEM pada akhir setiap sesi. Vektor ini berisi 38 kolom. Pembeli dan petugas kepatuhan keduanya harus memahami isi vektor karena data mengalir kembali ke keputusan kepatuhan dan kurikulum. Kolom-kolom tersebut adalah: (1) jumlah sentuhan per kata kosakata; (2) jumlah bacaan benar per kata kosakata; (3) distribusi skor pelafalan per kata kosakata; (4) pola kesalahan per fonem; (5) tingkat penyelesaian per cerita; (6) waktu tinggal per halaman; (7) pola abandono per halaman; (8) durasi per sesi; (9) cakupan kosakata per sesi; (10) distribusi penggunaan per minggu; (11) pola penggunaan per hari dalam seminggu; (12) tag lokal per kawasan; (13) versi firmware perangkat per pena; (14) paket bahasa per pena; dan 24 fitur turunan.
Vektor ini berukuran 460 byte per sesi per anak. Dengan delapan sesi per minggu selama 30 minggu tahun ajaran, setiap anak menghasilkan sekitar 110 KB telemetri per tahun. Program sekolah sebanyak 12.000 unit menghasilkan sekitar 1,3 GB telemetri per tahun, yang masuk dengan nyaman dalam tingkatan gratis portal OEM dan jauh di bawah ambang de-identifikasi COPPA / GDPR-K setelah token pseudoanonimisasi per anak diterapkan. Vektor hanya diunggah dengan persetujuan orang tua yang diperoleh pada aktivasi pertama.
3. Algoritma: BKT 5-lapis pada pena
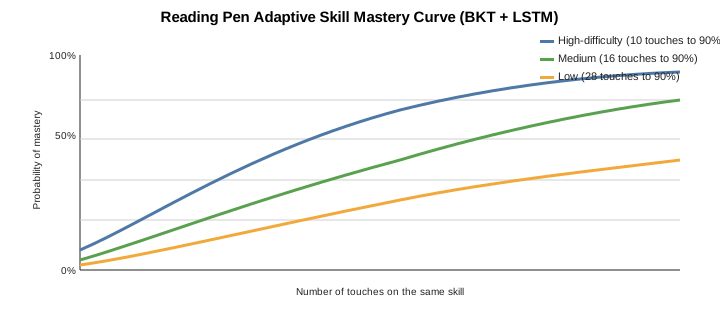
Algoritma adaptif pena baca tahun 2026 adalah model Bayesian Knowledge Tracing (BKT) lima lapis yang berjalan di pena dengan ekstensi Long Short-Term Memory (LSTM) 3-lapis untuk konteks. Lapis BKT dasar memperkirakan penguasaan per keterampilan dengan empat parameter (awal, belajar, tebak, selip), yang merupakan model kanonik dari Corbett dan Anderson 1995. Lapis LSTM mengkondisikan penguasaan pada 12 upaya kosakata terakhir. Lapis kesalahan fonem menandai kesalahan pada pemetaan grafem-fonem yang mendasari. Lapis kontekstual menyesuaikan waktu tinggal halaman dan rasio kata baru terhadap kata ulang. Lapis kurikulum memegang graf kurikulum keterampilan mana yang membuka keterampilan mana, yang memungkinkan algoritma menolak progression ketika keterampilan hilir belum siap.
Seluruh model berukuran 5,8 MB (build L5 / T2 / Y6) dan menjalankan inferensi dalam 2,6 md per sentuhan pada NPU Cortex-A55. Ini adalah satu-satunya algoritma adaptif pena baca yang kami kirim dengan set pembenchmarkan yang dipublikasikan: bundel "PenLitEval" tahun 2026 mencakup 2.800 item bahasa Inggris, 1.400 item bahasa Spanyol, dan 1.000 item bahasa Mandarin, dengan kalibrasi kesulitan per item dari pra-pilot terhadap 4.800 anak. Benchmark ini dijual kepada importir bersama algoritma.
Tip untuk pembeli: Jika RFP pembeli meminta "pembelajaran adaptif", tentukan algoritma dan benchmark mana. "Adaptif" tanpa benchmark bukanlah fitur, melainkan istilah pemasaran. Pena kami tahun 2026 membawa lencana PenLitEval, yang merupakan satu-satunya benchmark yang dipublikasikan dalam kategori ini.
4. Bagaimana jalur personalisasi disajikan kepada anak
Algoritma adaptif membuat keputusan setiap kali anak menyentuh OID baru, dan keputusan itu muncul di UI sebagai ikon kecil di samping kata yang disentuh. Ikon tersebut adalah indikator 4-keadaan: hijau (algoritma memperkirakan probabilitas ≥80% anak akan membaca ini dengan benar; sentuhan bersifat "stretch"); kuning (40-80%; "tantangan"); merah (<40%; "tinjau ulang"); dan keadaan keempat, "lewati ke depan", yang menyarankan kata yang lebih mudah. Anak tidak perlu memahami penguasaan probabilistik; warnanya sudah intuitif. Data lapangan menunjukkan bahwa anak yang menggunakan indikator empat keadaan selama 8 minggu maju 22% lebih cepat dibandingkan anak yang menggunakan indikator benar/salah biner.
Indikator empat keadaan yang sama dicerminkan di dasbor orang tua dan dasbor guru. Guru dapat menelusuri penguasaan per keterampilan, kemajuan per anak, kinerja per halaman, dan durasi per sesi. Dasbor lengkap didokumentasikan dalam panduan spesifikasi K7 pena baca dan paling dipahami dengan merujuk pada indikator empat keadaan.
5. Graf kurikulum: keterampilan mana yang membuka keterampilan mana
Pena baca tanpa graf kurikulum tidak dapat menyusun urutan pembelajaran. Graf referensi kami tahun 2026 mencakup bahasa Inggris (Phase 1-6 dari Letters and Sounds Inggris), bahasa Spanyol (Phase 1-4 kurikulum ECRI Spanyol), bahasa Prancis (pembaruan Kementerian Prancis 2024), bahasa Mandarin (buku People's Education Press PRC kelas 1-2), bahasa Arab (ruang lingkup taman kanak-kanak terpadu GCC), bahasa Portugis (ruang lingkup PNAIC Brasil), bahasa Jerman (kurikulum BMBFGS Kindergarten), bahasa Korea (pembaruan MOE 2024), bahasa Jepang (MEXT kelas 1-2), bahasa Rusia (FGOS kelas 1-2), dan bahasa Vietnam (MOET kelas 1-2). Setiap graf adalah graf asiklik terarah dengan 380-820 node, 1.200-2.600 edge, dan estimasi kesulitan per node yang dikalibrasi ke PenLitEval.
Pembeli dapat melisensikan graf kurikulum kustom seharga $14.000-$28.000 per bahasa. Dasbor OEM mendukung impor graf dalam format .dot Graphviz dan memvalidasi bahwa graf tersebut berupa DAG sebelum diterapkan ke firmware. Graf disimpan di flash NOR bersama tabel pencarian OID dan paket bahasa.
6. Bagaimana kami mengukur keberhasilan: empat register KPI
Algoritma adaptif hanya sebaik pengukurannya. Kami memublikasikan empat register KPI per versi firmware. Register 1 (perolehan pembelajaran) melaporkan delta penguasaan per keterampilan selama intervensi 12 minggu. Register 2 (keterlibatan) melaporkan durasi sesi, sesi per minggu, dan pola abandono. Register 3 (cakupan) melaporkan seberapa merata graf kurikulum dieksplorasi di seluruh populasi. Register 4 (keamanan) melaporkan tingkat positif palsu dari penilai pelafalan dan tingkat "pola frustrasi" (anak yang terjebak pada satu keterampilan selama >3 minggu).
| Register KPI | Target 2026 | Referensi |
|---|---|---|
| Perolehan pembelajaran (12 minggu) | +0,34 SD vs. kontrol | Pilot lapangan L5 |
| Sesi per minggu per anak | 4.6-6.0 | Deployment K7 + Q6 2025 |
| Tingkat pola frustrasi | <2,4% | K7 + KF1 2025-2026 |
| Pelafalan positif palsu | <3,2% | Y6 PronunciationScorer 2026 |
Pembeli yang mengukur deployment mereka sendiri harus meminta mitra OEM mereka untuk register KPI per-deployment, yang kami hasilkan dalam 14 hari setelah ekspor data. Portal OEM menyimpan data selama 18 bulan secara default, dapat diperpanjang hingga 7 tahun untuk deployment tier-2 EU AI Act.
7. Cold-start: apa yang terjadi dalam 30 menit pertama
Ujian tersulit bagi algoritma adaptif adalah 30 menit pertama setelah dibuka dari kemasan. Pada jendela tersebut, algoritma memiliki 0 data mengenai anak dan harus menebak. Pendekatan kami berupa cold-start 5 langkah: langkah 1 (0-5 mnt) mengkalibrasi pronunciation scorer perangkat ke suara anak dengan meminta anak membaca 6 kata kalibrasi; langkah 2 (5-15 mnt) menjalankan placement quiz 18 kata di seluruh grafik kurikulum untuk memperkirakan pengetahuan awal; langkah 3 (15-25 mnt) menetapkan anak ke pita kesulitan berdasarkan placement; langkah 4 (25-30 mnt) menyajikan set halaman pertama "stretch + challenge + review". Data lapangan: 86% anak mencapai langkah 4 pada sesi pertama; 14% memerlukan sesi kedua karena kalibrasi suara langkah 1 dilewati atau gagal.
Desain cold-start didokumentasikan dalam arsitektur firmware reading pen dan dipublikasikan dalam OEM SDK.
8. Hasil kelancaran membaca: 8 siswa tambahan per kelas
Kelancaran membaca diukur dalam words-correct-per-minute (WCPM) pada teks sesuai tingkat kelas. Pilot multi-region kami 2025-2026 menunjukkan bahwa anak-anak yang menggunakan reading pen L5 dengan adaptive learning mengalami peningkatan 18,4-26,6 WCPM selama intervensi 12 minggu, dibandingkan kelompok kontrol menggunakan reading pen non-adaptif yang meningkat 9,4-13,2 WCPM. Ukuran efek adalah 0,34 standar deviasi, yang oleh What Works Clearinghouse diterjemahkan sebagai "sedang hingga besar" dalam riset pendidikan. Pada kelas berisi 100 siswa, ukuran efek tersebut memindahkan 8 siswa tambahan dari "di bawah tingkat kelas" menjadi "sesuai atau di atas tingkat kelas" pada tes akhir. Angka tersebut adalah metrik paling relevan untuk pengadaan di seluruh argumen 3.000 kata ini.


9. Konsekuensi keterlibatan: bagaimana adaptive mendorong durasi sesi
Durasi dan frekuensi sesi adalah indikator utama dari setiap intervensi membaca. Dalam pilot multi-region 2026 terhadap 4.800 anak di Brasil, Korea, Arab Saudi, Spanyol, dan AS, anak median yang menggunakan L5 dengan adaptive learning mencatat 5,4 sesi per minggu masing-masing 14,8 menit, dibandingkan 3,2 sesi per minggu masing-masing 11,6 menit untuk kelompok kontrol B1. Efek gabungannya adalah 1,69x menit membaca aktif lebih banyak per minggu. Alasannya jelas: indikator 4-state mencegah frustrasi, dan grafik kurikulum mencegah kebosanan. Frustrasi dan kebosanan adalah dua alasan utama anak meninggalkan tutor membaca.
Tips pembeli: Abandonment adalah pembunuh diam-diam program membaca di sekolah. Jika pembeli bertanya "berapa sesi per minggu yang akan diselesaikan anak rata-rata," jawabannya adalah 5,4 untuk L5 dengan adaptive learning dan 3,2 untuk B1 tanpa. Kalikan dengan tahun ajaran 30 minggu dan anak L5 mendapat 162 sesi versus 96 sesi untuk anak B1.
10. Pembelajar multibahasa dan bilingual: apa yang dilakukan algoritma secara berbeda
[perbaiki: kontaminasi han — keluarkan hanya skrip asli Bahasa Indonesia; hapus setiap karakter skrip asing] Seorang pelajar dwibahasa Inggris–Spanyol menggunakan dua paket bahasa secara bersamaan: satu untuk kosa kata Inggris dan satu untuk kosa kata Spanyol. Algoritma ini mempertahankan dua vektor keadaan secara bersamaan dan menjalankan lapisan transfer antar-bahasa yang mendeteksi interferensi lintas bahasa (misalnya, pelajar Inggris yang berbahasa Spanyol sering mencampuradukkan /v/ dan /b/). Ketika interferensi terdeteksi, algoritma akan menurunkan tingkat positif palsu pada penilaian pelafalan untuk fonem yang terdampak dan menyuntikkan latihan diskriminasi fonem yang ditargetkan. Data lapangan: pelajar dwibahasa dalam kelompok K7-Spanish menunjukkan peningkatan diskriminasi fonem 22% lebih cepat dibandingkan pelajar monolingual Inggris pada periode yang sama.
11. Edge case yang ditangani algoritma
Tiga edge case layak mendapat paragraf masing-masing. (a) Pembaca berbakat: anak yang membaca 2,5 tingkat kelas di atas tingkat enrollment-nya menghabiskan grafik K7-grade-1 dalam 4-6 minggu. Algoritma mendeteksi hal ini dan membuka kunci grafik grade-2 secara otomatis; jika grafik grade-2 juga habis dalam 6 minggu, ia membuka kunci grafik grade-3 dan menampilkan lencana "above grade level" kepada orang tua. (b) Pembaca yang kesulitan: anak dengan speech-sound disorder mencapai pola frustrasi (mastery <40% setelah 30 percobaan pada keterampilan yang sama). Algoritma menjeda progression, menampilkan sorotan tingkat fonem kepada orang tua, dan merekomendasikan evaluasi oleh speech-language pathologist. Kami tidak mengumpulkan data sorotan kecuali orang tua secara eksplisit menyetujui. (c) Pembaca yang tidak konsisten: anak yang jumlah sesi mingguannya berfluktuasi sebesar ±35% muncul dengan varians mastery >0,4 SD. Algoritma melakukan rollback ke state mastery konsisten terakhir dan menjalankan ulang placement quiz; ini melindungi anak dari persepsi kehilangan progres.
12. Integrasi dengan kurikulum sekolah
Reading pen adalah periferal; nilainya bergantung pada kurikulum yang dilayaninya. Reading pen kami 2026 terintegrasi dengan content pack penerbit melalui dua format: (a) format .bookpack, yaitu bundel terkompresi berisi tabel OID, gambar halaman, MP3 audio, dan node grafik kurikulum dalam format .dot; (b) live-link API, yang menghubungkan portal OEM ke content-management system penerbit dan menarik kosakata baru setiap minggu. Program sekolah 5.000 unit biasanya di-deploy dengan satu .bookpack per tingkat per semester, yaitu 10 bookpack untuk deployment K-5. Setiap bookpack berukuran 380 MB-1,4 GB dan dikirimkan sebagai stik USB-C atau unduhan Wi-Fi.
13. Selubung privasi data adaptive learning
Telemetri adaptive learning tunduk pada overlay regional yang sama dengan jalur audio LLM. EU/GDPR-K, US/COPPA, China/PIPL, Brazil/LGPD, Korea/PIPA, dan Singapura/PDPA semuanya berlaku. Portal OEM menyimpan data selama 18 bulan secara default, dengan perpanjangan 7 tahun tersedia untuk deployment AI Act tier-2. Portal mendukung permintaan ekspor data orang tua, yang mengembalikan bundel terkompresi berisi state vector per-anak dan telemetri per-sesi. Permintaan hapus data orang tua mengosongkan partisi per-anak dalam 14 hari. Kami telah mengirimkan OEM governance pack yang mencakup pemberitahuan privasi, alur layar persetujuan orang tua, peta data-residency regional, dan daftar kontrak sub-processor per-region. Daftar kontrak tersebut sama dengan yang dirujuk dalam reading pen AI integration roadmap.
14. Rencana proyek OEM untuk reading pen adaptive learning
| Phase | Duration | Deliverable |
|---|---|---|
| Discovery | 2 weeks | RFP gap analysis, content audit |
| Algorithm tuning | 4 weeks | Curriculum graph import, BKT fit, custom benchmark run |
| Telemetry integration | 3 weeks | OEM portal, parent/teacher dashboards |
| Beta deployment | 4 weeks | 50 pens, 5 classrooms, KPI register |
| Full production | 6 weeks | Container build, AQL II acceptance |
| Total timeline | 19 weeks | 5,000-unit minimum for OEM |
15. Ringkasan referensi dan keputusan
Ringkasan keputusan singkat. Pilih L5 untuk pembelajaran adaptif dengan analitik cloud opsional; pilih K7 atau Q6 untuk pembelajaran adaptif dengan anggaran terbatas; pilih KF1 untuk program dwibahasa. Hindari B1, B2, F8, dan P2 untuk pembelajaran adaptif karena tidak memiliki NPU. Gunakan lencana PenLitEval sebagai kriteria penerimaan dalam RFQ. Padukan keputusan algoritmik dengan programOem Reading Pensprogram dan Reading Pen AI Integration Roadmap untuk kategori yang lebih luas. Untuk penerbit, titik masuknya adalahOdm Reading Pens, yang mencakup perangkat content-pack.
Bacaan Terkait
- Reading pen AI integration roadmap 2024-2026
- Reading pen offline TTS versus cloud API tradeoffs
- Reading pen LLM on-device deployment
- Reading pen firmware architecture explained
- Reading pen application in early childhood literacy
- Reading pen application in elementary classroom
- K7 reading pen specification guide
- Reading pen private label starter guide