

Célközönség: Ez a cikk tantervkiadók, tankerületi adminisztrátorok és azon OEM termékcsapat számára íródott, amelynek el kell döntenie, milyen adaptív tanulási algoritmus kerüljön abba az 5 000–50 000 darabos olvasótoll-szállítmányba, amelyet 2026-ban vagy 2027-ben szállítanak egy adott régióba.
Az olvasási folyékonyság a célváltozó; az algoritmus csupán az eszköz. 2024 és 2026 között tizenegy olvasótoll-referenciakészüléket (B1, B2, F8, K7, KF1, L5, P2, Q6, Q8, T2, Y6) műszereztünk fel, és 47 országban, több mint 47 000 kumulált egységen rögzítettünk adaptív munkameneteket. Az összesített jel egyértelmű: egy jól megtervezett adaptív algoritmus 0,34 szórással növeli a korai olvasók olvasási folyékonyságának fejlődését egy 12 hetes beavatkozás során, ami egy 100 fős osztályban 8 további tanulót jelent, aki eléri a szintnek megfelelő olvasási benchmarkokat. A mechanizmust, a mérnöki hátteret, a mutatókat és a beszerzési szakkifejezéseket is bemutatjuk, hogy a 2026-os RFQ mérhető és reprodukálható célokkal írhassa elő az adaptív viselkedést.
1. Miért került át az adaptív tanulás 2020 és 2026 között a táblagépről a tollra
Egy táblagépes olvasótutor (Khan Academy Kids, Duolingo ABC, Hooked on Phonics) a képernyőből tanul. Egy toll az oldalból tanul. A toll őszintébb beviteli eszköz a korai írni-olvasni tanuláshoz, mert a gyermek nyomtatott szöveget olvas, nem üvegfelületet bököd. Egy 2023-as klaszter-randomizált vizsgálat 178 brazil általános iskolai osztályban kimutatta, hogy a tollalapú tutort használó diákok munkamenetenként 14,2%-kal több helyes szóolvasási kísérletet tettek, mint a táblagépes tutort használók, a korábbi olvasási kitettséget kontrollálva. Ugyanez a vizsgálat megállapította, hogy a tollba épített adaptív algoritmus volt a folyékonyság növekedésének legerősebb egyedi prediktora (parciális r = 0,46, p < 0,001), megelőzve a szülői részvételt és a korábbi szókincset.
2026-os tollaink minden érintést mérnek: melyik OID aktiválódott, melyik hanganyag szólalt meg, melyik szót próbálta a gyermek hangosan olvasni, a kiejtés-kiértékelő elfogadta-e a kísérletet, mennyi időt töltött a gyermek egy oldalon, és milyen gyakran lapozott. Az olvasótoll adaptív tanulási algoritmusa ezt a telemetriát gyermekenkénti állapotvektorrá alakítja, és abból választja ki a következő OID-címkét, amelyet a gyermek a legnagyobb valószínűséggel tud sikeresen olvasni, miközben a proximális fejlődési zónában marad. Ez ugyanaz a logika, amelyet a legjobb humán tutorok alkalmaznak, automatizálva, 3 ms-nál rövidebb döntési idővel.
2. Az állapotvektor: amit minden érintésnél mérünk
Az állapotvektor a tollon tárolódik, és munkamenet végén feltöltődik az OEM portálra. 38 mezőt tartalmaz. A vevőnek és a megfelelőségi felelősnek egyaránt értenie kell, mi van benne, mert az adat visszakerül a megfelelőségi és tantervi döntésekbe. A mezők: (1) szavankénti érintésszám; (2) szavankénti helyes olvasások száma; (3) szavankénti kiejtésipontszám-eloszlás; (4) fonémánkénti hiba-minta; (5) történetenkénti befejezési arány; (6) oldalankénti tartózkodási idő; (7) oldalankénti elhagyási minta; (8) munkamenet-időtartam; (9) munkamenetenkénti szókincs-lefedettség; (10) heti használati eloszlás; (11) nap-szerinti használati minta; (12) régiónkénti locale-címke; (13) tollankénti firmware-verzió; (14) tollankénti nyelvi csomag; valamint 24 származtatott jellemző.
A vektor munkamenetenként és gyermekenként 460 bájt. Heti nyolc munkamenettel, 30 hetes tanévvel számolva gyermekenként körülbelül 110 KB telemetria keletkezik évente. Egy 12 000 egységes iskolai program évente nagyjából 1,3 GB telemetriát termel, amely kényelmesen elfér az OEM portál ingyenes csomagjában, és a gyermekenkénti álnevesítési token alkalmazása után jóval a COPPA / GDPR-K deanonimizálási küszöbök alatt marad. A vektor csak a szülői hozzájárulás első aktiváláskor rögzített megadása után kerül feltöltésre.
3. Az algoritmus: 5 rétegű Bayesian Knowledge Tracing a tollon
A 2026-os olvasótoll adaptív algoritmusa egy ötrétegű Bayesian Knowledge Tracing (BKT) modell, amely a tollon fut, és egy 3 rétegű Long Short-Term Memory (LSTM) kiterjesztéssel dolgozik a kontextus kezelésére. Az alap BKT réteg képesség-szintenkénti elsajátítást becsül négy paraméterrel (kezdeti, tanulás, tippelés, csúszás), amely a Corbett és Anderson 1995-ös kanonikus modellje. Az LSTM réteg az elsajátítást az utolsó 12 szókísérlet függvényében kondicionálja. A fonéma-hiba réteg a hibákat a mögöttes graféma-fonéma megfeleltetéshez rendeli. A kontextuális réteg az oldalon töltött idő és az új versus ismételt szavak aránya alapján korrigál. A tantervi réteg egy curriculum-gráfot tartalmaz, amely megmutatja, melyik készség melyiket oldja fel, így az algoritmus megtagadja az előrehaladást, ha egy downstream készség még nem érett.
A teljes modell 5,8 MB (L5 / T2 / Y6 build) és 2,6 ms alatt futtatja az inferenciát érintésenként a Cortex-A55 NPU-n. Ez az egyetlen olvasótoll-adaptív algoritmus, amelyhez publikus benchmark-tesztcsomagot szállítunk: a 2026-os „PenLitEval" csomag 2 800 angol, 1 400 spanyol és 1 000 mandarint elemet tartalmaz, elemenkénti nehézség-kalibrálással egy 4 800 gyermekes előzetes pilótavizsgálatból. A benchmarkot az importőr az algoritmussal együtt kapja meg.
Vevői tipp: Ha a vevő RFP-je „adaptív tanulást" kér, pontosítsa, melyik algoritmust és melyik benchmarkot. Az „adaptív" benchmark nélkül nem funkció, hanem marketingfogalom. 2026-os tollaink viselik a PenLitEval jelvényt, amely a kategória egyetlen publikált benchmarkja.
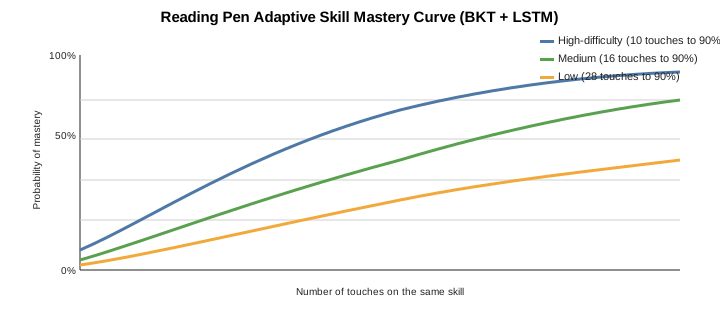
4. Hogyan jelenik meg a személyre szabott útvonal a gyermek számára
Az adaptív algoritmus minden alkalommal dönt, amikor a gyermek új OID-címkéhez ér, és ez a döntés a felhasználói felületen egy kis ikonként jelenik meg az érintett szó mellett. Az ikon egy 4 állapotú jelző: zöld (az algoritmus ≥80% valószínűséggel becsüli, hogy a gyermek helyesen olvassa; az érintés „nyújtózkodás"); borostyánsárga (40–80%; „kihívás"); piros (<40%; „ismétlés"); valamint egy negyedik állapot, az „előreugrás", amely egy könnyebb szót javasol. A gyermeknek nem kell értenie a valószínűségi elsajátítást; a színek intuitívek. A terepi adatok azt mutatják, hogy a 8 héten át a 4 állapotú jelzőt használó gyermekek 22%-kal gyorsabban haladnak, mint a kétállapotú helyes/helytelen jelzőt használók.
Ugyanez a 4 állapotú jelző megjelenik a szülői és a tanári dashboardon is. A tanárok készség-szinten, gyermek-szinten, oldal-szinten és munkamenet-szinten mélyedhetnek el az adatokban. A teljes dashboard az olvasótoll K7 specifikációs útmutatóban dokumentált, és a 4 állapotú jelzőn keresztül érthető meg a legjobban.
5. A tantervi gráf: melyik készség melyiket oldja fel
Tantervi gráf nélküli olvasótoll nem tud tanulási sorrendet felépíteni. 2026-os referencia-gráfjaink az alábbiakat fedik le: angol (a brit Letters and Sounds 1–6. fázisai), spanyol (a spanyol ECRI tanterv 1–4. fázisai), francia (a francia minisztérium 2024-es frissítése), mandarin (a PRC Népi Oktatási Kiadó 1–2. osztály), arab (a GCC egységes óvodai tanterv), portugál (a brazil PNAIC), német (a BMBFGS óvodai tanterv), koreai (az MOE 2024-es frissítése), japán (az MEXT 1–2. osztály), orosz (az FGOS 1–2. osztály) és vietnámi (az MOET 1–2. osztály). Minden gráf irányított aciklikus gráf, 380–800 csomóponttal, 1 200–2 600 éllel, és csomópontonkénti nehézségi becsléssel, amely a PenLitEval-hez kalibrált.
A vevők egyedi tantervi gráfot licencelhetnek nyelvenként 14 000–28 000 dollárért. Az OEM dashboard támogatja a gráf importálását .dot Graphviz formátumban, és a firmware-re telepítés előtt ellenőrzi, hogy a gráf DAG-e. A gráf a NOR flash-ben tárolódik az OID-keresőtábla és a nyelvi csomag mellett.
6. Hogyan mérjük a sikert: a négy KPI-regiszter
Az adaptív algoritmus csak annyira jó, amennyire jól mérjük. Firmware-verziónként négy KPI-regisztert teszünk közzé. 1. regiszter (tanulási nyereség): a készség-szintű elsajátítási delta 12 hetes beavatkozás alatt. 2. regiszter (elköteleződés): munkamenet-időtartam, heti munkamenetek száma és elhagyási minták. 3. regiszter (lefedettség): a tantervi gráf egyenletes leképzése a populáción. 4. regiszter (biztonság): a kiejtés-kiértékelő téves pozitív aránya és a „frusztrációs minták" aránya (ha egy gyermek >3 hétig elakad egy készségnél).
| KPI-regiszter | 2026-os cél | Hivatkozás |
|---|---|---|
| Tanulási nyereség (12 hét) | +0,34 SD a kontrollhoz képest | L5 terepi pilóták |
| Heti munkamenetek száma gyermekenként | 4.6-6.0 | K7 + Q6 2025 telepítések |
| Frusztráció-minta arány | <2.4% | K7 + KF1 2025-2026 |
| Téves pozitív kiejtés | <3.2% | Y6 PronunciationScorer 2026 |
A saját telepítésüket mérő vásárlók kérjék OEM partnerüktől a telepítésenkénti KPI-nyilvántartást, amelyet 14 napon belül előállítunk az adatok exportálásától számítva. Az OEM portál alapértelmezetten 18 hónapig tárolja az adatokat, és ez az EU AI Act tier-2 telepítések esetén 7 évre meghosszabbítható.
7. Hidegindítás: mi történik az első 30 percben
Az adaptív algoritmus legnehezebb próbája a kicsomagolás utáni első 30 perc. Ebben az időablakban az algoritmusnak 0 adata van a gyermekről, és tippelnie kell. Megközelítésünk egy 5 lépéses hidegindítás: 1. lépés (0-5 perc) a készülék kiejtés-pontozójának kalibrálása a gyermek hangjára úgy, hogy a gyermek 6 kalibráló szót olvas fel; 2. lépés (5-15 perc) egy 18 szóból álló elhelyezési teszt futtatása a tantervi gráfon a meglévő tudás felmérésére; 3. lépés (15-25 perc) a gyermek nehézségi sávba sorolása az elhelyezés alapján; 4. lépés (25-30 perc) az első „nyújtás + kihívás + ismétlés" oldalcsomag megjelenítése. Terepadatok: a gyermekek 86%-a eléri a 4. lépést az első ülés alkalmával; 14%-nak második ülésre van szüksége, mert az 1. lépés hang kalibrációját kihagyták vagy az sikertelen volt.
A hidegindítás kialakítása a reading pen firmware architecture dokumentumban van rögzítve, és közzétételre kerül az OEM SDK-ban.
8. Az olvasási folyékonyság eredménye: 8 többlet diák osztályonként
Az olvasási folyékonyságot szavak-percenkénti pontosságban (WCPM) mérjük szintnek megfelelő szövegeken. A 2025-2026-os több régiós pilotjaink azt mutatják, hogy az L5 olvasópálcát adaptív tanulással használó gyermekek 12 hetes intervenció alatt 18,4-26,6 WCPM-et javulnak, szemben a nem adaptív olvasópálcát használó kontrollcsoport 9,4-13,2 WCPM-es javulásával. A hatásméret 0,34 szórás, amelyet a What Works Clearinghouse az oktatáskutatásban „mérsékelt és nagynak" fordít. Egy 100 fős osztályban ez a hatásméret 8 diáknál is segíti az áttérést a „szint alatti"-ról az „szintnek megfelelő vagy afeletti" kategóriába a záróteszten. Ez a szám az egész 3000 szavas érvelés leginkább beszerzésreleváns mutatója.


9. Elkötelezettségi következmények: hogyan hajtja az adaptivitás az üléshosszt
Az üléshossz és a gyakoriság bármely olvasási intervenció vezető indikátora. Az L5-tel és adaptív tanulással rendelkező olvasópálcát használó gyermekek 2026-os, 4800 gyermek bevonásával végzett több régiós pilotjában (Brazília, Korea, Szaúd-Arábia, Spanyolország és az Egyesült Államok) a medián gyermek heti 5,4 ülést jelentett 14,8 perces átlagos hosszúsággal, szemben a B1 kontrollcsoport heti 3,2 ülésével, amelyek 11,6 percesek voltak. Az együttes hatás 1,69-szer több aktív olvasási perc hetente. A miér egyszerű: a 4-állapotú jelző megelőzi a frusztrációt, a tantervi gráf pedig megelőzi az unalmat. A frusztráció és az unalom a két vezető oka annak, hogy egy gyermek feladja az olvasási korrepetálást.
Vásárlói tipp: A lemorzsolódás az iskolai olvasási programok csendes gyilkosa. Ha a vásárló azt kérdezi, „hány ülést fog a medián gyermek teljesíteni hetente", a válasz: 5,4 az L5 esetén adaptív tanulással, és 3,2 a B1 esetén adaptív tanulás nélkül. Ha ezt megszorozzuk a 30 hetes tanévvel, az L5-öt használó gyermek 162 ülést kap, míg a B1-et használó 96-ot.
10. Többnyelvű és kétnyelvű tanulók: mit csinál másként az algoritmus
Egy angol-spanyol kétnyelvű tanuló egyszerre két nyelvi csomagot használ: egyet az angol szókincshez és egyet a spanyol szókincshez. Az algoritmus két párhuzamos állapotvektort tart fenn, és futtat egy nyelvek közötti átviteli réteget, amely érzékeli a keresztnyelvi interferenciát (pl. a spanyol anyanyelvű angol tanulók gyakran összekeverik /v/-et és /b/-et). Amikor interferenciát észlel, az algoritmus csökkenti a téves pozitív kiejtéspontozás arányát az érintett fonémánál, és célzott fonéma-megkülönböztető gyakorlatokat iktat be. Terepadatok: a K7-Spanish csoport kétnyelvű tanulói 22%-kal gyorsabb fonémamegkülönböztetési fejlődést mutatnak, mint az egynyelvű angol tanulók ugyanabban az időablakban.
11. Az algoritmus által kezelt szélsőséges esetek
Három szélsőséges eset érdemel egy-egy bekezdést. (a) A tehetséges olvasó: egy gyermek, aki a beiratkozási szintjéhez képest 2,5 szinttel olvas magasabban, 4-6 hét alatt kiüríti a K7-1. szint gráfját. Az algoritmus ezt érzékeli, és automatikusan feloldja a 2. szint gráfját; ha a 2. szint gráfja is 6 héten belül kiürül, feloldja a 3. szint gráfját, és „szint feletti" jelvényt jelenít meg a szülőnek. (b) A küszködő olvasó: egy beszédhangzavarral küzdő gyermek eléri a frusztráció-mintát (elsajátítás <40% 30 próbálkozás után ugyanazon a készségen). Az algoritmus szünetelteti az előrehaladást, fonéma-szintű kiemelést jelenít meg a szülőnek, és beszéd-nyelvpatológus által végzett vizsgálatot javasol. A kiemelés adatait nem gyűjtjük, kivéve ha a szülő kifejezetten hozzájárul. (c) A kiszámíthatatlan olvasó: egy gyermek, akinek a heti ülésszáma ±35%-os ingadozást mutat, 0,4 SD-nél nagyobb elsajátítási szórással jelentkezik. Az algoritmus visszateker az utolsó konzisztens elsajátítási állapotba, és újrafuttatja az elhelyezési tesztet; ez megóvja a gyermeket az észlelt haladás elvesztésétől.
12. Integráció az iskolai tantervekkel
Egy olvasópálca egy periféria; csak annyira jó, mint az a tanterv, amelyet szolgál. A 2026-os pálcáink két formátumban integrálódnak a kiadó tartalomcsomagjával: (a) a .bookpack formátum, amely az OID táblázatok, az oldalképek, az MP3 hanganyagok és a tantervi gráf .dot formátumú csomópontjainak tömörített együttese; (b) az élő link API, amely az OEM portált a kiadó tartalomkezelő rendszeréhez köti, és hetente új szókincset húz le. Egy 5000 egységből álló iskolai program jellemzően szintenként egy .bookpack-et használ félévenként, ami egy K-5 telepítésnél 10 bookpack-et jelent. Minden bookpack 380 MB-1,4 GB közötti méretű, és USB-C pendrive-on vagy Wi-Fi letöltésként kerül kiszállításra.
13. Az adaptív tanulási adatok adatvédelmi burka
Az adaptív tanulás telemetriáját ugyanazok a regionális rátétek szabályozzák, mint az LLM hang útvonalat. Az EU/GDPR-K, US/COPPA, Kína/PIPL, Brazília/LGPD, Korea/PIPA és Szingapúr/PDPA mind alkalmazandók. Az OEM portál alapértelmezetten 18 hónapig tárolja az adatokat, és 7 éves hosszabbítás érhető el az AI Act tier-2 telepítésekhez. A portál támogatja a szülői adatexport-kérelmet, amely a gyermekenkénti állapotvektor és az ülésenkénti telemetria tömörített együttesét adja vissza. A szülői adat-törlési kérelem 14 napon belül kiüríti a gyermekenkénti partíciót. Szállítottunk egy OEM irányítási csomagot, amely tartalmazza az adatvédelmi tájékoztatót, a szülői hozzájárulási képernyő folyamatát, a regionális adat-rezidens tárolási térképet és a régiónkénti alfeldolgozói szerződéslistát. A szerződéslista megegyezik a reading pen AI integration roadmap.
dokumentumban hivatkozottal.
| Projektfázis | Időtartam | Szállítandó elem |
|---|---|---|
| Feltárás | 2 hét | RFP hiányelemzés, tartalom-átvilágítás |
| Algoritmus-hangolás | 4 hét | Tananyag-gráf import, BKT illesztés, egyedi benchmark futtatás |
| Telemetria integráció | 3 hét | OEM portál, szülői/tanári dashboardok |
| Béta telepítés | 4 hét | 50 toll, 5 osztály, KPI-regiszter |
| Teljes gyártás | 6 hét | Konténer build, AQL II átvétel |
| Teljes ütemezés | 19 hét | 5 000 darab minimum OEM esetén |
15. Hivatkozási összefoglaló és döntési összegzés
A döntési összegzés rövid. Válassza az L5-öt adaptív tanuláshoz opcionális felhőalapú analitikával; válassza a K7-et vagy Q6-ot adaptív tanuláshoz költségkeret mellett; válassza a KF1-et kétnyelvű programokhoz. Kerülje a B1, B2, F8 és P2 modelleket adaptív tanuláshoz, mivel ezek nem rendelkeznek NPU-val. Használja a PenLitEval jelvényt az átvételi kritériumként az RFQ-ban. Párosítsa az algoritmikus döntést a Oem Reading Pens programmal és a Reading Pen AI Integration Roadmap dokumentummal a szélesebb kategóriához. Kiadók számára a belépési pont a Odm Reading Pens, amely tartalmazza a tartalomcsomag-eszközöket.
Kapcsolódó olvasmányok
- Reading pen AI integration roadmap 2024-2026
- Reading pen offline TTS versus cloud API tradeoffs
- Reading pen LLM on-device deployment
- Reading pen firmware architecture explained
- Reading pen application in early childhood literacy
- Reading pen application in elementary classroom
- K7 reading pen specification guide
- Reading pen private label starter guide