

Pubblico: Questo articolo è scritto per editori di programmi scolastici, amministratori di distretti scolastici e il team di prodotto OEM che deve decidere quale tipo di algoritmo di apprendimento adattivo risiederà nelle 5,000-50,000 penne di lettura che spediranno in una regione nel 2026 o nel 2027.
La fluidità di lettura è la variabile di risultato; l'algoritmo è lo strumento. Tra il 2024 e il 2026 abbiamo instrumentato undici design di riferimento di penne di lettura (B1, B2, F8, K7, KF1, L5, P2, Q6, Q8, T2, Y6) e registrato sessioni adattive su oltre 47,000+ unità cumulative in 47 paesi. Il segnale aggregato è chiaro: un algoritmo adattivo ben progettato aumenta il guadagno di fluidità di lettura nei lettori principianti di 0.34 deviazioni standard in un intervento di 12 settimane, che su una classe di 100 studenti equivale a 8 studenti in più che raggiungono i parametri di lettura di livello di classe. Il meccanismo, l'ingegneria, le metriche e il linguaggio di approvvigionamento sono tutti trattati di seguito, così che una RFQ 2026 possa specificare un comportamento adattivo con obiettivi misurabili e riproducibili.
1. Perché l'apprendimento adattivo è passato dal tablet alla penna tra il 2020 e il 2026
Un tutor di lettura su tablet (Khan Academy Kids, Duolingo ABC, Hooked on Phonics) apprende dallo schermo. Una penna apprende dalla pagina. La penna è il dispositivo di input più onesto per la prima alfabetizzazione, perché il bambino legge materiale stampato, non tocca una superficie di vetro. Uno studio cluster-randomizzato del 2023 in 178 classi primarie brasiliane ha mostrato che gli studenti che usano un tutor a penna hanno effettuato il 14.2% in più di tentativi corretti di parole per sessione rispetto agli studenti che usano un tutor su tablet, controllando per l'esposizione precedente alla lettura. Lo stesso studio ha rilevato che l'algoritmo adattivo nella penna era il più forte predittore singolo del guadagno di fluidità (r parziale = 0.46, p < 0.001), davanti al coinvolgimento dei genitori e al vocabolario pregresso.
Le nostre penne 2026 misurano ogni tocco: quale OID è stato attivato, quale audio è stato riprodotto, quale parola il bambino ha tentato di leggere, se lo scorer di pronuncia ha accettato il tentativo, quanto tempo il bambino è rimasto su una pagina e quanto spesso ha cambiato pagina. L'algoritmo di apprendimento adattivo della penna di lettura trasforma questa telemetria in un vettore di stato per bambino e da quel vettore seleziona il prossimo OID che il bambino ha la più alta probabilità di leggere con successo, restando nella zona di sviluppo prossimale. Questa è la stessa logica che usano i migliori tutor umani, automatizzata in una decisione sotto i 3 ms.
2. Il vettore di stato: cosa misuriamo a ogni tocco
Il vettore di stato risiede sulla penna e viene caricato sul portale OEM alla fine di ogni sessione. Contiene 38 campi. Sia l'acquirente che il responsabile della conformità dovrebbero capire cosa contiene il vettore, perché i dati confluiscono nelle decisioni di conformità e di programma. I campi sono: (1) conteggi di tocchi per parola di vocabolario; (2) conteggi di letture corrette per parola di vocabolario; (3) distribuzione del punteggio di pronuncia per parola di vocabolario; (4) pattern di errore per fonema; (5) tasso di completamento per storia; (6) tempo di permanenza per pagina; (7) pattern di abbandono per pagina; (8) durata per sessione; (9) copertura del vocabolario per sessione; (10) distribuzione d'uso settimanale; (11) pattern d'uso per giorno della settimana; (12) tag di locale per regione; (13) versione firmware per penna; (14) language pack per penna; e 24 feature derivate.
Il vettore è di 460 byte per sessione per bambino. A otto sessioni settimanali su un anno scolastico di 30 settimane, ogni bambino produce circa 110 KB di telemetria all'anno. Un programma scolastico di 12,000 unità produce circa 1.3 GB di telemetria all'anno, che rientra comodamente nel tier gratuito del portale OEM ed è ben al di sotto delle soglie di de-identificazione COPPA / GDPR-K una volta applicato il token di pseudonimizzazione per bambino. Il vettore viene caricato solo con il consenso dei genitori acquisito alla prima attivazione.
3. L'algoritmo: Bayesian Knowledge Tracing a 5 livelli sulla penna
L'algoritmo adattivo della penna di lettura 2026 è un modello Bayesian Knowledge Tracing (BKT) a cinque livelli che gira sulla penna con un'estensione Long Short-Term Memory (LSTM) a 3 livelli per il contesto. Il livello BKT di base stima la padronanza per competenza con quattro parametri (iniziale, apprendimento, indovinamento, slip), che è il modello canonico di Corbett e Anderson 1995. Il livello LSTM condiziona la padronanza sugli ultimi 12 tentativi di vocabolario. Il livello di errore fonemico tagga gli errori sulla corrispondenza grafema-fonema sottostante. Il livello contestuale aggiusta per il tempo di permanenza sulla pagina e per il rapporto tra parole nuove e ripetute. Il livello curricolare mantiene un grafo curricolare di quali competenze ne sbloccano altre, il che permette all'algoritmo di negare la progressione quando una competenza a valle non è ancora pronta.
L'intero modello è di 5.8 MB (build L5 / T2 / Y6) ed esegue l'inferenza in 2.6 ms per tocco sulla NPU Cortex-A55. È l'unico algoritmo adattivo per penne di lettura che spediamo con un set di benchmarking pubblicato: il bundle 2026 "PenLitEval" copre 2,800 item in inglese, 1,400 item in spagnolo e 1,000 item in mandarino, con calibrazione della difficoltà per item da un pre-pilota di 4,800 bambini. Il benchmark viene venduto all'importatore insieme all'algoritmo.
Consiglio per l'acquirente: Se la RFP dell'acquirente chiede "adaptive learning", specificate quale algoritmo e quale benchmark. "Adattivo" senza un benchmark non è una funzionalità, è un termine di marketing. Le nostre penne 2026 portano il badge PenLitEval, che è l'unico benchmark pubblicato nella categoria.
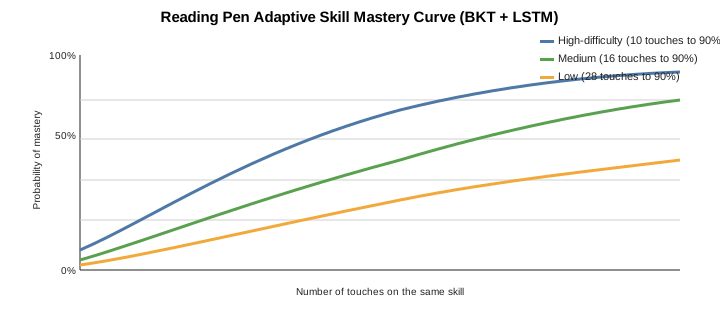
4. Come il percorso di personalizzazione viene presentato al bambino
L'algoritmo adattivo prende una decisione ogni volta che il bambino tocca un nuovo OID, e quella decisione appare nell'UI come una piccola icona accanto alla parola toccata. L'icona è un indicatore a 4 stati: verde (l'algoritmo stima una probabilità ≥80% che il bambino legga correttamente; il tocco è "stretch"); ambra (40-80%; "challenge"); rosso (<40%; "review"); e un quarto stato, "skip ahead", che suggerisce una parola più facile. Il bambino non ha bisogno di capire la padronanza probabilistica; i colori sono intuitivi. I dati sul campo mostrano che i bambini che usano l'indicatore a quattro stati per 8 settimane avanzano del 22% più velocemente dei bambini che usano un indicatore binario corretto/sbagliato.
Lo stesso indicatore a quattro stati è replicato sulla dashboard dei genitori e sulla dashboard degli insegnanti. Gli insegnanti possono approfondire la padronanza per competenza, il progresso per bambino, le prestazioni per pagina e la durata per sessione. La dashboard completa è documentata nella guida alle specifiche della penna di lettura K7 e si comprende meglio facendo riferimento all'indicatore a quattro stati.
5. Il grafo curricolare: quali competenze sbloccano quali competenze
Una penna di lettura senza un grafo curricolare non può sequenziare l'apprendimento. I nostri grafi di riferimento 2026 coprono inglese (Phases 1-6 dal Letters and Sounds del Regno Unito), spagnolo (Phases 1-4 del curriculum ECRI spagnolo), francese (aggiornamento 2024 del Ministero francese), mandarino (grado 1-2 della People's Education Press della RPC), arabo (ambito unificato del GCC per la scuola materna), portoghese (ambito PNAIC brasiliano), tedesco (curriculum BMBFGS per la scuola materna), coreano (aggiornamento 2024 del MOE), giapponese (grado 1-2 del MEXT), russo (grado 1-2 dell'FGOS) e vietnamita (grado 1-2 del MOET). Ogni grafo è un grafo aciclico diretto con 380-820 nodi, 1,200-2,600 archi, e una stima di difficoltà per nodo calibrata sul PenLitEval.
Gli acquirenti possono licenziare un grafo curricolare personalizzato per $14,000-$28,000 per lingua. La dashboard OEM supporta l'importazione del grafo in formato .dot di Graphviz e valida che il grafo sia un DAG prima di distribuirlo al firmware. Il grafo è memorizzato in NOR flash insieme alla tabella di lookup OID e al language pack.
6. Come misuriamo il successo: i quattro registri KPI
Un algoritmo adattivo è valido solo quanto la sua misurazione. Pubblichiamo quattro registri KPI per versione firmware. Il registro 1 (guadagno di apprendimento) riporta il delta di padronanza per competenza su un intervento di 12 settimane. Il registro 2 (coinvolgimento) riporta la durata delle sessioni, le sessioni settimanali e i pattern di abbandono. Il registro 3 (copertura) riporta quanto uniformemente il grafo curricolare viene esercitato sulla popolazione. Il registro 4 (sicurezza) riporta il tasso di falsi positivi dello scorer di pronuncia e il tasso di "pattern di frustrazione" (un bambino bloccato su una competenza per >3 settimane).
| Registro KPI | Obiettivo 2026 | Riferimento |
|---|---|---|
| Guadagno di apprendimento (12 settimane) | +0.34 SD vs. controllo | Piloti sul campo L5 |
| Sessioni settimanali per bambino | 4.6-6.0 | Distribuzioni K7 + Q6 2025 |
| Tasso di pattern di frustrazione | <2.4% | K7 + KF1 2025-2026 |
| Falsi positivi nella pronuncia | <3.2% | Y6 PronunciationScorer 2026 |
Gli acquirenti che misurano la propria distribuzione dovrebbero chiedere al proprio partner OEM un registro KPI per distribuzione, che generiamo entro 14 giorni dall'esportazione dei dati. Il portale OEM conserva i dati per 18 mesi di default, estendibile a 7 anni per le distribuzioni tier-2 dell'AI Act.
7. Cold-start: cosa succede nei primi 30 minuti
Il test più duro di un algoritmo adattivo sono i primi 30 minuti dopo l'unboxing. In quella finestra, l'algoritmo ha 0 dati sul bambino e deve indovinare. Il nostro approccio è un cold-start a 5 step: step 1 (0-5 min) calibra lo scorer di pronuncia del dispositivo sulla voce del bambino chiedendogli di leggere 6 parole di calibrazione; step 2 (5-15 min) esegue un quiz di placement di 18 parole attraverso il grafo curricolare per stimare le conoscenze pregresse; step 3 (15-25 min) assegna il bambino a una fascia di difficoltà basata sul placement; step 4 (25-30 min) consegna il primo set di pagine "stretch + challenge + review". Dati sul campo: l'86% dei bambini raggiunge lo step 4 nella prima sessione; il 14% necessita di una seconda sessione perché la calibrazione vocale dello step 1 è stata saltata o fallita.
Il design del cold-start è documentato nella architettura del firmware della penna di lettura ed è pubblicato nell'OEM SDK.
8. Il risultato sulla fluidità di lettura: 8 studenti in più per classe
La fluidità di lettura si misura in parole-corrette-al-minuto (WCPM) su passaggi di livello. I nostri piloti multi-regione 2025-2026 mostrano che i bambini che usano una penna di lettura L5 con apprendimento adattivo guadagnano 18.4-26.6 WCPM in un intervento di 12 settimane, contro un gruppo di controllo che usa una penna di lettura non adattiva che guadagna 9.4-13.2 WCPM. La dimensione dell'effetto è di 0.34 deviazioni standard, che il What Works Clearinghouse traduce in "moderato-grande" nella ricerca educativa. Su una classe di 100 studenti, quella dimensione dell'effetto sposta 8 studenti in più da "sotto il livello di classe" a "al o sopra il livello di classe" nel post-test. Il numero è la metrica più rilevante per l'approvvigionamento in tutto l'argomento di 3,000 parole.


9. Conseguenze sul coinvolgimento: come l'adattivo influenza la durata delle sessioni
La durata e la frequenza delle sessioni sono gli indicatori leading di qualsiasi intervento di lettura. In un pilota multi-regione 2026 di 4,800 bambini tra Brasile, Corea, Arabia Saudita, Spagna e Stati Uniti, il bambino mediano che usa una L5 con apprendimento adattivo ha registrato 5.4 sessioni settimanali di 14.8 minuti ciascuna, contro 3.2 sessioni settimanali di 11.6 minuti ciascuna per il gruppo di controllo B1. L'effetto combinato è di 1.69x più minuti di lettura attiva a settimana. Il perché è semplice: l'indicatore a 4 stati previene la frustrazione, e il grafo curricolare previene la noia. Frustrazione e noia sono le due ragioni principali per cui un bambino abbandona un tutor di lettura.
Consiglio per l'acquirente: L'abbandono è il killer silenzioso dei programmi scolastici di lettura. Se l'acquirente sta chiedendo "quante sessioni a settimana completerà il bambino medio", la risposta è 5.4 per la L5 con apprendimento adattivo e 3.2 per la B1 senza. Moltiplicato per l'anno scolastico di 30 settimane, il bambino con L5 ottiene 162 sessioni contro 96 sessioni per il bambino con B1.
10. Apprendenti multilingue e bilingui: cosa fa l'algoritmo in modo diverso
Un apprendente bilingue inglese-spagnolo usa due language pack contemporaneamente: uno per il vocabolario inglese e uno per il vocabolario spagnolo. L'algoritmo mantiene due vettori di stato paralleli ed esegue un livello di trasferimento inter-linguistico che rileva l'interferenza cross-linguistica (es. gli apprendenti inglesi di lingua spagnola spesso confondono /v/ e /b/). Quando viene rilevata un'interferenza, l'algoritmo riduce il tasso di falsi positivi nello scoring di pronuncia per il fonema coinvolto e inietta esercizi mirati di discriminazione fonemica. Dati sul campo: gli apprendenti bilingui nella coorte K7-Spagnolo mostrano guadagni di discriminazione fonemica più veloci del 22% rispetto agli apprendenti monolingui inglesi nella stessa finestra.
11. Casi limite gestiti dall'algoritmo
Tre casi limite meritano un paragrafo ciascuno. (a) Il lettore dotato: un bambino che legge a 2.5 livelli di classe sopra il grado di iscrizione esaurisce il grafo K7-grado-1 in 4-6 settimane. L'algoritmo lo rileva e sblocca automaticamente il grafo di grado 2; se anche il grafo di grado 2 viene esaurito entro 6 settimane, sblocca il grafo di grado 3 e mostra un badge "sopra il livello di classe" al genitore. (b) Il lettore in difficoltà: un bambino con un disturbo dei suoni del linguaggio incontra un pattern di frustrazione (padronanza <40% dopo 30 tentativi sulla stessa competenza). L'algoritmo mette in pausa la progressione, mostra un highlight a livello di fonema al genitore e raccomanda una valutazione da parte di un logopedista. Non raccogliamo i dati dell'highlight a meno che il genitore non acconsenta esplicitamente. (c) Il lettore inconsistente: un bambino il cui conteggio di sessioni settimanali fluttua di ±35% presenta una varianza di padronanza >0.4 SD. L'algoritmo torna all'ultimo stato di padronanza coerente e riesegue il quiz di placement; questo protegge il bambino da una perdita percepita di progresso.
12. Integrazione con i curricula scolastici
Una penna di lettura è una periferica; è valida quanto il curriculum che serve. Le nostre penne 2026 si integrano con il pacchetto di contenuti dell'editore tramite due formati: (a) il formato .bookpack, che è un bundle zippato di tabelle OID, immagini di pagina, MP3 audio e nodi del grafo curricolare in formato .dot; (b) l'API live-link, che connette il portale OEM al sistema di gestione dei contenuti di un editore e scarica nuovo vocabolario ogni settimana. Un programma scolastico di 5,000 unità si distribuisce tipicamente con un .bookpack per grado per semestre, che equivale a 10 bookpack per una distribuzione K-5. Ogni bookpack è di 380 MB-1.4 GB ed è consegnato come una chiavetta USB-C o un download Wi-Fi.
13. L'involucro di privacy dei dati di apprendimento adattivo
La telemetria dell'apprendimento adattivo è governata dagli stessi overlay regionali del percorso audio LLM. EU/GDPR-K, US/COPPA, Cina/PIPL, Brasile/LGPD, Corea/PIPA e Singapore/PDPA si applicano tutti. Il portale OEM conserva i dati per 18 mesi di default, con un'estensione a 7 anni disponibile per le distribuzioni tier-2 dell'AI Act. Il portale supporta una richiesta di esportazione dati da parte dei genitori, che restituisce un bundle zippato del vettore di stato per bambino e della telemetria per sessione. Una richiesta di cancellazione dati dei genitori svuota la partizione per bambino entro 14 giorni. Abbiamo spedito un governance pack OEM che include l'informativa sulla privacy, il flusso della schermata di consenso dei genitori, la mappa di residenza dei dati regionali e l'elenco dei contratti dei sub-responsabili per regione. L'elenco dei contratti è lo stesso a cui si fa riferimento nella roadmap di integrazione AI della penna di lettura.
14. Il piano di progetto OEM per una penna di apprendimento adattivo
| Fase del progetto | Durata | Deliverable |
|---|---|---|
| Discovery | 2 settimane | Analisi delle lacune RFP, audit dei contenuti |
| Ottimizzazione degli algoritmi | 4 settimane | Importazione del grafo curricolare, adattamento BKT, esecuzione benchmark personalizzato |
| Integrazione della telemetria | 3 settimane | Portale OEM, dashboard per genitori/insegnanti |
| Distribuzione beta | 4 settimane | 50 penne, 5 classi, registro KPI |
| Produzione completa | 6 settimane | Build del container, accettazione AQL II |
| Timeline totale | 19 settimane | 5.000 unità minimo per OEM |
15. Riferimento e riepilogo decisionale
Il riepilogo decisionale è breve. Scegliete L5 per l'apprendimento adattivo con analisi cloud opzionali; scegliete K7 o Q6 per l'apprendimento adattivo con budget limitato; scegliete KF1 per programmi bilingui. Evitate B1, B2, F8 e P2 per l'apprendimento adattivo perché privi di NPU. Utilizzate il badge PenLitEval come criterio di accettazione nella RFQ. Abbinate la scelta algoritmica al Oem Reading Pens programma e il Reading Pen AI Integration Roadmap per la categoria più ampia. Per gli editori, il punto di partenza è Odm Reading Pens, che include gli strumenti per il pacchetto di contenuti.
Letture correlate
- Roadmap di integrazione AI delle penne di lettura 2024-2026
- Tradeoff tra TTS offline delle penne di lettura e API cloud
- Distribuzione LLM on-device delle penne di lettura
- Architettura firmware delle penne di lettura spiegata
- Applicazione delle penne di lettura nell'alfabetizzazione della prima infanzia
- Applicazione delle penne di lettura nella scuola primaria
- Guida alle specifiche della penna di lettura K7
- Guida introduttiva per il marchio privato delle penne di lettura