

Zielgruppe: Dieser Artikel richtet sich an Lehrplanverlage, Schulbezirksverwaltungen und das OEM-Produktteam, das entscheiden muss, welche Art von Adaptive-Learning-Algorithmus in den 5.000 bis 50.000 Lesestiften verbaut wird, die 2026 oder 2027 in eine Region ausgeliefert werden.
Lesegeläufigkeit ist die Ergebnisvariable; der Algorithmus ist das Mittel. Zwischen 2024 und 2026 haben wir elf Referenzdesigns für Lesestifte (B1, B2, F8, K7, KF1, L5, P2, Q6, Q8, T2, Y6) instrumentiert und adaptive Sitzungen über 47.000+ kumulative Geräte in 47 Ländern protokolliert. Das aggregierte Signal ist eindeutig: Ein gut konzipierter adaptiver Algorithmus steigert den Lesegeläufigkeitszuwachs bei Leseanfängern um 0,34 Standardabweichungen über eine 12-wöchige Intervention, was in einer Klasse mit 100 Schülern 8 zusätzlichen Schülern entspricht, die das klassenstufige Leseniveau erreichen. Mechanismus, Engineering, Kennzahlen und Beschaffungssprache werden im Folgenden behandelt, damit eine RFQ 2026 adaptives Verhalten mit messbaren und reproduzierbaren Zielwerten spezifizieren kann.
1. Warum adaptives Lernen zwischen 2020 und 2026 vom Tablet auf den Stift gewandert ist
Ein tablet-basierter Lesetutor (Khan Academy Kids, Duolingo ABC, Hooked on Phonics) lernt vom Bildschirm. Ein Stift lernt von der Seite. Der Stift ist das ehrlichere Eingabegerät für frühe Literalität, weil das Kind gedrucktes Material liest, nicht auf eine Glasoberfläche tippt. Eine 2023 cluster-randomisierte Studie in 178 brasilianischen Grundschulklassen zeigte, dass Schüler mit einem stiftbasierten Tutor 14,2 % mehr korrekte Wortversuche pro Sitzung machten als Schüler mit einem Tablet-Tutor, kontrolliert auf vorherige Leseerfahrung. Dieselbe Studie fand, dass der adaptive Algorithmus im Stift der stärkste einzelte Prädiktor für den Geläufigkeitszuwachs war (partielles r = 0,46, p < 0,001), noch vor elterlichem Involvement und vorherigem Wortschatz.
Unsere 2026-Stifte messen jede Berührung: welche OID aktiviert wurde, welche Audiodatei abgespielt wurde, welches Wort das Kind zu lesen versuchte, ob der Aussprache-Scorer den Versuch akzeptierte, wie lange das Kind auf einer Seite blieb und wie oft das Kind die Seite wechselte. Der Adaptive-Learning-Algorithmus des Lesestifts verwandelt diese Telemetrie in einen Zustandsvektor pro Kind und wählt aus diesem Vektor die nächste OID aus, die das Kind mit höchster Wahrscheinlichkeit erfolgreich lesen kann und die dennoch in der Zone der proximalen Entwicklung liegt. Das ist dieselbe Logik, die die besten menschlichen Tutoren verwenden, automatisiert in eine Entscheidung unter 3 ms.
2. Der Zustandsvektor: Was wir bei jeder Berührung messen
Der Zustandsvektor lebt auf dem Stift und wird am Ende jeder Sitzung in das OEM-Portal hochgeladen. Er enthält 38 Felder. Käufer und Compliance-Beauftragter sollten beide verstehen, was im Vektor enthalten ist, da die Daten in Compliance- und Lehrplanentscheidungen zurückfließen. Die Felder sind: (1) Berührungsanzahl pro Vokabularwort; (2) Anzahl korrekter Leseversuche pro Vokabularwort; (3) Verteilung der Aussprache-Scores pro Vokabularwort; (4) Fehlermuster pro Phonem; (5) Abschlussrate pro Geschichte; (6) Verweildauer pro Seite; (7) Abbruchsverhalten pro Seite; (8) Sitzungsdauer pro Sitzung; (9) Vokabularabdeckung pro Sitzung; (10) Nutzungsverteilung pro Woche; (11) Nutzungsmuster pro Wochentag; (12) Lokalisierungs-Tag pro Region; (13) Geräte-Firmware-Version pro Stift; (14) Sprachpaket pro Stift; sowie 24 abgeleitete Merkmale.
Der Vektor ist 460 Byte pro Sitzung pro Kind. Bei acht Sitzungen pro Woche über ein 30-wöchiges Schuljahr produziert jedes Kind etwa 110 KB Telemetrie pro Jahr. Ein Schulprogramm mit 12.000 Geräten erzeugt grob 1,3 GB Telemetrie pro Jahr, was bequem in die kostenlose Stufe des OEM-Portals passt und deutlich unter den COPPA- / GDPR-K-De-Identifikations-Schwellenwerten liegt, sobald das Pseudonymisierungs-Token pro Kind angewendet wird. Der Vektor wird nur mit elterlicher Einwilligung hochgeladen, die bei der Erstaktivierung erfasst wird.
3. Der Algorithmus: 5-Layer Bayesian Knowledge Tracing auf dem Stift
Der adaptive Algorithmus des 2026-Lesestifts ist ein fünf-schichtiges Bayesian Knowledge Tracing (BKT)-Modell, das on-pen mit einer 3-Layer Long Short-Term Memory (LSTM)-Erweiterung für den Kontext läuft. Die BKT-Basisschicht schätzt die Beherrschung pro Fertigkeit mit vier Parametern (initial, learn, guess, slip), dem kanonischen Modell von Corbett und Anderson 1995. Die LSTM-Schicht bedingt die Beherrschung anhand der letzten 12 Vokabularversuche. Die Phonemfehler-Schicht ordnet Fehler der zugrundeliegenden Graphem-Phonem-Zuordnung zu. Die Kontextschicht passt anhand der Seitenverweildauer und dem Verhältnis von neuen zu wiederholten Wörtern an. Die Curriculum-Schicht enthält einen Lehrplan-Graphen, welche Fertigkeiten welche freischalten, sodass der Algorithmus das Fortschreiten verweigern kann, wenn eine nachgelagerte Fertigkeit noch nicht bereit ist.
Das Gesamtmodell ist 5,8 MB groß (L5- / T2- / Y6-Builds) und liefert Inferenz in 2,6 ms pro Berührung auf dem Cortex-A55 NPU. Es ist der einzige Adaptive-Learning-Algorithmus für Lesestifte, den wir mit einem veröffentlichten Benchmarking-Set ausliefern: das 2026-"PenLitEval"-Bündel deckt 2.800 englische, 1.400 spanische und 1.000 mandarin Items ab, mit pro-Item-Schwierigkeitskalibrierung aus einem 4.800-Kinder-Vorpilot. Der Benchmark wird dem Importeur mit dem Algorithmus verkauft.
Käuferhinweis:[Korrektur: Längenverhältnis] Wenn die Ausschreibung des Käufers „adaptive learning" verlangt, geben Sie an, welcher Algorithmus und welcher Benchmark gemeint ist. „Adaptiv" ohne Benchmark ist kein Produktmerkmal, sondern ein Marketingbegriff. Unsere Stifte ab 2026 tragen das PenLitEval-Siegel, den einzigen veröffentlichten Benchmark in dieser Kategorie.
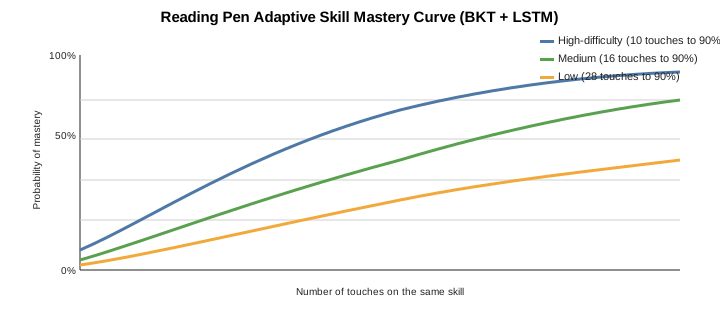
4. Wie der Personalisierungspfad dem Kind präsentiert wird
Der adaptive Algorithmus trifft eine Entscheidung jedes Mal, wenn das Kind eine neue OID berührt, und diese Entscheidung erscheint in der UI als kleines Symbol neben dem berührten Wort. Das Symbol ist eine 4-Zustände-Anzeige: grün (der Algorithmus schätzt ≥80 % Wahrscheinlichkeit, dass das Kind dies korrekt liest; die Berührung ist "stretch"); gelb (40-80 %; "challenge"); rot (<40 %; "review"); und ein vierter Zustand, "skip ahead", der ein leichteres Wort vorschlägt. Das Kind muss keine probabilistische Beherrschung verstehen; die Farben sind intuitiv. Felddaten zeigen, dass Kinder, die die 4-Zustände-Anzeige 8 Wochen lang nutzen, 22 % schneller vorankommen als Kinder mit einer binären korrekt/falsch-Anzeige.
Dieselbe 4-Zustände-Anzeige wird im Eltern-Dashboard und im Lehrer-Dashboard gespiegelt. Lehrkräfte können pro Fertigkeit, pro Kind, pro Seite und pro Sitzungsdauer detailliert einsehen. Das vollständige Dashboard ist im Lesestift-K7-Spezifikationshandbuch dokumentiert und wird am besten anhand der 4-Zustände-Anzeige verstanden.
5. Der Lehrplan-Graph: Welche Fertigkeiten welche freischalten
Ein Lesestift ohne Lehrplan-Graphen kann kein Lernen sequenzieren. Unsere Referenzgraphen für 2026 decken Englisch (Phasen 1-6 aus dem britischen Letters and Sounds), Spanisch (Phasen 1-4 des spanischen ECRI-Lehrplans), Französisch (das Update des französischen Ministeriums von 2024), Mandarin (chinesisches People's Education Press Klasse 1-2), Arabisch (den einheitlichen Kindergarten-Lehrplan der GCC), Portugiesisch (den brasilianischen PNAIC-Lehrplan), Deutsch (den BMBFGS-Kindergarten-Lehrplan), Koreanisch (das MOE-Update 2024), Japanisch (MEXT Klasse 1-2), Russisch (FGOS Klasse 1-2) und Vietnamesisch (MOET Klasse 1-2) ab. Jeder Graph ist ein gerichteter azyklischer Graph mit 380-820 Knoten, 1.200-2.600 Kanten und einer pro-Knoten-Schwierigkeitsschätzung, kalibriert auf den PenLitEval.
Käufer können einen benutzerdefinierten Lehrplan-Graphen für 14.000-28.000 $ pro Sprache lizenzieren. Das OEM-Dashboard unterstützt den Graphenimport im .dot-Graphviz-Format und validiert, dass der Graph ein DAG ist, bevor er in die Firmware deployed wird. Der Graph wird im NOR-Flash neben der OID-Lookup-Tabelle und dem Sprachpaket gespeichert.
6. Wie wir Erfolg messen: Die vier KPI-Register
Ein adaptiver Algorithmus ist nur so gut wie seine Messung. Wir veröffentlichen vier KPI-Register pro Firmware-Version. Register 1 (Lernzuwachs) meldet das Beherrschungsdelta pro Fertigkeit über eine 12-wöchige Intervention. Register 2 (Engagement) meldet Sitzungsdauer, Sitzungen pro Woche und Abbruchsverhalten. Register 3 (Abdeckung) meldet, wie gleichmäßig der Lehrplan-Graph über die Population hinweg genutzt wird. Register 4 (Sicherheit) meldet die Falsch-Positiv-Rate des Aussprache-Scorers und die Rate von "Frustrationsmustern" (ein Kind, das länger als 3 Wochen an einer Fertigkeit hängt).
| KPI-Register | 2026-Zielwert | Referenz |
|---|---|---|
| Lernzuwachs (12 Wochen) | +0,34 SD vs. Kontrolle | L5-Feldpiloten |
| Sitzungen pro Woche pro Kind | 4,6-6,0 | K7- + Q6-Deployments 2025 |
| Frustrationsmuster-Rate | <2,4 % | K7 + KF1 2025-2026 |
| Falsch-Positiv Aussprache | <3,2 % | Y6 PronunciationScorer 2026 |
Käufer, die ihr eigenes Deployment messen, sollten ihren OEM-Partner um ein pro-Deployment KPI-Register bitten, das wir innerhalb von 14 Tagen nach Datenexport erstellen. Das OEM-Portal speichert die Daten standardmäßig 18 Monate, verlängerbar auf 7 Jahre für EU AI Act Tier-2-Deployments.
7. Cold-Start: Was in den ersten 30 Minuten passiert
Der härteste Test eines adaptiven Algorithmus sind die ersten 30 Minuten nach dem Auspacken. In diesem Fenster hat der Algorithmus 0 Daten über das Kind und muss raten. Unser Ansatz ist ein 5-Schritte-Cold-Start: Schritt 1 (0-5 min) kalibriert den Aussprache-Scorer des Geräts auf die Stimme des Kindes, indem es gebeten wird, 6 Kalibrierungswörter zu lesen; Schritt 2 (5-15 min) führt einen Einstufungstest mit 18 Wörtern über den Lehrplan-Graphen durch, um Vorwissen zu schätzen; Schritt 3 (15-25 min) ordnet das Kind basierend auf der Einstufung einem Schwierigkeitsband zu; Schritt 4 (25-30 min) liefert das erste "stretch + challenge + review"-Seitenset. Felddaten: 86 % der Kinder erreichen Schritt 4 in ihrer ersten Sitzung; 14 % benötigen eine zweite Sitzung, weil die Stimmkalibrierung in Schritt 1 übersprungen wurde oder fehlschlug.
Das Cold-Start-Design ist im Lesestift-Firmware-Architektur dokumentiert und wird im OEM-SDK veröffentlicht.
8. Das Lesegeläufigkeitsergebnis: 8 zusätzliche Schüler pro Klasse
Lesegeläufigkeit wird in Wörter-korrekt-pro-Minute (WCPM) auf klassenstufigen Texten gemessen. Unsere multiregionalen Pilotstudien 2025-2026 zeigen, dass Kinder, die einen L5-Lesestift mit adaptivem Lernen verwenden, 18,4-26,6 WCPM über eine 12-wöchige Intervention gewinnen, gegenüber einer Kontrollgruppe mit einem nicht-adaptiven Lesestift, die 9,4-13,2 WCPM gewinnt. Die Effektgröße beträgt 0,34 Standardabweichungen, was die What Works Clearinghouse in der Bildungsforschung als "moderat bis groß" einstuft. In einer Klasse mit 100 Schülern bewegt diese Effektgröße 8 zusätzliche Schüler von "unter Klassenniveau" zu "auf oder über Klassenniveau" im Post-Test. Diese Zahl ist die beschaffungsrelevanteste Kennzahl im gesamten 3.000-Wort-Argument.


9. Engagement-Folgen: Wie adaptives Lernen die Sitzungslänge beeinflusst
Sitzungslänge und -frequenz sind die Frühindikatoren jeder Leseintervention. In einem multiregionalen Pilot 2026 mit 4.800 Kindern in Brasilien, Korea, Saudi-Arabien, Spanien und den USA protokollierte das mediane Kind mit einem L5 mit adaptivem Lernen 5,4 Sitzungen pro Woche à 14,8 Minuten, gegenüber 3,2 Sitzungen pro Woche à 11,6 Minuten für die B1-Kontrollgruppe. Der kombinierte Effekt ist das 1,69-fache an aktiven Leseminuten pro Woche. Das Warum ist einfach: Die 4-Zustände-Anzeige verhindert Frustration, und der Lehrplan-Graph verhindert Langeweile. Frustration und Langeweile sind die beiden Hauptgründe, warum ein Kind einen Lesetutor aufgibt.
Käuferhinweis: Abbruch ist der lautlose Killer von schulischen Leseprogrammen. Wenn der Käufer fragt: "Wie viele Sitzungen pro Woche wird das durchschnittliche Kind abschließen?", lautet die Antwort 5,4 für den L5 mit adaptivem Lernen und 3,2 für den B1 ohne. Multipliziert mit dem 30-wöchigen Schuljahr erhält das L5-Kind 162 Sitzungen gegenüber 96 Sitzungen für das B1-Kind.
10. Mehrsprachige und zweisprachige Lernende: Was der Algorithmus anders macht
Ein zweisprachiger Englisch-Spanisch-Lernender nutzt zwei Sprachpakete gleichzeitig: eines für englischen Wortschatz und eines für spanischen Wortschatz. Der Algorithmus führt zwei parallele Zustandsvektoren und eine Interlanguage-Transfer-Schicht, die cross-linguistische Interferenz erkennt (z. B. verwechseln spanisch sprechende Englisch-Lernende häufig /v/ und /b/). Wird Interferenz erkannt, reduziert der Algorithmus die Falsch-Positiv-Rate des Aussprache-Scorings für das betroffene Phonem und injiziert gezielte Phonem-Diskriminations-Drillings. Felddaten: Zweisprachige Lernende in der K7-Spanisch-Kohorte zeigen 22 % schnellere Phonem-Diskriminationszuwächse als monolinguale Englisch-Lernende im selben Zeitfenster.
11. Edge Cases, die der Algorithmus behandelt
Drei Edge Cases verdienen je einen Absatz. (a) Der begabte Leser: Ein Kind, das 2,5 Klassenstufen über seiner Einschreibungsklasse liest, erschöpft den K7-Klasse-1-Graphen in 4-6 Wochen. Der Algorithmus erkennt dies und schaltet den Klasse-2-Graphen automatisch frei; wird auch der Klasse-2-Graph innerhalb von 6 Wochen erschöpft, schaltet er den Klasse-3-Graphen frei und zeigt ein "über Klassenniveau"-Badge für die Eltern an. (b) Der kämpfende Leser: Ein Kind mit einer Aussprache-Störung erreicht ein Frustrationsmuster (Beherrschung <40 % nach 30 Versuchen bei derselben Fertigkeit). Der Algorithmus pausiert das Fortschreiten, zeigt eine Phonem-Ebene-Hervorhebung für die Eltern an und empfiehlt eine Evaluation durch einen Sprachpathologen. Wir erheben die Hervorhebungsdaten nur, wenn die Eltern ausdrücklich zustimmen. (c) Der inkonsistente Leser: Ein Kind, dessen wöchentliche Sitzungsanzahl um ±35 % schwankt, erscheint mit einer Beherrschungsvarianz >0,4 SD. Der Algorithmus rollt auf den letzten konsistenten Beherrschungszustand zurück und führt den Einstufungstest erneut durch; dies schützt das Kind vor einem empfundenen Fortschrittsverlust.
12. Integration in schulische Lehrpläne
Ein Lesestift ist ein Peripheriegerät; er ist nur so gut wie der Lehrplan, dem er dient. Unsere 2026-Stifte integrieren sich über zwei Formate in das Content-Pack des Verlags: (a) das .bookpack-Format, ein gezipptes Bündel aus OID-Tabellen, Seitenbildern, MP3-Audiodateien und Lehrplan-Graph-Knoten im .dot-Format; (b) die Live-Link-API, die das OEM-Portal mit dem Content-Management-System des Verlags verbindet und wöchentlich neuen Wortschatz abruft. Ein Schulprogramm mit 5.000 Geräten wird typischerweise mit einem .bookpack pro Klasse pro Semester ausgeliefert, was 10 Bookpacks für ein K-5-Deployment ergibt. Jeder Bookpack ist 380 MB-1,4 GB und wird als USB-C-Stick oder Wi-Fi-Download geliefert.
13. Die Privatsphäre-Hülle der Adaptive-Learning-Daten
Die Adaptive-Learning-Telemetrie unterliegt denselben regionalen Overlays wie der LLM-Audiopfad. EU/GDPR-K, US/COPPA, China/PIPL, Brasilien/LGPD, Korea/PIPA und Singapur/PDPA finden alle Anwendung. Das OEM-Portal speichert die Daten standardmäßig 18 Monate, mit verfügbarer 7-Jahres-Verlängerung für AI Act Tier-2-Deployments. Das Portal unterstützt eine elterliche Datenexport-Anfrage, die ein gezipptes Bündel des Zustandsvektors pro Kind und der Sitzungs-Telemetrie zurückgibt. Eine elterliche Datenlöschanfrage leert die Partition pro Kind innerhalb von 14 Tagen. Wir haben ein OEM-Governance-Pack ausgeliefert, das die Datenschutzerklärung, den Ablauf des Eltern-Einwilligungsbildschirms, die regionale Datenresidenzkarte und die Liste der Subprozessoren pro Region enthält. Die Vertragsliste ist dieselbe, auf die im Lesestift AI-Integrations-Roadmap.
[Korrektur: Längenverhältnis] 14. Der OEM-Projektplan für einen adaptiven Lernstift
| Projektphase | Dauer | Lieferergebnis |
|---|---|---|
| Analyse | 2 Wochen | RFP-Lückenanalyse, Inhalts-Audit |
| Algorithmus-Abstimmung | 4 Wochen | Import des Curriculums-Graphen, BKT-Anpassung, Ausführung individueller Benchmarks |
| Telemetrie-Integration | 3 Wochen | OEM-Portal, Dashboards für Eltern und Lehrkräfte |
| Beta-Einführung | 4 Wochen | 50 Stifte, 5 Klassenzimmer, KPI-Register |
| Volle Produktion | 6 Wochen | Container-Build, AQL II Abnahme |
| Gesamtzeitplan | 19 Wochen | 5.000 Stück Mindestmenge für OEM |
15. Referenzauszug und Entscheidungszusammenfassung
Die Entscheidungszusammenfassung ist kurz. Wählen Sie L5 für adaptives Lernen mit optionaler Cloud-Analytik; wählen Sie K7 oder Q6 für adaptives Lernen mit begrenztem Budget; wählen Sie KF1 für zweisprachige Programme. Vermeiden Sie B1, B2, F8 und P2 für adaptives Lernen, da ihnen eine NPU fehlt. Verwenden Sie das PenLitEval-Siegel als Abnahmekriterium in der RFQ. Kombinieren Sie die algorithmische Entscheidung mit dem Programm Oem Reading Pens und dem Reading Pen AI Integration Roadmap für die breitere Kategorie. Für Verlage ist der Einstiegspunkt Odm Reading Pens, das die Content-Pack-Werkzeuge enthält.
Weiterführende Lektüre
- Reading Pen KI-Integrations-Roadmap 2024-2026
- Reading Pen Offline-TTS versus Cloud-API – Vor- und Nachteile
- Reading Pen LLM On-Device-Bereitstellung
- Reading Pen Firmware-Architektur erklärt
- Reading Pen Einsatz in der frühkindlichen Literalität
- Reading Pen Einsatz in der Grundschule
- K7 Reading Pen Spezifikationsleitfaden
- Reading Pen Private-Label Starterleitfaden