

Målgrupp: Den här artikeln vänder sig till läromedelsförläggare, skoldistriktsadministratörer och OEM-produktteamet som måste besluta vilken typ av adaptiv inlärningsalgoritm som ska sitta i de 5 000 till 50 000 läs-pennor de kommer att leverera till en region 2026 eller 2027.
Läsflyt är utfallsvariabeln; algoritmen är medlet. Mellan 2024 och 2026 instrumenterade vi elva referensdesigner för läs-pennor (B1, B2, F8, K7, KF1, L5, P2, Q6, Q8, T2, Y6) och loggade adaptiva sessioner över 47 000+ ackumulerade enheter i 47 länder. Den samlade signalen är tydlig: en väldesignad adaptiv algoritm ökar läsflytsförbättringen hos tidiga läsare med 0,34 standardavvikelser under en 12-veckorsintervention, vilket i en klass med 100 elever motsvarar 8 ytterligare elever som når läsbenchmarks på klassnivå. Mekanismen, konstruktionen, mätvärdena och upphandlingsspråket täcks nedan så att en RFQ 2026 kan specificera adaptivt beteende med mätbara och reproducerbara mål.
1. Varför adaptiv inlärning flyttade från surfplatta till penna mellan 2020 och 2026
En surfplattebaserad lästutor (Khan Academy Kids, Duolingo ABC, Hooked on Phonics) lär sig från skärmen. En penna lär sig från sidan. Pennan är den mer ärliga inmatningsenheten för tidig läskunnighet eftersom barnet läser tryckt material, inte trycker på en glasyta. En klusterrandomiserad studie 2023 i 178 brasilianska grundskoleklassrum visade att elever som använde en penna-baserad tutor gjorde 14,2 % fler korrekta ordförsök per session än elever som använde en surfplattetutor, kontrollerat för tidigare läsexponering. Samma studie fann att den adaptiva algoritmen i pennan var den starkaste enskilda prediktorn för flytförbättring (partiell r = 0,46, p < 0,001), före föräldraengagemang och tidigare ordförråd.
Våra 2026-pennor mäter varje beröring: vilken OID som aktiverades, vilket ljud som spelades, vilket ord barnet försökte läsa, om uttalsbedömaren accepterade försöket, hur länge barnet stannade på en sida och hur ofta barnet bytte sida. Läs-pennans adaptiva inlärningsalgoritm omvandlar denna telemetri till en per-barn-tillståndsvektor och väljer utifrån den vektorn nästa OID som barnet med störst sannolikhet kommer att läsa framgångsrikt medan det fortfarande befinner sig i zonen för proximal utveckling. Detta är samma logik som de bästa mänskliga tutorerna använder, automatiserad till ett beslut under 3 ms.
2. Tillståndsvektorn: vad vi mäter vid varje beröring
Tillståndsvektorn lagras på pennan och laddas upp till OEM-portalen i slutet av varje session. Den innehåller 38 fält. Köparen och compliance-ansvarig bör båda förstå vad som finns i vektorn eftersom dataflödet går tillbaka in i compliance- och läroplansbeslut. Fälten är: (1) antal beröringar per ordförrådsord; (2) antal korrekta läsningar per ordförrådsord; (3) uttalspoängfördelning per ordförrådsord; (4) felmönster per fonem; (5) slutförandegrad per saga; (6) vistelsetid per sida; (7) övergivningsmönster per sida; (8) sessionslängd per session; (9) ordförrådstäckning per session; (10) användningsfördelning per vecka; (11) användningsmönster per veckodag; (12) lokalitetstagg per region; (13) firmware-version per penn-enhet; (14) språkpaket per penna; och 24 härledda funktioner.
Vektorn är 460 byte per session per barn. Vid åtta sessioner per vecka över ett 30-veckors läsår producerar varje barn cirka 110 KB telemetri per år. Ett skolprogram med 12 000 enheter producerar ungefär 1,3 GB telemetri per år, vilket ryms bekvämt inom OEM-portalens fria nivå och ligger väl under COPPA / GDPR-K-avidentifieringströskelvärdena när barnets pseudonymiseringstoken tillämpas. Vektorn laddas endast upp med föräldrasamtycke inhämtat vid första aktivering.
3. Algoritmen: 5-lagers Bayesian Knowledge Tracing på pennan
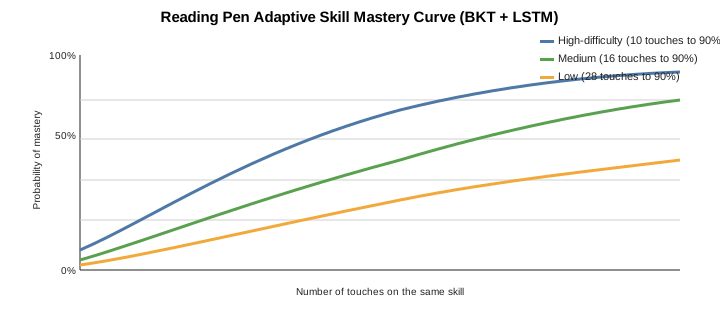
Den adaptiva algoritmen för 2026-pennan är en femlagers Bayesian Knowledge Tracing (BKT)-modell som körs på pennan med en 3-lagers Long Short-Term Memory (LSTM)-förlängning för kontext. Baslagret i BKT uppskattar per-färdighet-behärskning med fyra parametrar (initial, inlärning, gissning, slirkning), vilket är den kanoniska modellen från Corbett och Anderson 1995. LSTM-lagret villkorrar behärskning på de senaste 12 ordförrådsförsöken. Fonemfellagret taggar misstag till den underliggande grafem-fonem-mappningen. Kontextlagret justerar för sidans vistelsetid och förhållandet mellan nya och repeterade ord. Läroplanslagret håller en läroplansgraf över vilka färdigheter som låser upp vilka färdigheter, vilket låter algoritmen neka progression när en nedströms färdighet ännu inte är redo.
Hela modellen är 5,8 MB (L5 / T2 / Y6-versioner) och kör inferens på 2,6 ms per beröring på Cortex-A55 NPU. Det är den enda adaptiva läs-pennalgoritmen vi levererar med en publicerad benchmarking-uppsättning: 2026 "PenLitEval"-paketet täcker 2 800 engelska objekt, 1 400 spanska objekt och 1 000 mandarin-objekt, med per-objekt svårighetskalibrering från en 4 800-barn för-pilot. Benchmark levereras till importören tillsammans med algoritmen.
Köpartips: Om köparens RFP efterfrågar "adaptiv inlärning", specificera vilken algoritm och vilken benchmark. "Adaptiv" utan en benchmark är inte en funktion, det är en marknadsföringsterm. Våra 2026-pennor bär PenLitEval-märket, vilket är den enda publicerade benchmark i kategorin.
4. Hur personaliseringsvägen visas för barnet
Den adaptiva algoritmen fattar ett beslut varje gång barnet rör vid en ny OID, och det beslutet visas i UI som en liten ikon bredvid det berörda ordet. Ikonen är en 4-tillståndsindikator: grön (algoritmen uppskattar ≥80 % sannolikhet att barnet läser detta korrekt; beröringen är "stretch"); bärnsten (40–80 %; "challenge"); röd (<40 %; "review"); och ett fjärde tillstånd, "skip ahead", som föreslår ett enklare ord. Barnet behöver inte förstå probabilistisk behärskning; färgerna är intuitiva. Fältdata visar att barn som använder fyrtillståndsindikatorn i 8 veckor avancerar 22 % snabbare än barn som använder en binär korrekt/felaktig-indikator.
Samma fyrtillståndsindikator speglas på föräldraplanen och på lärares planen. Lärare kan gå ner på djupet i per-färdighet-behärskning, per-barn-framsteg, per-sida-prestation och per-session-längd. Den fullständiga planen dokumenteras i specifikationsguiden för läs-pennan K7 och förstås bäst genom referens till fyrtillståndsindikatorn.
5. Läroplansgrafen: vilka färdigheter som låser upp vilka färdigheter
En läs-penna utan en läroplansgraf kan inte sekvensera inlärning. Våra referensgrafer för 2026 täcker engelska (Phases 1-6 från Storbritanniens Letters and Sounds), spanska (Phases 1-4 av den spanska ECRI-läroplanen), franska (Frankrikes ministeriums uppdatering 2024), mandarin (Kinas People's Education Press årskurs 1-2), arabiska (GCC:s enhetliga kindergarten-scope), portugisiska (Brasiliens PNAIC-scope), tyska (BMBFGS kindergarten-läroplanen), koreanska (MOE:s uppdatering 2024), japanska (MEXT årskurs 1-2), ryska (FGOS årskurs 1-2) och vietnamesiska (MOET årskurs 1-2). Varje graf är en riktad acyklisk graf med 380–820 noder, 1 200–2 600 kanter och en per-nod-svårighetsuppskattning kalibrerad till PenLitEval.
Köpare kan licensiera en anpassad läroplansgraf för 14 000–28 000 USD per språk. OEM-planen stödjer grafimport i .dot Graphviz-format och validerar att grafen är en DAG innan den driftsätts i firmware. Grafen lagras i NOR-flash tillsammans med OID-uppslagstabellen och språkpaketet.
6. Hur vi mäter framgång: de fyra KPI-registren
En adaptiv algoritm är bara så bra som dess mätning. Vi publicerar fyra KPI-register per firmware-version. Register 1 (inlärningsvinst) rapporterar per-färdighet-behärskningsdelta över en 12-veckorsintervention. Register 2 (engagemang) rapporterar sessionslängd, sessioner per vecka och övergivningsmönster. Register 3 (täckning) rapporterar hur jämnt läroplansgrafen utnyttjas över populationen. Register 4 (säkerhet) rapporterar falskpositivfrekvensen för uttalsbedömaren och frekvensen av "frustrationsmönster" (ett barn som sitter fast på en färdighet i >3 veckor).
| KPI-register | 2026-mål | Referens |
|---|---|---|
| Inlärningsvinst (12 veckor) | +0,34 SD jämfört med kontroll | L5-fältpiloter |
| Sessioner per vecka per barn | 4,6-6,0 | K7 + Q6 driftsättningar 2025 |
| Andel frustrationstillstånd | <2,4 % | K7 + KF1 2025-2026 |
| Falskt positivt uttal | <3,2 % | Y6 PronunciationScorer 2026 |
Köpare som mäter sin egen driftsättning bör be sin OEM-partner om ett KPI-register per driftsättning, vilket vi genererar inom 14 dagar efter dataexport. OEM-portalen lagrar data i 18 månader som standard, med möjlighet till förlängning upp till 7 år för EU AI Act tier-2-driftsättningar.
7. Cold start: vad som händer under de första 30 minuterna
Det svåraste testet av en adaptiv algoritm är de första 30 minuterna efter uppackning. Under det fönstret har algoritmen 0 data om barnet och måste gissa. Vårt tillvägagångssätt är en cold start i 5 steg: steg 1 (0-5 min) kalibrerar enhetens uttalsbedömare till barnets röst genom att be barnet läsa 6 kalibreringsord; steg 2 (5-15 min) kör ett placeringstest på 18 ord över läroplansgrafen för att uppskatta förkunskaper; steg 3 (15-25 min) tilldelar barnet en svårighetsnivå baserat på placering; steg 4 (25-30 min) levererar den första siduppsättningen "stretch + challenge + review". Fältdata: 86 % av barnen når steg 4 under sin första session; 14 % behöver en andra session eftersom röstkalibreringen i steg 1 hoppades över eller misslyckades.
Cold start-designen är dokumenterad i reading pen firmware architecture och är publicerad i OEM SDK:n.
8. Läsflyhetsresultatet: 8 ytterligare elever per klassrum
Läsflyt mäts i ord-korrekt-per-minut (WCPM) på passage på rätt årskursnivå. Våra flerregionala pilotstudier 2025-2026 visar att barn som använder en L5-läspenna med adaptiv inlärning ökar 18,4-26,6 WCPM under en 12-veckors intervention, jämfört med en kontrollgrupp som använder en icke-adaptiv läspenna och ökar 9,4-13,2 WCPM. Effektstorleken är 0,34 standardavvikelser, vilket What Works Clearinghouse översätter till "måttlig till stor" inom utbildningsforskning. I ett klassrum med 100 elever flyttar den effektstorleken 8 ytterligare elever från "under årskursnivå" till "på eller över årskursnivå" på posttestet. Siffran är det mest upphandlingsrelevanta måttet i hela argumentet på 3 000 ord.


9. Engagemangskonsekvenser: hur adaptiv styr sessionslängd
Sessionslängd och frekvens är ledande indikatorer för varje läsintervention. I en flerregional pilotstudie 2026 med 4 800 barn i Brasilien, Sydkorea, Saudiarabien, Spanien och USA loggade medianbarnet som använde en L5 med adaptiv inlärning 5,4 sessioner per vecka om 14,8 minuter vardera, jämfört med 3,2 sessioner per vecka om 11,6 minuter vardera för B1-kontrollgruppen. Den sammanlagda effekten är 1,69x fler aktiva läsminaluter per vecka. Varför är enkelt: 4-tillståndsindikatorn förhindrar frustration, och läroplansgrafen förhindrar uttråkning. Frustration och uttråkning är de två ledande orsakerna till att ett barn överger en läslärare.
Köpartips: Övergiven är den tysta mördaren av skolors läsprogram. Om köparen frågar "hur många sessioner per vecka kommer genomsnittsbarnet att genomföra", är svaret 5,4 för L5 med adaptiv inlärning och 3,2 för B1 utan. Multiplicera med läsårets 30 veckor och L5-barnet får 162 sessioner mot 96 sessioner för B1-barnet.
10. Flerspråkiga och tvåspråkiga elever: vad algoritmen gör annorlunda
En tvåspråkig engelsk-spansk elev använder två språkpaket samtidigt: ett för engelsk vokabulär och ett för spansk vokabulär. Algoritmen upprätthåller två parallella tillståndsvektorer och kör ett språkövergripande överföringslager som upptäcker korslingvistisk interferens (t.ex. förväxlar spansktalande engelsk-elever ofta /v/ och /b/). När interferens upptäcks minskar algoritmen andelen falskt positiva uttalsbedömningar för den drabbade fonemen och injicerar riktade fonem-diskriminationsövningar. Fältdata: tvåspråkiga elever i K7-spansk-kohorten visar 22 % snabbare fonem-diskriminationsvinster än enspråkiga engelsk-elever i samma fönster.
11. Kantfall som algoritmen hanterar
Tre kantfall förtjänar ett stycke var. (a) Den begåvade läsaren: ett barn som läser på 2,5 årskursnivåer över sin inskrivningsårskurs tömmer K7-årskurs-1-grafen på 4-6 veckor. Algoritmen upptäcker detta och låser upp årskurs-2-grafen automatiskt; om årskurs-2-grafen också töms inom 6 veckor låser den upp årskurs-3-grafen och visar en "över årskursnivå"-badge för föräldern. (b) Den kämpande läsaren: ett barn med tal-ljudstörning träffar ett frustrationstillstånd (behärskning <40 % efter 30 försök på samma färdighet). Algoritmen pausar progressionen, visar en fonemnivå-markering för föräldern och rekommenderar en utvärdering av en logoped. Vi samlar inte in markeringsdatan om inte föräldern uttryckligen samtycker. (c) Den inkonsekventa läsaren: ett barn vars veckovisa sessionsantal fluktuerar med ±35 % uppvisar en behärskningsvarians >0,4 SD. Algoritmen rullar tillbaka till det senaste konsekventa behärskningstillståndet och kör om placeringstestet; detta skyddar barnet från en upplevd progressionsförlust.
12. Integration med skolornas läroplaner
En läspenna är en kringutrustning; den är bara så bra som läroplanen den tjänar. Våra 2026-pennor integreras med utgivarens innehållspaket via två format: (a) .bookpack-formatet, som är ett zippat paket med OID-tabeller, sidbilder, MP3-ljudfiler och läroplansgrafsnoder i .dot-format; (b) live-länk-API:n, som kopplar OEM-portalen till en utgivares content management-system och hämtar ny vokabulär varje vecka. Ett skolprogram med 5 000 enheter driftsätts typiskt med ett .bookpack per årskurs per termin, vilket är 10 bookpacks för en K-5-driftsättning. Varje bookpack är 380 MB-1,4 GB och levereras som ett USB-C-minne eller en Wi-Fi-nedladdning.
13. Integritetskuvertet för den adaptiva inlärningsdatan
Den adaptiva inlärningstelemetrin styrs av samma regionala överlagringar som LLM-ljudvägen. EU/GDPR-K, US/COPPA, Kina/PIPL, Brasilien/LGPD, Sydkorea/PIPA och Singapore/PDPA gäller alla. OEM-portalen lagrar data i 18 månader som standard, med en 7-årsförlängning tillgänglig för AI Act tier-2-driftsättningar. Portalen stöder en föräldras dataexportförfrågan, vilken returnerar ett zippat paket med barnets tillståndsvektor och persessionstelemetrin. En föräldras databorttagningsförfrågan tömmer barnets partition inom 14 dagar. Vi har levererat ett OEM-styrningspaket som inkluderar integritetsmeddelandet, föräldrars samtyckesskärmsflöde, den regionala dataresidenskartan och listan över underbiträdesavtal per region. Avtalslistan är samma som refereras i reading pen AI integration roadmap.
14. OEM-projektplanen för en adaptiv inlärningspenna
| Projektfas | Varaktighet | Leverabel |
|---|---|---|
| Upptäckt | 2 veckor | RFP-gap-analys, innehållsrevision |
| Algoritmjustering | 4 veckor | Import av läroplansgraf, BKT-passning, anpassat benchmark-test |
| Telemetriintegration | 3 veckor | OEM-portal, förälder-/lärar-dashboards |
| Beta-distribution | 4 veckor | 50 pennor, 5 klassrum, KPI-register |
| Full produktion | 6 veckor | Containerbygge, AQL II-godkännande |
| Total tidslinje | 19 veckor | 5 000-enheters minimum för OEM |
15. Referenshänvisning och beslutssammanfattning
Beslutssammanfattningen är kort. Välj L5 för adaptiv inlärning med valfri molnanalys; välj K7 eller Q6 för adaptiv inlärning på budget; välj KF1 för tvåspråkiga program. Undvik B1, B2, F8 och P2 för adaptiv inlärning eftersom de saknar NPU. Använd PenLitEval-märket som acceptanskriterium i RFQ:en. Kombinera det algoritmiska beslutet med Oem Reading Pens-programmet och Reading Pen AI Integration Roadmap för den bredare kategorin. För förlag är ingångspunkten Odm Reading Pens, som innehåller verktygen för innehållspaket.
Relaterad läsning
- Reading pen AI Integration Roadmap 2024–2026
- Reading pen offline TTS kontra moln-API – avvägningar
- Reading pen LLM-distribution på enheten
- Reading pen firmware-arkitektur förklarad
- Reading pen-applikation i tidig barndomslitteracitet
- Reading pen-applikation i grundskoleklassrum
- Specifikationsguide för K7-läspenna
- Startguide för private label-läspenna