

対象オーディエンス: 本記事は、カリキュラム出版社、学区管理者、そして2026年または2027年に地域向けに5,000〜50,000台のOID reading penを出荷するOEM製品チームを意思決定対象として執筆しています。
読解流暢性(outcome variable)を目的変数とし、アルゴリズムはその手段です。2024年から2026年にかけて、当社は11種類のreading penリファレンスデザイン(B1、B2、F8、K7、KF1、L5、P2、Q6、Q8、T2、Y6)を計装し、47か国・累計47,000台超のアダプティブセッションを記録しました。集計シグナルは明確です。適切に設計されたアダプティブアルゴリズムは、12週間の介入で初学者の読解流暢性ゲインを0.34標準偏差高め、100名のクラスでは学年別読解ベンチマーク達成者を8名相当押し上げます。2026年のRFQがアダプティブ挙動を測定可能かつ再現可能なターゲットとして仕様化できるよう、メカニズム、エンジニアリング、メトリクス、購買言語を以下で網羅します。
1. なぜアダプティブ・ラーニングは2020〜2026年にタブレットからペンへ移行したのか
タブレット型reading tutor(Khan Academy Kids、Duolingo ABC、Hooked on Phonics)は画面から学習します。ペンはページから学習します。早期リテラシーにおいては、子どもがガラス面をタップするのではなく印刷物を読んでいるため、ペンの方が正直な入力デバイスです。2023年にブラジルの小学校1年生178クラスターで実施されたクラスター無作為化試験では、ペン型tutorを使用した生徒は、タブレット型tutorの生徒と比較して、セッションあたりの正答試行が14.2%多く、事前読解経験量を統制した上でもこの差が確認されました。同研究は、ペン内蔵のアダプティブアルゴリズムが流暢性ゲインの最強の単一予測因子(partial r = 0.46、p < 0.001)であり、保護者関与や事前語彙よりも上位であることを示しました。
当社の2026年モデルはすべてのタッチを計測します。どのOIDが作動したか、どの音声が再生されたか、子どもがどの単語を読もうとしたか、発音スコアラーがその試行を受理したか、そのページにどのくらいの時間滞在したか、ページをどの頻度で切り替えたか。当社のreading pen adaptive learning algorithmは、このテレメトリを児童ごとの状態ベクトルへ変換し、そのベクトルから最近接発達領域(zone of proximal development)の中で子どもが最も成功裏に読めるであろう次のOIDを選択します。これは最良の人間のチューターが用いるロジックを、3ms未満の意思決定へと自動化したものです。
2. 状態ベクトル:すべてのタッチで計測しているもの
状態ベクトルはペン上に保持され、セッション終了時にOEMポータルへアップロードされます。38フィールドを含みます。バイヤーおよびコンプライアンス担当者の双方が、ベクトルに含まれる内容を理解する必要があります。なぜなら、コンプライアンスおよびカリキュラムの意思決定にデータが還流するからです。フィールドは以下の通りです:(1)語彙単語別タッチ回数;(2)語彙単語別正読回数;(3)語彙単語別発音スコア分布;(4)音素別エラーパターン;(5)ストーリー別完読率;(6)ページ別滞留時間(dwell time);(7)ページ別離脱パターン;(8)セッション別継続時間;(9)セッション別語彙カバレッジ;(10)週別利用分布;(11)曜日別利用パターン;(12)地域別ロケールタグ;(13)ペン別デバイスファームウェアバージョン;(14)ペン別言語パック;および24の派生特徴量。
ベクトルは児童1名・1セッションあたり460バイトです。30週間の学年度で週8セッション、各児童は年間約110KBのテレメトリを生成します。12,000台規模の学校プログラムは年間およそ1.3GBのテレメトリを生成し、児童別仮名化トークンを適用した後はOEMポータルの無料枠に十分収まり、COPPA / GDPR-Kの非識別化しきい値も大きく下回ります。ベクトルは初回起動時に取得される保護者同意がある場合のみアップロードされます。
3. アルゴリズム:ペン上で動く5層ベイズ知識追跡
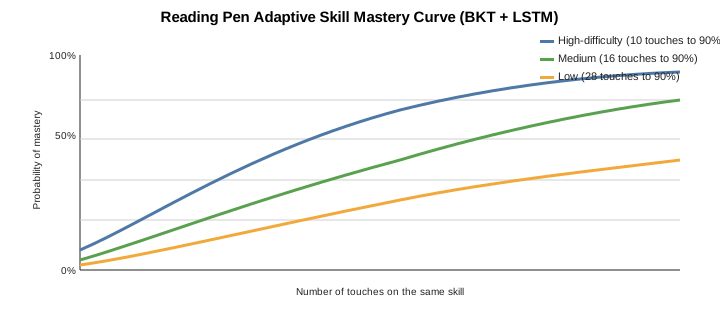
2026年のreading pen adaptive algorithmは、ペン上で動作する5層ベイズ知識追跡(BKT)モデルに、文脈用3層Long Short-Term Memory(LSTM)拡張を付加したものです。ベースBKT層は、Corbett and Anderson 1995年の標準モデルである4パラメータ(初期値、学習、推測、スリップ)でスキル別習得度を推定します。LSTM層は、直近12回の語彙試行に基づいて習得度を条件付けします。音素エラー層は、誤りを基礎となる文字-音素対応(grapheme-phoneme mapping)に紐付けます。文脈層は、ページ滞留時間と新規語対反復語の比率で調整します。カリキュラム層は、どのスキルがどのスキルを解禁するかのカリキュラムグラフを保持し、下流スキルが未準備の場合はアルゴリズムが進級を拒否できるようにします。
モデル全体は5.8MB(L5 / T2 / Y6ビルド)で、Cortex-A55 NPU上でタッチあたり2.6msの推論を行います。当社が公開ベンチマークとともに提供する唯一のreading pen adaptive algorithmです。2026年「PenLitEval」バンドルは2,800項目の英語、1,400項目のスペイン語、1,000項目の中国語項目を網羅し、4,800名の児童による事前パイロットから項目別難度が較正されています。このベンチマークはインポーターにアルゴリズムとともに販売されます。
バイヤーへの助言: バイヤーのRFPが「アダプティブ・ラーニング」を求める場合、どのアルゴリズムで、どのベンチマークに基づくかを仕様化してください。ベンチマークを伴わない「アダプティブ」は機能ではなく、マーケティング用語です。当社の2026年モデルはPenLitEvalバッジを備えており、本カテゴリで唯一の公開ベンチマークです。
4. パーソナライズ経路を子どもに提示する方法
アダプティブアルゴリズムは子どもが新しいOIDに触れるたびに意思決定を行い、その決定はUI上、触れた単語の脇の小さなアイコンとして表示されます。アイコンは4状態インジケータです:緑(アルゴリズムが80%以上の確率で子どもが正読できると推定;そのタッチは「stretch」)、黄(40〜80%;「challenge」)、赤(40%未満;「review」)、そして4つ目の状態「skip ahead」(より易しい単語を提案)です。子どもは確率的習得度を理解する必要はなく、色は直感的に理解できます。フィールド運用データでは、4状態インジケータを8週間使用した子どもは、正解/不正解の二値インジケータを使用した子どもと比較して、進度が22%速くなります。
同じ4状態インジケータは保護者ダッシュボードおよび教師ダッシュボードにもミラー表示されます。教師はスキル別習得度、児童別進度、ページ別パフォーマンス、セッション別継続時間をドリルダウンできます。ダッシュボード全体はreading pen K7仕様ガイドに文書化されており、4状態インジケータを参照すると最もよく理解できます。
5. カリキュラムグラフ:どのスキルがどのスキルを解禁するか
カリキュラムグラフを欠くreading penは学習を順序化できません。当社の2026年リファレンスグラフは、英語(英国Letters and Soundsのフェーズ1〜6)、スペイン語(Spanish ECRIカリキュラムのフェーズ1〜4)、フランス語(フランス教育省2024年更新版)、中国語(中国・人民教育出版 小学1〜2年級)、アラビア語(GCC統一幼稚園スコープ)、ポルトガル語(ブラジルPNAICスコープ)、ドイツ語(BMBFGS幼稚園カリキュラ�UM)、韓国語(教育部2024年更新版)、日本語(文部科学省 小学1〜2年)、ロシア語(FGOS 1〜2年級)、ベトナム語(MOET 1〜2年級)を網羅します。各グラフは有向非巡回グラフ(DAG)で、ノード数380〜820、エッジ数1,200〜2,600、各ノードの難度推定をPenLitEvalで較正しています。
バイヤーはカスタムカリキュラムグラフを言語あたり$14,000〜$28,000でライセンスできます。OEMダッシュボードは.dot Graphviz形式でのグラフインポートに対応し、ファームウェアへ展開する前にグラフがDAGであることを検証します。グラフはOIDルックアップテーブルおよび言語パックと共にNORフラッシュに保存されます。
6. 成功の測定方法:4つのKPIレジスター
アダプティブアルゴリズムは計測と同等の価値しかありません。当社はファームウェアバージョンごとに4つのKPIレジスターを公開しています。レジスター1(学習ゲイン)は12週間介入でのスキル別習得度デルタを報告します。レジスター2(エンゲージメント)はセッション継続時間、週あたりセッション数、離脱パターンを報告します。レジスター3(カバレッジ)はカリキュラムグラフが集団全体でどれだけ均一に行使されているかを報告します。レジスター4(安全性)は発音スコアラーの偽陽性率および「frustration patterns」(1スキルに3週間以上停滞している子ども)の割合を報告します。
| KPIレジスター | 2026年ターゲット | 参照 |
|---|---|---|
| 学習ゲイン(12週間) | 対照群比 +0.34 SD | L5フィールドパイロット |
| 児童あたり週あたりセッション数 | 4.6-6.0 | 2025年第3四半期+第4四半期 出荷 |
| フラストレーション発生率 | <2.4% | 2025年〜2026年 K7+KF1 |
| 発音誤検出 | <3.2% | Y6 PronunciationScorer 2026 |
導入効果を自社で計測するバイヤーは、OEMパートナーに対してデータエクスポートから14日以内に生成される導入別KPIレジスターを依頼してください。OEMポータルはデフォルトで18か月間データを保管し、EU AI法ティア2の導入については7年まで延長可能です。
7. コールドスタート:開封後30分間の挙動
アダプティブアルゴリズムにとって最も厳しい試練は、開封直後の30分間です。この間アルゴリズムは子どもに関するデータを0しか持っておらず、推測しなければなりません。弊社方式は5段階のコールドスタートです。ステップ1(0-5分)子どもの声に発音スコアラーをキャリブレーションするため、6語のキャリブレーション単語の読み上げを依頼。ステップ2(5-15分)カリキュラムグラフ上18語によるプレースメントクイズを実施し、既習知識を推定。ステップ3(15-25分)プレースメント結果に基づき難易度を割り当て。ステップ4(25-30分)最初の「ストレッチ + チャレンジ + 復習」ページセットを配信。実機データ:セッション中に86%の子どもがステップ4まで到達。ステップ1の声キャリブレーションをスキップまたは失敗した14%は2回目のセッションが必要でした。
コールドスタート設計は読書ペン ファームウェア アーキテクチャに文書化され、OEM SDKで公開されています。
8. リーディング流暢度の成果:学級あたり8名の追加到達
リーディング流暢度は学年相応のテキストにおける1分あたりの正読語数(WCPM)で測定されます。2025-2026年の複数地域パイロットにおいて、アダプティブ学習搭載のL5 reading penを使用した場合、12週間の介入で18.4-26.6 WCPMの伸びを示しました。非アダプティブのreading penを使用した対照群は9.4-13.2 WCPMの伸びにとどまっています。効果サイズは標準偏差0.34で、What Works Clearinghouseでは教育研究上「中程度から大」に相当します。100名の学級において、この効果サイズは post-test で「学年水準未満」から「学年水準以上」に移行する児童を8名増やします。この数値は3,000語の議論全体の中で最も調達実務に直結する指標です。


9. エンゲージメントへの影響:アダプティブがセッション時間を伸ばす仕組み
セッションの長さと頻度は、あらゆるリーディング介入の先行指標です。2026年のブラジル、韓国、サウジアラビア、スペイン、米国の複数地域パイロット(児童4,800名)において、アダプティブ学習搭載のL5を使う子どもは週5.4セッション、各14.8分という中央値を示しました。B1対照群では週3.2セッション、各11.6分でした。合計すると週間アクティブ読書時間は1.69倍です。理由は明快で、4状態インジケーターがフラストレーションを防ぎ、カリキュラムグラフが退屈を防ぐためです。フラストレーションと退屈は子どもが読書チューターをやめる二大原因です。
バイヤーへのヒント:脱落は学校のリーディングプログラムを静かに潰します。「平均的な子どもが週に何回セッションを完了するか」をバイヤーが尋ねる場合、アダプティブ搭載L5は5.4回、非搭載B1は3.2回が答えです。30週の学年に換算するとL5の子どもは162セッション、B1の子どもは96セッションになります。
10. 多言語・バイリンガル学習者:アルゴリズムの異なる挙動
英語-スペイン語のバイリンガル学習者は2つの言語パックを同時に使用します。英語語彙用とスペイン語語彙用です。アルゴリズムは2つの並列状態ベクトルを維持し、言語間干渉(例:スペイン語話者の英語学習者に見られる /v/ と /b/ の混同)を検出する言語間転移レイヤーを実行します。干渉が検出されると、アルゴリズムは影響を受けた音素の誤検知 pronunciationスコアリングの頻度を下げ、対象を絞った音素識別ドリルを挿入します。実機データ:K7-Spanishコホートのバイリンガル学習者は、同期間におけるモノリンガルの英語学習者より音素識別力の伸びが22%速いことが示されています。
11. アルゴリズムが対応するエッジケース
3つのエッジケースにそれぞれ一項を割く価値があります。(a) ギフテッド(飛び級)読者:在籍学年より2.5学年上を reading する子どもはK7-Grade-1グラフを4-6週で使い切ります。アルゴリズムはこれを検出しGrade-2グラフを自動アンロックします。Grade-2グラフも6週以内に使い切った場合はGrade-3グラフをアンロックし、「above grade level」バッジを保護者に表示します。(b) 苦戦している読者:音声障害のある子どもが同一スキルで30回試行後も習熟度<40%というフラストレーション・パターンを示した場合、アルゴリズムは進捗を停止し、音素レベルのハイライトを保護者に表示して言語聴覚士による評価を推奨します。保護者が明示的に同意しない限り、ハイライトデータは収集しません。(c) 不安定な読者:週あたりセッション数の変動が±35%にのぼる子どもは、習熟度の分散>0.4 SDを示します。アルゴリズムは直近の安定した習熟度状態までロールバックしプレースメントクイズを再実行します。これにより進捗が失われたかのような印象を防ぎます。
12. 学校カリキュラムとの統合
reading penは周辺機器であり、対応するカリキュラム次第で価値が決まります。2026年モデルのペンはpublisherのコンテンツパックと2つの形式で統合します。(a) .bookpack形式:OID表、ページ画像、オーディオMP3、.dot形式のカリキュラムグラフノードを含むZipバンドル。(b) live-link API:OEMポータルをpublisherのコンテンツ管理システムに接続し、毎週の新語彙を取得します。5,000ユニットの学校プログラムでは一般的に学期ごとに学年別.bookpack 1個、K-5導入で計10個のbookpackを配備します。各bookpackは380 MB~1.4 GBで、USB-CスティックまたはWi-Fiダウンロードで納品します。
13. アダプティブ学習データのプライバシー境界
アダプティブ学習のテレメトリはLLM音声経路と同じ地域別オーバーレイの対象です。EU/GDPR-K、US/COPPA、中国/PIPL、ブラジル/LGPD、韓国/PIPA、シンガポール/PDPAがすべて適用されます。OEMポータルはデフォルトで18か月保管し、AI法ティア2の導入では7年延長が可能です。ポータルは保護者データエクスポート要求に対応し、子どもの状態ベクトルとセッション別テレメトリを含むZipバンドルを返します。保護者データ削除要求は14日以内に該当パーティションを空にします。プライバシー通知、保護者同意画面フロー、地域別データレジデンシーマップ、地域別サブプロセッサ契約リストを含むOEMガバナンスパックを出荷済みです。契約リストは読書ペン AI 連携ロードマップ.
14. アダプティブ学習ペン向けOEMプロジェクト計画
| プロジェクトフェーズ | 期間 | 成果物 |
|---|---|---|
| 調査 | 2週間 | RFPギャップ分析、コンテンツ監査 |
| アルゴリズム調整 | 4週間 | カリキュラムグラフのインポート、BKT適合、カスタムベンチマーク実行 |
| 遠隔計測の統合 | 3週間 | OEMポータル、保護者・教師向けダッシュボード |
| ベータ展開 | 4週間 | ペン50本、教室5室、KPI登録 |
| 量産対応 | 6週間 | コンテナビルド、AQL II 受入検査 |
| 全体スケジュール | 19週間 | OEM最小ロット 5,000台 |
15. 参考事例と意思決定の要約
意思決定の要約は簡潔です。適応学習と任意のクラウド分析にはL5を選択。予算を抑えて適応学習を導入する場合はK7またはQ6を選択。バイリンガルプログラムにはKF1を選択。適応学習にはNPU非搭載のB1、B2、F8、P2を避けてください。RFQではPenLitEvalバッジを受入基準としてご指定ください。アルゴリズム選定は、OEM 読書ペンプログラムと読書ペン AI 連携ロードマッププログラムと併せてご活用ください。出版社の皆さま向けのエントリーポイントはODM 読書ペンで、コンテンツパックツールも含まれます。