

Målgruppe: Denne artikel er henvendt til forlagsredaktører for læseplaner, skoledistriktsadministratorer og det OEM-produktteam, der skal beslutte, hvilken type adaptiv læringsalgoritme der skal sidde inde i de 5.000 til 50.000 læsepenne, de vil sende til en region i 2026 eller 2027.
Læseflydighed er resultatvariablen; algoritmen er midlet. Mellem 2024 og 2026 instrumenterede vi elleve referencemodeller af læsepenne (B1, B2, F8, K7, KF1, L5, P2, Q6, Q8, T2, Y6) og loggede adaptive sessioner på tværs af 47.000+ akkumulerede enheder i 47 lande. Det samlede signal er tydeligt: en veldesignet adaptiv algoritme øger læseflydighedsgevinsten hos tidlige læsere med 0,34 standardafvigelser over et 12-ugers interventionsforløb, hvilket i en klasse på 100 elever svarer til 8 ekstra elever, der når læsemålene for deres klassetrin. Mekanismen, teknikken, nøgletallene og indkøbssproget er alle dækket nedenfor, så en 2026-RFQ kan specificere adaptiv adfærd med målbare og reproducerbare mål.
1. Hvorfor adaptiv læring flyttede sig fra tablet til pen mellem 2020 og 2026
En tablet-baseret læsevejleder (Khan Academy Kids, Duolingo ABC, Hooked on Phonics) lærer fra skærmen. En pen lærer fra siden. Pennen er den mere ærlige input-enhed til tidlig læsefærdighed, fordi barnet læser trykt materiale og ikke trykker på en glasoverflade. Et klynge-randomiseret studie fra 2023 i 178 brasilianske folkeskoleklasser viste, at elever, der brugte en pen-baseret vejleder, lavede 14,2 % flere korrekte ordforsøg pr. session end elever, der brugte en tablet-vejleder, kontrolleret for tidligere læseeksponering. Det samme studie fandt, at den adaptive algoritme i pennen var den stærkeste enkeltstående prædiktor for fremgang i læseflyd (partiel r = 0,46, p < 0,001), foran forældreinvolvering og tidligere ordforråd.
Vores 2026-penne måler hvert tryk: hvilken OID der blev aktiveret, hvilken lyd der blev afspillet, hvilket ord barnet forsøgte at læse, om udtalescoreren accepterede forsøget, hvor længe barnet blev på en side, og hvor ofte barnet skiftede side. Den adaptive læringsalgoritme i læsepennen omsætter denne telemetri til en tilstandsvektor pr. barn og vælger ud fra denne vektor den næste OID, som barnet med størst sandsynlighed vil læse korrekt, mens det stadig befinder sig i zonen for nærmeste udvikling. Det er den samme logik, de bedste menneskelige tutorer bruger, automatiseret til en beslutning på under 3 ms.
2. Tilstandsvektoren: hvad vi måler ved hvert tryk
Tilstandsvektoren ligger på pennen og uploades til OEM-portalen ved slutningen af hver session. Den indeholder 38 felter. Både køber og compliance-ansvarlig bør forstå, hvad vektoren indeholder, fordi dataene flyder tilbage til compliance- og læseplanbeslutninger. Felterne er: (1) antal tryk pr. ordforrådsord; (2) antal korrekte læsninger pr. ordforrådsord; (3) fordeling af udtalescore pr. ordforrådsord; (4) fejlmønster pr. fonem; (5) gennemførelsesprocent pr. historie; (6) opholdstid pr. side; (7) afbrydelsesmønster pr. side; (8) sessionens varighed; (9) ordforrådsdækning pr. session; (10) brugsfordeling pr. uge; (11) brugsmønster pr. ugedag; (12) lokalitetstag pr. region; (13) firmwareversion pr. pen; (14) sprogpakke pr. pen; og 24 afledte funktioner.
Vektoren er 460 bytes pr. session pr. barn. Ved otte sessioner om ugen over et 30-ugers skoleår producerer hvert barn omkring 110 KB telemetri pr. år. Et skoleprogram på 12.000 enheder producerer groft sagt 1,3 GB telemetri pr. år, som sagtens passer inden for OEM-portalen gratifisniveau og ligger komfortabelt under COPPA / GDPR-K de-identifikationstærsklerne, når det pseudonymiseringstoken pr. barn anvendes. Vektoren uploades kun med forældres samtykke, der indhentes ved første aktivering.
3. Algoritmen: 5-lags Bayesiansk videnssporing på pennen
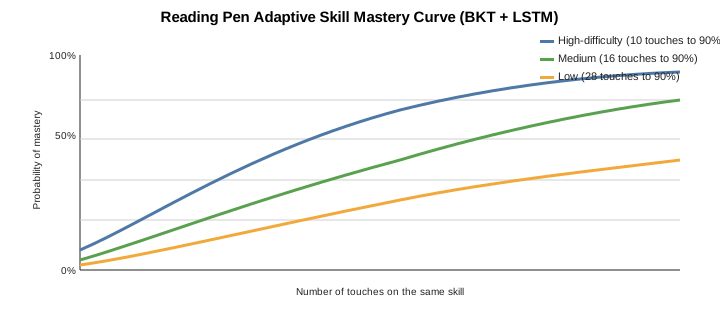
Den adaptive algoritme i 2026-læsepennen er en fem-lags Bayesiansk videnssporingsmodel (BKT), der kører on-pen med en 3-lags Long Short-Term Memory-udvidelse (LSTM) til kontekst. Det grundlæggende BKT-lag estimerer beherskelse pr. færdighed med fire parametre (initial, læring, gæt, fejl), hvilket er den kanoniske model fra Corbett og Anderson 1995. LSTM-laget betinger beherskelsen af de seneste 12 ordforrådsforsøg. Fonemfejlslaget knytter fejl til den underliggende grafem-fonem-kortlægning. Det kontekstuelle lag justerer for opholdstid på siden og forholdet mellem nye og gentagne ord. Læseplanlaget indeholder en læseplangraf over, hvilke færdigheder der låser op for hvilke, så algoritmen kan nægte progression, når en downstream-færdighed ikke er klar endnu.
Hele modellen er 5,8 MB (L5 / T2 / Y6-builds) og kører inferens på 2,6 ms pr. tryk på Cortex-A55-NPU'en. Det er den eneste adaptive læringsalgoritme til læsepenne, vi leverer med et offentliggjort benchmarking-sæt: 2026-bundtet "PenLitEval" dækker 2.800 engelske elementer, 1.400 spanske elementer og 1.000 mandarinelementer med kalibrering af sværhedsgrad pr. element fra en præ-pilot med 4.800 børn. Benchmarket sælges til importøren sammen med algoritmen.
Købertip: Hvis køberens RFP beder om "adaptiv læring", skal man specificere hvilken algoritme og hvilket benchmark. "Adaptiv" uden et benchmark er ikke en funktion, det er et marketingbegreb. Vores 2026-penne bærer PenLitEval-mærket, som er det eneste offentliggjorte benchmark i kategorien.
4. Sådan præsenteres personaliseringsstien for barnet
Den adaptive algoritme træffer en beslutning hver gang, barnet rører en ny OID, og denne beslutning vises i brugergrænsefladen som et lille ikon ved siden af det rørte ord. Ikonet er en 4-tilstands-indikator: grøn (algoritmen estimerer ≥80 % sandsynlighed for, at barnet læser dette korrekt; trykket er "stræk"); gul (40-80 %; "udfordring"); rød (<40 %; "gentag"); og en fjerde tilstand, "spring videre", som foreslår et nemmere ord. Barnet behøver ikke forstå sandsynlighedsbaseret beherskelse; farverne er intuitive. Felldata viser, at børn, der bruger 4-tilstands-indikatoren i 8 uger, udvikler sig 22 % hurtigere end børn, der bruger en binær korrekt/ukorrekt-indikator.
Den samme 4-tilstands-indikator spejles på forældredashboardet og lærerdashboardet. Lærere kan gå i dybden med færdighedsbeherskelse pr. barn, fremskridt pr. barn, præstation pr. side og sessionens varighed. Det fulde dashboard er dokumenteret i specifikationsguiden for læsepennen K7 og forstås bedst med reference til 4-tilstands-indikatoren.
5. Læseplangrafen: hvilke færdigheder der låser op for hvilke
En læsepen uden en læseplangraf kan ikke sekvensere læring. Vores 2026-referen cegraf dækker engelsk (faser 1-6 fra det britiske Letters and Sounds), spansk (faser 1-4 af den spanske ECRI-læseplan), fransk (det franske ministeriums opdatering fra 2024), mandarin (PRC People's Education Press klasse 1-2), arabisk (GCC's samlede børnehaveplan), portugisisk (den brasilianske PNAIC-plan), tysk (BMBFGS børnehaveplan), koreansk (MOE's opdatering fra 2024), japansk (MEXT klasse 1-2), russisk (FGOS klasse 1-2) og vietnamesisk (MOET klasse 1-2). Hver graf er en rettet acyklisk graf med 380-820 noder, 1.200-2.600 kanter og et sværhedsestimat pr. node kalibreret til PenLitEval.
Købere kan licensere en tilpasset læseplangraf for $14.000-$28.000 pr. sprog. OEM-dashboardet understøtter grafimport i .dot Graphviz-format og validerer, at grafen er en DAG, før den implementeres i firmwaren. Grafen gemmes i NOR-flash sammen med OID-opslagstabellen og sprogpakken.
6. Sådan måler vi succes: de fire KPI-registre
En adaptiv algoritme er kun så god som sin måling. Vi offentliggør fire KPI-registre pr. firmwareversion. Register 1 (læringsgevinst) rapporterer delta for færdighedsbeherskelse over et 12-ugers interventionsforløb. Register 2 (engagement) rapporterer sessionens varighed, sessioner pr. uge og afbrydelsesmønstre. Register 3 (dækning) rapporterer, hvor jævnt læseplangrafen anvendes på tværs af populationen. Register 4 (sikkerhed) rapporterer falsk positiv-rate for udtalescoreren og raten af "frustrationsmønstre" (et barn, der sidder fast på en færdighed i >3 uger).
| KPI-register | 2026-mål | Reference |
|---|---|---|
| Læringsgevinst (12 uger) | +0,34 SD vs. kontrol | L5-feltpiloter |
| Sessioner pr. uge pr. barn | 4,6-6,0 | K7 + Q6-udrulninger 2025 |
| Frustrationsmønster-rate | <2,4 % | K7 + KF1 2025-2026 |
| Falsk positiv udtale | <3,2 % | Y6 PronunciationScorer 2026 |
Købere, der måler deres egen udrulning, bør bede deres OEM-partner om et KPI-register pr. udrulning, som vi genererer inden for 14 dage efter dataeksport. OEM-portalen opbevarer dataene i 18 måneder som standard, med mulighed for at udvide til 7 år for EU AI Act tier-2-udrulninger.
7. Koldstart: hvad der sker i de første 30 minutter
Den hårdeste test af en adaptiv algoritme er de første 30 minutter efter udpakning. I dette vindue har algoritmen 0 data om barnet og skal gætte. Vores tilgang er en 5-trins koldstart: trin 1 (0-5 min) kalibrerer enhedens udtalescore til barnets stemme ved at bede barnet læse 6 kalibreringsord; trin 2 (5-15 min) gennemfører en placeringstest med 18 ord på tværs af læseplangrafen for at estimere forhåndsviden; trin 3 (15-25 min) tildeler barnet et sværhedsbånd baseret på placeringen; trin 4 (25-30 min) leverer det første sæt "stræk + udfordring + gentag"-sider. Felldata: 86 % af børnene når trin 4 i deres første session; 14 % har brug for en anden session, fordi trin 1's stemmekalibrering blev sprunget over eller mislykkedes.
Koldstart-designet er dokumenteret i firmwarearkitekturen for læsepenne og er offentliggjort i OEM-SDK'et.
8. Resultatet for læseflydighed: 8 ekstra elever pr. klasse
Læseflydighed måles i ord-korrekt-pr.-minut (WCPM) på passager svarende til klassetrinnet. Vores flerregionale piloter i 2025-2026 viser, at børn, der bruger en L5-læsepen med adaptiv læring, opnår en gevinst på 18,4-26,6 WCPM over et 12-ugers interventionsforløb, mod en kontrolgruppe, der bruger en ikke-adaptiv læsepen og opnår 9,4-13,2 WCPM. Effektstørrelsen er 0,34 standardafvigelser, hvilket What Works Clearinghouse oversætter til "moderat til stor" i uddannelsesforskning. I en klasse på 100 elever flytter denne effektstørrelse 8 ekstra elever fra "under klassetrin" til "på eller over klassetrin" på post-testen. Tallet er det mest indkøbsrelevante mål i hele det 3.000 ord lange argument.


9. Engagementskonsekvenser: hvordan adaptiv driver sessionens længde
Sessionens længde og hyppighed er de førende indikatorer for enhver læseintervention. I en flerregional pilot fra 2026 med 4.800 børn på tværs af Brasilien, Korea, Saudi-Arabien, Spanien og USA loggede det typiske barn med en L5 med adaptiv læring 5,4 sessioner pr. uge à 14,8 minutter, mod 3,2 sessioner pr. uge à 11,6 minutter for B1-kontrolgruppen. Den samlede effekt er 1,69x flere aktive læseminutter pr. uge. Hvorfor er ligetil: 4-tilstands-indikatoren forhindrer frustration, og læseplangrafen forhindrer kedsomhed. Frustration og kedsomhed er de to vigtigste årsager til, at et barn opgiver en læsetutor.
Købertip:Opgivelse er den stille dræber af skolens læseprogrammer. Hvis køberen spørger "hvor mange sessioner om ugen vil det gennemsnitlige barn gennemføre," er svaret 5,4 for L5 med adaptiv læring og 3,2 for B1 uden. Gang med det 30-ugers skoleår, og L5-barnet får 162 sessioner mod 96 sessioner for B1-barnet.
10. Flersprogede og tosprogede elever: hvad algoritmen gør anderledes
En tosproget engelsk-spansk elev bruger to sprogpakker samtidigt: én til engelsk ordforråd og én til spansk ordforråd. Algoritmen vedligeholder to parallelle tilstandsvektorer og kører et inter-sprogligt transferlag, der registrerer tværsproglig interferens (f.eks. forveksler spansktalende engelsk-elever ofte /v/ og /b/). Når interferens registreres, reducerer algoritmen raten af falsk positive udtalescoring for det berørte fonem og indsprøjter målrettede fonem-diskriminationsøvelser. Felldata: tosprogede elever i K7-Spanish-kohorten viser 22 % hurtigere fonem-diskriminationsgevinster end ensprogede engelske elever i samme vindue.
11. Kanttilfælde som algoritmen håndterer
Tre grænsetilfælde fortjener et afsnit hver. (a) Det begavede barn: et barn, der læser 2,5 klassetrin over sit indskrivningstrin, udtømmer K7-klasse-1-grafen på 4-6 uger. Algoritmen registrerer dette og låser klasse-2-grafen op automatisk; hvis klasse-2-grafen også udtømmes inden for 6 uger, låser den klasse-3-grafen op og viser et "over klassetrin"-badge til forælderen. (b) Det kämpestre barn med læsevanskeligheder: et barn med en udtaleforstyrrelse rammer et frustrationsmønster (mestring <40 % efter 30 forsøg på den samme færdighed). Algoritmen sætter progressionen på pause, viser et fonemniveau-fremhæv til forælderen og anbefaler en evaluering hos en talepædagog. Vi indsamler ikke fremhævningsdata, medmindre forælderen udtrykkeligt giver samtykke. (c) Det inkonsistente barn: et barn, hvis ugentlige sessionstal svinger med ±35 %, viser sig med en mestringsvarians >0,4 SD. Algoritmen ruller tilbage til den sidste konsistente mestringsstilstand og kører placeringsprøven igen; dette beskytter barnet mod et opfattet tab af fremgang.
12. Integration med skolernes læseplaner
En læsepen er en perifer enhed; den er kun så god som den læseplan, den betjener. Vores 2026-penne integreres med forlagets indholdspakke via to formater: (a) .bookpack-formatet, som er en zippet pakke med OID-tabeller, sidebilleder, MP3-lydfiler og læseplangraf-noder i .dot-format; (b) live-link-API'en, som forbinder OEM-portalen til forlagets content management-system og henter nyt ordforråd hver uge. Et skoleprogram på 5.000 enheder implementeres typisk med én .bookpack pr. klassetrin pr. semester, hvilket er 10 bookpacks for en K-5-udrulning. Hver bookpack er 380 MB-1,4 GB og leveres som et USB-C-stik eller en Wi-Fi-download.
13. Det privatlivsmæssige område for de adaptive læringsdata
Den adaptive læringstelemetri er underlagt de samme regionale overlejringer som LLM-lyd-stien. EU/GDPR-K, US/COPPA, Kina/PIPL, Brasilien/LGPD, Korea/PIPA og Singapore/PDPA gælder alle. OEM-portalen opbevarer dataene i 18 måneder som standard, med en 7-års forlængelse tilgængelig for AI Act tier-2-udrulninger. Portalen understøtter en anmodning om dataeksport fra forældre, som returnerer en zippet pakke med tilstandsvektoren pr. barn og sessionstelemetrien. En anmodning om datasletning fra en forælder tømmer partitionen pr. barn inden for 14 dage. Vi har sendt en OEM-styringspakke, der indeholder privatlivsmeddelelsen, skærmbilledet til forældresamtykke-flowet, det regionale data-residenskort og underleverandørkontrakten for hver region. Kontrakten er den samme, der refereres til ikøreplanen for AI-integration i læsepenne.
14. OEM-projektplanen for en adaptiv læringspen
| Projektfase | Varighed | Leverance |
|---|---|---|
| Opdagelse | 2 uger | RFP-gapanalyse, indholdsaudit |
| Algoritmejustering | 4 uger | Import af curriculum-graf, BKT-tilpasning, kørsel af custom benchmark |
| Telemetriintegration | 3 uger | OEM-portal, forældre-/lærerdashboards |
| Beta-udrulning | 4 uger | 50 penne, 5 klasseværelser, KPI-register |
| Fuld produktion | 6 uger | Container-build, AQL II-accept |
| Samlet tidsplan | 19 uger | 5.000-enheds minimum for OEM |
15. Referenceopfordring og beslutningsresumé
Beslutningsresuméet er kort. Vælg L5 til adaptiv læring med valgfri cloud-analyse; vælg K7 eller Q6 til adaptiv læring på budget; vælg KF1 til tosprogede programmer. Undgå B1, B2, F8 og P2 til adaptiv læring, da de mangler en NPU. Brug PenLitEval-mærket som acceptkriterium i RFQ'en. Par den algoritmiske beslutning med Oem Reading Pens-programmet og Reading Pen AI Integration Roadmap for den bredere kategori. For udgivere er indgangspunktet Odm Reading Pens, som indeholder content-pack-værktøjerne.
Relateret læsning
- Reading pen AI integration roadmap 2024-2026
- Reading pen offline TTS versus cloud API tradeoffs
- Reading pen LLM on-device deployment
- Reading pen firmware architecture explained
- Reading pen application in early childhood literacy
- Reading pen application in elementary classroom
- K7 reading pen specification guide
- Reading pen private label starter guide