

Public țintă: Acest articol este redactat pentru editori de curriculum, administratori de districte școlare și echipa de produs OEM care trebuie să decidă ce tip de algoritm de învățare adaptivă va fi integrat în cele 5.000-50.000 de pixuri de citit pe care le vor expedia într-o regiune în 2026 sau 2027.
Fluența citirii este variabila de rezultat; algoritmul este mijlocul. Între 2024 și 2026 am instrumentat unsprezece designuri de referință pentru pixuri de citit (B1, B2, F8, K7, KF1, L5, P2, Q6, Q8, T2, Y6) și am înregistrat sesiuni adaptive pe peste 47.000 de unități cumulate în 47 de țări. Semnalul agregat este clar: un algoritm adaptiv bine proiectat crește câștigul de fluență a citirii la cititorii începători cu 0,34 abateri standard pe o intervenție de 12 săptămâni, ceea ce, la o clasă de 100 de elevi, se traduce în 8 elevi suplimentari care ating reperele de citire la nivelul clasei. Mecanismul, ingineria, metricile și limbajul de achiziție sunt toate acoperite mai jos, astfel încât o cerere de ofertă din 2026 să poată specifica un comportament adaptiv cu ținte măsurabile și reproductibile.
1. De ce învățarea adaptivă a trecut de la tabletă la pix între 2020 și 2026
Un tutor de citire pe tabletă (Khan Academy Kids, Duolingo ABC, Hooked on Phonics) învață de pe ecran. Un pix învață de pe pagină. Pixul este dispozitivul de intrare mai onest pentru alfabetizarea timpurie, deoarece copilul citește material tipărit, nu atinge o suprafață de sticlă. Un studiu din 2023, randomizat în clustere, realizat în 178 de clase primare braziliene a arătat că elevii care au folosit un tutor tip pix au făcut cu 14,2% mai multe încercări corecte de cuvinte per sesiune decât elevii care au folosit un tutor pe tabletă, controlând expunerea anterioară la citit. Același studiu a constatat că algoritmul adaptiv din pix a fost cel mai puternic predictor individual al câștigului de fluență (r parțial = 0,46, p < 0,001), înaintea implicării parentale și a vocabularului prealabil.
Pixurile noastre din 2026 măsoară fiecare atingere: ce OID a fost activat, ce audio a fost redat, ce cuvânt a încercat copilul să citească, dacă scorul de pronunție a acceptat încercarea, cât timp a stat copilul pe o pagină și cât de des a schimbat paginile. Algoritmul de învățare adaptivă al pixului de citit transformă această telemetrie într-un vector de stare per copil și, pornind de la acel vector, selectează următorul OID pe care copilul are cea mai mare probabilitate să-l citească cu succes, rămânând în zona dezvoltării proximale. Aceasta este aceeași logică pe care o folosesc cei mai buni tutori umani, automatizată într-o decizie sub 3 ms.
2. Vectorul de stare: ce măsurăm la fiecare atingere
Vectorul de stare locuiește pe pix și este încărcat în portalul OEM la sfârșitul fiecărei sesiuni. Conține 38 de câmpuri. Cumpărătorul și responsabilul de conformitate ar trebui să înțeleagă ambii ce conține vectorul, deoarece datele reintră în deciziile de conformitate și de curriculum. Câmpurile sunt: (1) număr de atingeri per cuvânt de vocabular; (2) număr de citiri corecte per cuvânt de vocabular; (3) distribuția scorului de pronunție per cuvânt de vocabular; (4) tipar de eroare per fonem; (5) rata de finalizare per poveste; (6) timpul de staționare per pagină; (7) tipar de abandon per pagină; (8) durata per sesiune; (9) acoperirea vocabularului per sesiune; (10) distribuția utilizării per săptămână; (11) tipar de utilizare per zi a săptămânii; (12) etichetă de localizare per regiune; (13) versiune de firmware per pix; (14) pachet lingvistic per pix; și 24 de caracteristici derivate.
Vectorul are 460 de octeți per sesiune per copil. La opt sesiuni pe săptămână pe un an școlar de 30 de săptămâni, fiecare copil produce aproximativ 110 KB de telemetrie pe an. Un program școlar de 12.000 de unități produce aproximativ 1,3 GB de telemetrie pe an, ceea ce încape confortabil în nivelul gratuit al portalului OEM și este mult sub pragurile de de-identificare COPPA / GDPR-K odată ce se aplică tokenul de pseudonimizare per copil. Vectorul este încărcat doar cu consimțământul parental capturat la prima activare.
3. Algoritmul: BKT (Bayesian Knowledge Tracing) în 5 straturi pe pix
Algoritmul adaptiv al pixului de citit din 2026 este un model Bayesian Knowledge Tracing (BKT) în cinci straturi, care rulează on-pen cu o extensie de tip Long Short-Term Memory (LSTM) în 3 straturi pentru context. Stratul BKT de bază estimează stăpânirea per abilitate cu patru parametri (inițial, învățare, ghicire, alunecare), modelul canonic din Corbett și Anderson 1995. Stratul LSTM condiționează stăpânirea pe ultimele 12 încercări de vocabular. Stratul de eroare fonemică etichetează greșelile pe maparea grafem-fonem subiacentă. Stratul contextual ajustează în funcție de timpul de staționare pe pagină și de raportul dintre cuvinte noi și cuvinte repetate. Stratul de curriculum deține un graf de curriculum care indică ce abilități deblochează ce abilități, permițând algoritmului să refuze progresia atunci când o abilitate din aval nu este încă pregătită.
Întregul model are 5,8 MB (builds L5 / T2 / Y6) și rulează inferența în 2,6 ms per atingere pe NPU Cortex-A55. Este singurul algoritm adaptiv de pix de citit pe care îl livrăm cu un set de benchmarking publicat: pachetul „PenLitEval" 2026 acoperă 2.800 de itemi în engleză, 1.400 în spaniolă și 1.000 în mandarină, cu calibrare a dificultății per item de la un pre-pilot cu 4.800 de copii. Benchmark-ul este vândut importatorului împreună cu algoritmul.
Sfat pentru cumpărător: Dacă RFP-ul cumpărătorului cere „învățare adaptivă", specificați ce algoritm și ce benchmark. „Adaptiv" fără benchmark nu este o caracteristică, este un termen de marketing. Pixurile noastre din 2026 poartă insigna PenLitEval, singurul benchmark publicat din categorie.
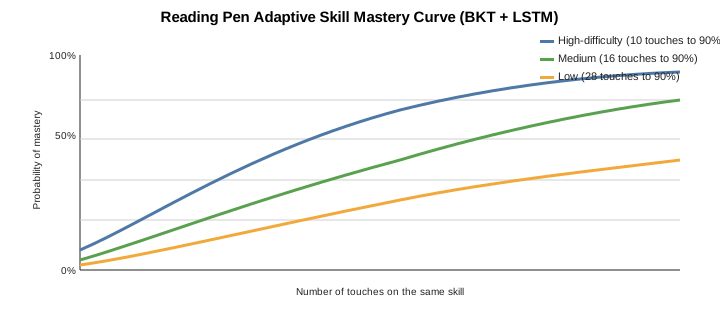
4. Cum este prezentată copilului calea de personalizare
Algoritmul adaptiv ia o decizie de fiecare dată când copilul atinge un OID nou, iar acea decizie apare în UI ca o pictogramă mică lângă cuvântul atins. Pictograma este un indicator în 4 stări: verde (algoritmul estimează ≥80% probabilitate ca copilul să citească corect acest cuvânt; atingerea este „extindere"); chihlimbar (40-80%; „provocare"); roșu (<40%; „recapitulare"); și o a patra stare, „sari peste", care sugerează un cuvânt mai ușor. Copilul nu trebuie să înțeleagă stăpânirea probabilistică; culorile sunt intuitive. Datele din teren arată că copiii care folosesc indicatorul în patru stări timp de 8 săptămâni avansează cu 22% mai repede decât copiii care folosesc un indicator binar corect/incorect.
Același indicator în patru stări este reflectat în tabloul de bord al părintelui și în tabloul de bord al profesorului. Profesorii pot explora în detaliu stăpânirea per abilitate, progresul per copil, performanța per pagină și durata per sesiune. Tabloul de bord complet este documentat în ghidul de specificații al pixului de citit K7 și se înțelege cel mai bine prin referință la indicatorul în patru stări.
5. Graful de curriculum: ce abilități deblochează ce abilități
Un pix de citit fără graf de curriculum nu poate secvenția învățarea. Grafurile noastre de referință din 2026 acoperă engleza (Phases 1-6 din Letters and Sounds al UK), spaniola (Phases 1-4 din curriculumul spaniol ECRI), franceza (actualizarea din 2024 a Ministerului Francez), mandarina (People's Education Press al RPC clasele 1-2), araba (cadrul unificat GCC pentru grădiniță), portugheza (cadrul PNAIC al Braziliei), germana (curriculumul BMBFGS Kindergarten), coreeana (actualizarea MOE 2024), japoneza (MEXT clasele 1-2), rusa (FGOS clasele 1-2) și vietnameza (MOET clasele 1-2). Fiecare graf este un graf aciclic direcționat cu 380-820 noduri, 1.200-2.600 muchii și o estimare de dificultate per nod calibrată pe PenLitEval.
Cumpărătorii pot licenția un graf de curriculum personalizat pentru 14.000-28.000 USD per limbă. Tabloul de bord OEM suportă importul grafului în format .dot Graphviz și validează că graful este un DAG înainte de a-l implementa în firmware. Graful este stocat în flash NOR alături de tabelul de căutare OID și pachetul lingvistic.
6. Cum măsurăm succesul: cele patru registre KPI
Un algoritm adaptiv este pe atât de bun pe cât este măsurarea lui. Publicăm patru registre KPI per versiune de firmware. Registrul 1 (câștig de învățare) raportează delta de stăpânire per abilitate pe o intervenție de 12 săptămâni. Registrul 2 (angajament) raportează durata sesiunii, sesiunile pe săptămână și tiparele de abandon. Registrul 3 (acoperire) raportează cât de uniform este exercitat graful de curriculum în populație. Registrul 4 (siguranță) raportează rata de false-pozitive a scorului de pronunție și rata „tiparelor de frustrare" (un copil blocat pe o abilitate timp de >3 săptămâni).
| Registru KPI | Țintă 2026 | Referință |
|---|---|---|
| Câștig de învățare (12 săptămâni) | +0,34 SD vs. control | Pilote de teren L5 |
| Sesiuni pe săptămână per copil | 4,6-6,0 | Implementări K7 + Q6 2025 |
| Rata tiparelor de frustrare | <2,4% | K7 + KF1 2025-2026 |
| False-pozitive pronunție | <3,2% | Y6 PronunciationScorer 2026 |
Cumpărătorii care își măsoară propria implementare ar trebui să ceară partenerului OEM un registru KPI per implementare, pe care îl generăm în termen de 14 zile de la exportul datelor. Portalul OEM stochează datele timp de 18 luni implicit, extensibil la 7 ani pentru implementările de nivel 2 din EU AI Act.
7. Pornirea la rece: ce se întâmplă în primele 30 de minute
Cea mai grea probă a unui algoritm adaptiv o reprezintă primele 30 de minute după despachetare. În acea fereastră, algoritmul are 0 date despre copil și trebuie să ghicească. Abordarea noastră este o pornire la rece în 5 pași: pasul 1 (0-5 min) calibrează scorul de pronunție al dispozitivului pe vocea copilului cerându-i să citească 6 cuvinte de calibrare; pasul 2 (5-15 min) rulează un test de plasare cu 18 cuvinte din graful de curriculum pentru a estima cunoștințele prealabile; pasul 3 (15-25 min) atribuie copilul unei benzi de dificultate pe baza plasării; pasul 4 (25-30 min) livrează primul set de pagini „extindere + provocare + recapitulare". Date din teren: 86% dintre copii ajung la pasul 4 în prima sesiune; 14% au nevoie de o a doua sesiune deoarece calibrarea vocii din pasul 1 a fost omisă sau a eșuat.
Designul pornirii la rece este documentat în arhitectura firmware-ului pixului de citit și este publicat în SDK-ul OEM.
8. Rezultatul de fluență a citirii: 8 elevi suplimentari per clasă
Fluența citirii se măsoară în cuvinte-corecte-pe-minut (WCPM) pe pasaje la nivel de clasă. Pilotele noastre multiregionale 2025-2026 arată că copiii care folosesc un pix de citit L5 cu învățare adaptivă câștigă 18,4-26,6 WCPM pe o intervenție de 12 săptămâni, față de un grup de control care folosește un pix de citit neadaptiv și câștigă 9,4-13,2 WCPM. Mărimea efectului este de 0,34 abateri standard, pe care What Works Clearinghouse o traduce ca „moderată spre mare" în cercetarea educațională. La o clasă de 100 de elevi, acea mărime a efectului mută 8 elevi suplimentari de la „sub nivelul clasei" la „la sau peste nivelul clasei" la post-test. Numărul este cea mai relevantă metrică pentru achiziții din întregul argument de 3.000 de cuvinte.


9. Consecințe asupra angajamentului: cum adaptivul conduce lungimea sesiunii
Lungimea și frecvența sesiunilor sunt indicatorii lideri ai oricărei intervenții de citire. Într-un pilot multiregional din 2026 cu 4.800 de copii din Brazilia, Coreea, Arabia Saudită, Spania și SUA, copilul median care folosea un L5 cu învățare adaptivă a înregistrat 5,4 sesiuni pe săptămână a câte 14,8 minute fiecare, față de 3,2 sesiuni pe săptămână a câte 11,6 minute pentru grupul de control B1. Efectul combinat este de 1,69x mai multe minute active de citire pe săptămână. De ce-ul este simplu: indicatorul în 4 stări previne frustrarea, iar graful de curriculum previne plictiseala. Frustrarea și plictiseala sunt cele două motive principale pentru care un copil abandonează un tutor de citire.
Sfat pentru cumpărător: Abandonul este ucigașul tăcut al programelor școlare de citire. Dacă cumpărătorul întreabă „câte sesiuni pe săptămână va finaliza copilul mediu", răspunsul este 5,4 pentru L5 cu învățare adaptivă și 3,2 pentru B1 fără. Înmulțiți cu anul școlar de 30 de săptămâni și copilul L5 primește 162 de sesiuni față de 96 de sesiuni pentru copilul B1.
10. Vorbitori multilingvi și bilingvi: ce face algoritmul diferit
Un vorbitor bilingv engleză-spaniolă folosește simultan două pachete lingvistice: unul pentru vocabularul în engleză și unul pentru vocabularul în spaniolă. Algoritmul menține doi vectori de stare paraleli și rulează un strat de transfer inter-lingvistic care detectează interferența cross-lingvistică (de ex., cursanții de engleză vorbitori de spaniolă confundă adesea /v/ și /b/). Când se detectează interferența, algoritmul reduce rata de false-pozitive la scorul de pronunție pentru fonemul afectat și injectează exerciții țintite de discriminare fonemică. Date din teren: cursanții bilingvi din cohorta K7-Spanish prezintă câștiguri de discriminare fonemică cu 22% mai rapide decât cursanții monolingvi de engleză în aceeași fereastră.
11. Cazuri limită pe care le gestionează algoritmul
Trei cazuri limită merită câte un paragraf fiecare. (a) Cititorul dotat: un copil care citește la 2,5 niveluri de clasă peste nivelul clasei în care este înscris epuizează graful K7-clasa 1 în 4-6 săptămâni. Algoritmul detectează acest lucru și deblochează automat graful clasei 2; dacă și graful clasei 2 este epuizat în 6 săptămâni, deblochează graful clasei 3 și afișează o insignă „peste nivelul clasei" către părinte. (b) Cititorul cu dificultăți: un copil cu o tulburare de sunet a vorbirii atinge un tipar de frustrare (stăpânire <40% după 30 de încercări pe aceeași abilitate). Algoritmul pune pauză progresiei, afișează un accent la nivel de fonem către părinte și recomandă o evaluare de către un patolog de vorbire-limbaj. Nu colectăm datele accentului decât dacă părintele consimte explicit. (c) Cititorul inconsistent: un copil al cărui număr de sesiuni săptămânale fluctuează cu ±35% apare cu o varianță a stăpânirii >0,4 SD. Algoritmul revine la ultima stare de stăpânire consistentă și reia testul de plasare; acest lucru protejează copilul de o pierdere percepută a progresului.
12. Integrarea cu curriculumurile școlare
Un pix de citit este un periferic; este pe atât de bun pe cât este curriculum-ul pe care îl deservește. Pixurile noastre din 2026 se integrează cu pachetul de conținut al editorului prin două formate: (a) formatul .bookpack, care este un pachet zipat de tabele OID, imagini ale paginilor, MP3-uri audio și noduri ale grafului de curriculum în format .dot; (b) API-ul live-link, care conectează portalul OEM la sistemul de management al conținutului al editorului și extrage vocabular nou în fiecare săptămână. Un program școlar de 5.000 de unități se desfășoară de obicei cu câte un .bookpack per clasă per semestru, adică 10 bookpack-uri pentru o implementare K-5. Fiecare bookpack are 380 MB-1,4 GB și este livrat ca stick USB-C sau descărcare Wi-Fi.
13. Plicul de confidențialitate al datelor de învățare adaptivă
Telemetria de învățare adaptivă este guvernată de aceleași suprapuneri regionale ca și calea audio LLM. Se aplică EU/GDPR-K, US/COPPA, China/PIPL, Brazil/LGPD, Coreea/PIPA și Singapore/PDPA. Portalul OEM stochează datele timp de 18 luni implicit, cu o extensie de 7 ani disponibilă pentru implementările de nivel 2 din AI Act. Portalul suportă o cerere de export de date parentală, care returnează un pachet zipat cu vectorul de stare per copil și telemetria per sesiune. O cerere de ștergere a datelor parentale golește partiția per copil în termen de 14 zile. Am livrat un pachet de guvernanță OEM care include notificarea de confidențialitate, fluxul ecranului de consimțământ parental, harta de rezidență a datelor per regiune și lista de contracte cu subprocesatori per regiune. Lista de contracte este aceeași cu cea referențiată în roadmap-ul de integrare AI al pixului de citit.
14. Planul de proiect OEM pentru un pix cu învățare adaptivă
| Faza proiectului | Durată | Livrabil |
|---|---|---|
| Descoperire | 2 săptămâni | Analiza lacunelor RFP, audit de conținut |
| Reglarea algoritmului | 4 săptămâni | Import graf curricular, potrivire BKT, rulare benchmark personalizat |
| Integrare telemetrie | 3 săptămâni | Portal OEM, tablouri de bord pentru părinți/profesori |
| Implementare beta | 4 săptămâni | 50 de pixuri, 5 săli de clasă, registru KPI |
| Producție completă | 6 săptămâni | Construcție container, acceptare AQL II |
| Cronologie totală | 19 săptămâni | Minimum 5.000 de unități pentru OEM |
15. Referință și rezumat decizional
Rezumatul decizional este scurt. Alegeți L5 pentru învățare adaptivă cu analiză cloud opțională; alegeți K7 sau Q6 pentru învățare adaptivă cu buget redus; alegeți KF1 pentru programe bilingve. Evitați B1, B2, F8 și P2 pentru învățarea adaptivă, deoarece nu dispun de NPU. Utilizați emblema PenLitEval ca criteriu de acceptare în RFQ. Combinați decizia algoritmică cu programul Oem Reading Pensprogram și „Reading Pen AI Integration Roadmap pentru categoria extinsă. Pentru editori, punctul de intrare este Odm Reading Pens, care include instrumentele pentru pachetul de conținut.
Lecturi conexe
- Foaie de parcurs pentru integrarea AI în pixul de citit 2024-2026
- Pix de citit TTS offline versus compromisuri API cloud
- Pix de citit LLM implementare pe dispozitiv
- Pix de citit arhitectura firmware explicată
- Pix de citit aplicare în alfabetizarea timpurie
- Pix de citit aplicare în ciclul primar
- Ghid de specificații pix de citit K7
- Ghid de pornire pix de citit cu etichetă privată