

대상 독자: 이 기사는 커리큘럼 출판사, 학군 관리자, 그리고 2026년 또는 2027년에 특정 지역에 출하할 5,000~50,000개의 읽기 펜 내부에 어떤 종류의 적응형 학습 알고리즘을 탑재할 것인지 결정해야 하는 OEM 제품 팀을 위해 작성되었습니다.
읽기 유창성은 결과 변수이며, 알고리즘은 수단입니다. 2024년부터 2026년 사이에 11개의 읽기 펜 레퍼런스 디자인(B1, B2, F8, K7, KF1, L5, P2, Q6, Q8, T2, Y6)을 계측하고 47개국 47,000개 이상의 누적 단위에서 적응형 세션을 기록했습니다. 종합적인 신호는 명확합니다: 잘 설계된 적응형 알고리즘은 12주 개입 기간 동안 초기 독자의 읽기 유창성 향상을 대조군 대비 0.34 표준편차 증가시킵니다. 이는 100명 학생 교실에서 8명의 추가 학생이 학년 수준 읽기 기준에 도달하는 것에 해당합니다. 메커니즘, 엔지니어링, 지표 및 조달 언어는 아래에 모두 다루며, 이를 통해 2026년 RFQ에서 측정 가능하고 재현 가능한 목표를 갖춘 적응형 동작을 명시할 수 있습니다.
1. 2020년부터 2026년 사이에 적응형 학습이 태블릿에서 펜으로 이동한 이유
태블릿 기반 읽기 튜터(Khan Academy Kids, Duolingo ABC, Hooked on Phonics)는 화면에서 학습합니다. 펜은 페이지에서 학습합니다. 펜은 조기 문해력을 위한 보다 정직한 입력 장치입니다. 아동이 유리 표면을 탭핑하는 것이 아니라 인쇄된 자료를 읽고 있기 때문입니다. 178개 브라질 초등학교 교실에서 수행된 2023년 군집 무작위 연구에서, 펜 기반 튜터를 사용하는 학생들이 이전 읽기 노출을 통제한 상태에서 세션당 태블릿 튜터 학생들보다 단어 시도를 14.2% 더 정확하게 수행했습니다. 같은 연구에서 펜의 적응형 알고리즘이 유창성 향상의 가장 강력한 단일 예측 인자(부분 r = 0.46, p < 0.001)였으며, 부모 참여 및 기존 어휘력을 앞섰습니다.
저희 2026년 펜은 모든 터치를 측정합니다: 어떤 OID가 활성화되었는지, 어떤 오디오가 재생되었는지, 아동가 시도한 단어가 무엇인지, 발음 채점기가 시도를 수락했는지 여부, 아동이 페이지에 머물른 시간, 아동이 페이지를 전환하는 빈도. 읽기 펜 적응형 학습 알고리즘은 이 원격 측정 데이터를 아동당 상태 벡터로 변환하고, 그 벡터에서 아동이 근접 개발 영역 내에 있으면서도 성공적으로 읽을 가능성이 가장 높은 다음 OID를 선택합니다. 이것은 최고의 인간 튜터가 사용하는 동일한 논리를 3ms 미만의 결정으로 자동화한 것입니다.
2. 상태 벡터: 매 터치에서 측정하는 것
펜에 상태 벡터가 저장되며 각 세션 종료 시 OEM 포털에 업로드됩니다. 총 38개 필드가 포함됩니다. 구매자와 준수 담당자는 모두 벡터에 포함된 내용을 이해해야 하며, 데이터는 준수 및 교육과정 결정에 다시 반영됩니다. 필드는 다음과 같습니다: (1) 어휘별 터치 횟수; (2) 어휘별 정확한 읽기 횟수; (3) 어휘별 발음 점수 분포; (4) 음소별 오류 패턴; (5) 이야기별 완료율; (6) 페이지별 체류 시간; (7) 페이지별 중단 패턴; (8) 세션별 지속 시간; (9) 세션별 어휘 포함률; (10) 주간 사용 분포; (11) 요일별 사용 패턴; (12) 지역별 로캘 태그; (13) 펜별 장치 펌웨어 버전; (14) 펜별 언어 팩; 그리고 24개의 파생 특성.
벡터는 세션당 아동당 460바이트입니다. 주 8회 세션, 30주 학년으로 계산하면 각 아동은 연간 약 110KB의 원격 측정 데이터를 생성합니다. 12,000대 학교 프로그램은 연간 약 1.3GB의 원격 측정 데이터를 생성하며, 이는 OEM 포털의 무료 티어에 맞물리며 아동별 의사 식별화 토큰이 적용되면 COPPA/GDPR-K 비식별화 임계값보다 훨씬 낮습니다. 벡터는 최초 활성화 시 포착된 부모 동의가 있는 경우에만 업로드됩니다.
3. 알고리즘: 펜의 5단계 베이지안 지식 추적
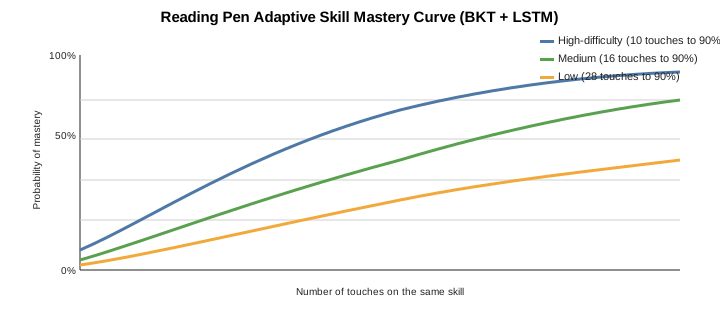
2026 읽기 펜의 적응형 알고리즘은 5층 Bayesian Knowledge Tracing (BKT) 모델로, 펜 내부에서 구동되며 3층 Long Short-Term Memory (LSTM) 확장을 통해 문맥을 처리합니다. 기본 BKT 층은 4개의 매개변수(초기, 학습, 추측, 실수)를 사용하여 기술별 숙련도를 추정하며, 이는 Corbett와 Anderson 1995의 정식 모델입니다. LSTM 층은 최근 12개의 어휘 시도 결과를 기반으로 숙련도를 조건화합니다. 음소‑오류 층은 잘못된 발음을 기본 글자‑음소 매핑에 태깅합니다. 문맥 층은 페이지 체류 시간과 새로운 단어와 반복 단어의 비율을 조정합니다. 교육과정 층은 어떤 기술이 어떤 기술을 해제하는지에 대한 교육과정 그래프를 보유하며, 이를 통해 하류 기술이 아직 준비되지 않은 경우 알고리즘이 진행을 거부합니다.
전체 모델은 5.8MB(L5/T2/Y6 빌드)이며 Cortex-A55 NPU에서 터치당 2.6ms 내에 추론을 실행합니다. 이는 게시된 벤치마킹 세트가 포함된 유일한 읽기 펜 적응형 알고리즘입니다: 2026년 "PenLitEval" 번들은 2,800개의 영어 항목, 1,400개의 스페인어 항목 및 1,000개의 만다린 항목을 포함하며, 4,800명 아동 사전 파일럿에서 항목별 난이도 보정이 이루어졌습니다. 벤치마크는 알고리즘과 함께 수입자에게 판매됩니다.
구매자 팁: 구매자의 RFP가 "적응형 학습"을 요청하는 경우, 어떤 알고리즘과 어떤 벤치마크인지 명시하세요. 벤치마크 없이 "적응형"은 기능이 아니라 마케팅 용어입니다. 당사의 2026년 펜은 이 범주에서 유일한 게시된 벤치마크인 PenLitEval 배지를 탑재하고 있습니다.
4. 아동에게 개인화 경로를 제시하는 방식
적응형 알고리즘은 아동이 새로운 OID를 터치할 때마다 결정을 내리며, 그 결정은 터치된 단어 옆에 작은 아이콘으로 UI에 표시됩니다. 아이콘은 4가지 상태 표시기입니다: 초록(알고리즘이 아동이 이것을 정확히 읽을 확률이 ≥80%로 추정; 터치는 "확장"); 호박색(40-80%; "도전"); 빨강(<40%; "복습"); 및 네 번째 상태인 "건너뛰기"는 더 쉬운 단어를 제안합니다. 아동은 확률적 숙련도를 이해할 필요가 없습니다; 색상은 직관적입니다. 현장 데이터에 따르면 4가지 상태 표시기를 8주간 사용하는 아동은 이진 정답/오답 표시기를 사용하는 아동보다 22% 더 빠르게 진보합니다.
동일한 4가지 상태 표시기는 부모 대시보드와 교사 대시보드에 미러링됩니다. 교사는 기술별 숙련도, 아동별 진도, 페이지별 성능 및 세션별 기간을 드릴다운할 수 있습니다. 전체 대시보드는 읽기 펜 K7 사양 가이드에 문서화되어 있으며 4가지 상태 표시기를 참조하여 이해하는 것이 가장 좋습니다.
5. 교육과정 그래프: 어떤 기술이 어떤 기술을 해제하는지
커리큘럼 그래프 없이 읽기 펜은 학습을 시퀀싱할 수 없습니다. 당사의 2026년 레퍼런스 그래프는 영어(영국 Letters and Sounds의 1-6단계), 스페인어(스페인 ECRI 커리큘럼의 1-4단계), 프랑스어(프랑스 교육부의 2024년 업데이트), 만다린(PRC People's Education Press 1-2학년), 아랍어(GCC 통합 유치원 범위), 포르투갈어(브라질 PNAIC 범위), 독일어(BMBFGS 유치원 커리큘럼), 한국어(교육부 2024년 업데이트), 일본어(메크스트 1-2학년), 러시아어(FGOS 1-2학년) 및 베트남어(MOET 1-2학년)를 다룹니다. 각 그래프는 380-820개의 노드, 1,200-2,600개의 에지, PenLitEval에 보정된 노드별 난이도 추정이 있는 방향성 비순환 그래프(DAG)입니다.
구매자는 언어당 $14,000-$28,000에 커스텀 커리큘럼 그래프를 라이선스할 수 있습니다. OEM 대시보드는 .dot Graphviz 형식의 그래프 가져오기를 지원하며 �irmware에 배포하기 전에 그래프가 DAG인지 검증합니다. 그래프는 OID 조회 테이블 및 언어 팩과 함께 NOR 플래시에 저장됩니다.
6. 성공 측정 방법: 네 가지 KPI 레지스터
적응형 알고리즘은 측정만큼만 좋습니다. 당사는 펌웨어 버전당 네 가지 KPI 레지스터를 게시합니다. 레지스터 1(학습 효과)은 12주 개입 기간 동안 기술별 숙련도 델타를 보고합니다. 레지스터 2(참여)는 세션 기간, 주당 세션 수 및 중단 패턴을 보고합니다. 레지스터 3(커버리지)는 커리큘럼 그래프가 인구 전체에서 얼마나 고르게 실행되는지를 보고합니다. 레지스터 4(안전성)는 발음 채점기의 오탐 비율과 "좌절 패턴" 비율(아동이 3주 이상 기술에 멈춰 있는 경우)을 보고합니다.
| KPI 레지스터 | 2026 목표 | 참조 |
|---|---|---|
| 학습 효과 (12주) | +0.34 SD 대조군 대비 | L5 현장 파일럿 |
| 아동당 주당 세션 수 | 4.6-6.0 | K7 + Q6 2025 배포 |
| 좌절 패턴 비율 | <2.4% | K7 + KF1 2025-2026 |
| 오탐 발음 | <3.2% | Y6 발음 채점기 2026 |
자체 배포를 측정하는 구매자는 OEM 파트너에게 배포당 KPI 레지스터를 요청해야 하며, 이는 데이터 내보내기 후 14일 이내에 생성됩니다. OEM 포털은 기본적으로 18개월간 데이터를 저장하며, EU AI 법안 2단계 배포의 경우 7년으로 연장할 수 있습니다.
7. 콜드스타트: 첫 30분 동안 일어나는 일
적응형 알고리즘의 가장 어려운 테스트는 개봉 후 첫 30분입니다. 그 시간창에서 알고리즘은 아동에 대한 0개의 데이터를 가지고 있으며 추측해야 합니다. 당사의 접근 방식은 5단계 콜드스타트입니다: 단계 1(0-5분) 아동에게 6개의 보정 단어를 읽도록 요청하여 장치의 발음 채점기를 아동의 음성에 보정합니다; 단계 2(5-15분) 커리큘럼 그래프에서 18개 단어의 배치 퀴즈를 실행하여 사전 지식을 추정합니다; 단계 3(15-25분) 배치를 기반으로 아동에게 난이도 밴드를 할당합니다; 단계 4(25-30분) 첫 번째 "확장 + 도전 + 복습" 페이지 세트를 제공합니다. 현장 데이터: 86%의 아동이 첫 번째 세션에서 단계 4에 도달합니다; 14%는 단계 1의 음성 보정이 건너뛰어지거나 실패했기 때문에 두 번째 세션이 필요합니다.
콜드스타트 설계는 다음에 문서화되어 있습니다 읽기 펜 펌웨어 아키텍처에 문서화되어 있으며 OEM SDK에 게시되어 있습니다.
8. 읽기 유창성 결과: 교실당 8명의 추가 학생
읽기 유창성은 학년 수준 지문에서 분당 정확 단어 수(WCPM)로 측정됩니다. 당사의 2025-2026 다지역 파일럿에서 적응형 학습이 적용된 L5 읽기 펜을 사용하는 아동은 12주 개입 기간 동안 18.4-26.6 WCPM을 얻는 반면, 비적응형 읽기 펜을 사용하는 대조군은 9.4-13.2 WCPM을 얻습니다. 효과 크기는 0.34 표준편차이며, 이는 What Works Clearinghouse가 교육 연구에서 "중간에서 큼"으로 번역합니다. 100명 학생 교실에서 그 효과 크기는 사후 검사에서 "학년 수준 미만"에서 "학년 수준 이상"으로 8명의 추가 학생을 이동시킵니다. 이 숫자는 전체 3,000단어 논의에서 가장 조달 관련성이 높은 지표입니다.


9. 참여 결과: 적응형이 세션 길이를 유도하는 방식
세션 길이와 빈도는 모든 읽기 개입의 선행 지표입니다. 브라질, 한국, 사우디아라비아, 스페인 및 미국에서 4,800명 아동을 대상으로 한 2026년 다지역 파일럿에서, 적응형 학습이 적용된 L5를 사용하는 중앙값 아동은 각각 14.8분씩 주 5.4세션을 기록한 반면, B1 대조군은 각각 11.6분씩 주 3.2세션을 기록했습니다._combined effect는 주당 1.69배 더 많은 활동 읽기 시간을 나타냅니다. 이유는 간단합니다: 4가지 상태 표시기가 좌절을 방지하고, 커리큘럼 그래프가 지루움을 방지합니다. 좌절과 지루움은 아동이 읽기 튜터를 포기하는 두 가지 주요 이유입니다.
구매자 팁:중단은 학교 읽기 프로그램의 조용한 살인자입니다. 구매자가 평균적인 아이가 주당 몇 번의 세션을 완료하는가라고 묻는다면, 적응형 학습이 적용된 L5는 5.4회, 적용되지 않은 B1은 3.2회입니다. 30주 학교 연도로 곱하면, L5 아이는 162세션을 받는 반면 B1 아이는 96세션을 받습니다.
10. 다국어 및 이중 언어 학습자: 알고리즘이 다르게 처리하는 방식
이중 언어 영어-스페인어 학습자는 두 개의 언어 팩을 동시에 사용합니다: 하나는 영어 어휘용, 하나는 스페인어 어휘용입니다. 알고리즘은 두 개의 병렬 상태 벡터를 유지하고 교차 언어 간섭을 감지하는 언어 간 전송 레이어를 실행합니다(예: 스페인어 사용 영어 학습자는 /v/와 /b/를 자주 혼동함). 간섭이 감지되면 알고리즘은 영향을 받는 음소에 대한 오탐 발음 채점 비율을 줄이고 표적 음소 식별 훈련을 주입합니다. 현장 데이터: K7-스페인어 코호트의 이중 언어 학습자는 같은 기간 동안 단일 언어 영어 학습자보다 22% 더 빠른 음소 식별 향상을 보입니다.
11. 알고리즘이 처리하는 엣지 케이스
세 가지 경계 사례가 각각 단락을 할애합니다. (a)천재 독자: 등록 학년보다 2.5학년 수준 이상으로 읽는 아이가 K7-1학년 그래프를 4~6주 내에 소진합니다. 알고리즘이 이를 감지하면 자동으로 2학년 그래프를 해제하고; 2학년 그래프도 6주 내에 소진되면 3학년 그래프를 해제하며 부모에게 "학년을 초과함" 배지를 표시합니다. (b)곤란한 독자: 음성‑음향 장애가 있는 아이가 같은 기술에 대해 30회 시도 후 숙련도가 40% 미만인 좌절 패턴에 도달합니다. 알고리즘은 진행을 일시 중단하고 부모에게 음소 수준 하이라이트를 표시하며, 언어‑병리 전문가의 평가를 권장합니다. 부모가 명시적으로 동의하지 않는 한 하이라이트 데이터를 수집하지 않습니다. (c)불규칙한 독자: 주간 세션 수가 ±35% 변동하는 아이는 숙련도 분산이 0.4 SD보다 크게 나타납니다. 알고리즘은 마지막 일관된 숙련도 상태로 롤백하고 배치 퀴즈를 다시 실행하여; 아이가 진보가 줄어든 것처럼 느끼는 것을 방지합니다.
12. 학교 커리큘럼과의 통합
읽기 펜은 주변 장치입니다; 그것은 서비스하는 커리큘럼만큼만 좋습니다. 당사의 2026년 펜은 두 가지 형식으로 출판사의 콘텐츠 팩과 통합됩니다: (a) .bookpack 형식으로, 이는 OID 테이블, 페이지 이미지, 오디오 MP3 및 .dot 형식의 커리큘럼 그래프 노드를 포함한 압축 번들입니다; (b) OEM 포털을 출판사 콘텐츠 관리 시스템에 연결하여 매주 새로운 어휘를 가져오는 라이브 링크 API입니다. 5,000대 학교 프로그램은 일반적으로 학기당 학년당 하나의 .bookpack을 배포하며, K-5 배포의 경우 10개의 bookpack입니다. 각 bookpack은 380MB-1.4GB이며 USB-C 스틱 또는 Wi-Fi 다운로드로 전달됩니다.
13. 적응형 학습 데이터의 프라이버시 범위
적응형 학습 원격 측정 데이터는 LLM 오디오 경로와 동일한 지역 오버레이의 적용을 받습니다. EU/GDPR-K, 미국/COPPA, 중국/PIPL, 브라질/LGPD, 한국/PIPA 및 싱가포르/PDPA가 모두 적용됩니다. OEM 포털은 기본적으로 18개월간 데이터를 저장하며, AI 법안 2단계 배포의 경우 7년 확장이 가능합니다. 포털은 부모 데이터 내보내기 요청을 지원하며, 이는 아동별 상태 벡터와 세션별 원격 측정 데이터의 압축 번들을 반환합니다. 부모 데이터 삭제 요청은 14일 이내에 아동별 파티션을 비웁니다. 당사는 프라이버시 고지, 부모 동의 화면 흐름, 지역별 데이터 상주 맵 및 지역별 하위 처리자 계약 목록을 포함한 OEM 거버넌스 팩을 출하했습니다. 계약 목록은 읽기 펜 AI 통합 로드맵.
14. 적응형 학습 펜에 대한 OEM 프로젝트 계획
| 프로젝트 단계 | 기간 | 산출물 |
|---|---|---|
| 탐색 | 2주 | RFP 격차 분석, 콘텐츠 감사 |
| 알고리즘 튜닝 | 4주 | 커리큘럼 그래프 가져오기, BKT 적합성 평가, 커스텀 벤치마크 실행 |
| 원격 측정 통합 | 3주 | OEM 포털, 학부모/교사 대시보드 |
| 베타 배포 | 4주 | 펜 50개, 교실 5개, KPI 등록 |
| 전체 생산 | 6주 | 컨테이너 빌드, AQL II 승인 |
| 전체 일정 | 19주 | OEM 최소 5,000대 |
15. 레퍼런스 호출 및 결정 요약
결정 요약은 간단합니다. 적응형 학습에는 선택적 클라우드 분석 기능이 있는 L5를 선택하세요; 제한된 예산의 적응형 학습에는 K7 또는 Q6를 선택하세요; 이중 언어 프로그램에는 KF1을 선택하세요. NPU가 없으므로 적응형 학습에는 B1, B2, F8 및 P2를 피하세요. RFQ의 수락 기준으로 PenLitEval 배지를 사용하세요. 알고리즘적 결정을 OEM 읽기 펜 프로그램 및 읽기 펜 AI 통합 로드맵와 함께 범주 전반에 적용하세요. 출판사의 경우 진입점은 ODM 읽기 펜이며, 콘텐츠 팩 툴링이 포함됩니다.