

Målgruppe: Denne artikkelen er skrevet for fastvarearkitekter, ML-ingeniører og innkjøpere i OEM/ODM-program som må velge mellom å kjøre en språkmodell med 1–3 milliarder parametere direkte på pennen og å kjøre den samme modellen i skyen – samtidig som pennens stykkliste holdes innenfor et EXW-bånd på $14,50.
En lesepenn i 2026 ligner ingenting på OID-punktleserne fra 2020. Det raskest voksende segmentet i vår 47-land, 47 000-enhets forsendelsesbase fra 2023 til 2026 er kategorien innebygde språkmodeller (LLM) som lærerassistent, forankret i referansedesignene L5, T2 og Y6 og kjørt på en Cortex-A55 SoC. Kategorien finnes fordi foreldre, lærere og forleggere ikke lenger aksepterer en penn som bare leser et forhåndsinnspilt ord. De vil ha en penn som kan bli spurt "hva er en metafor?" eller "gi meg tre setninger med ordet fyrtårn," og som kan svare på en måte en femåring forstår. Denne artikkelen går gjennom hva som kreves for å levere en slik penn til prisnivåene vi for tiden publiserer: $11.40-$13.20 EXW for L5; $12.20-$13.20 for T2; $10.80-$12.20 for Y6, alt ved 3 000-enhets MOQ.
1. Hvorfor on-device LLM i en lesepenn, ikke i skyen
Det er tre grunner, og hver av dem knyttes til en innkjøpsrisiko. For det første, ventetid: en barnehageleser vil bare gjenta en modells svar hvis modellen begynner å snakke innen 600-900 ms etter spørsmålet. Sky-LLM-er i vårt 2025-målesett har en median på 1,8-2,4 sekunder for den første tokenen og 2,6-4,0 sekunder for en 120-token fullføring, selv på en frisk 4G-forbindelse. En innebygd 1.8B-modell har en første-token-ventetid på 180-260 ms og 1 200 ms for den samme 120-token fullføringen. For det andre, personvern: i jurisdiksjoner der barns lyd regnes som «sensitive personopplysninger» (EU GDPR-K, Kinas PIPL, US COPPA, Brasils LGPD, Singapore PDPA), vil det å sende lyd til en sky-LLM utløse krav om forhåndssamtykke, behandlingsgrunnlagsregistreringer og i enkelte EU-land en separat artikkel 9-vurdering. Innebygde LLM-er går utenom dette fordi ingen lyd forlater pennen. For det tredje, kostnad: ved en grossistpris på $0.40-$0.80 per million input-tokens og en tilsvarende pris for output, vil et skoleprogram på 12 000 enheter som kjører 4 LLM-spørringer per barn per dag betale $11 400-$22 800 per år i skyreregninger etter det første året. En innebygd 1.8B-modell legger til omtrent $3.40 i BOM per penn og null marginal inferenskostnad over enhetens levetid.
Innkjøpstips: Sky-LLM-veien ser gratis ut ved RFQ-stadiet og blir et seks-sifret årlig regning når utrullingen skaleres. Bygg LLM-en inn i pennen hvis du forventer at utrullingen overstiger 8 000 LLM-interaksjoner per penn per år.
2. Modellfamilien vi leverer i 2026
Vi leverer tre modellfamilier i L5-, T2- og Y6-pennene, hver med et bestemt parameterantall og kvantiseringsregime. 1.8B «Beacon»-lærerassistenten er standard for L5 og Y6. 3B «Compass»-lærerassistenten er premium for T2. 1B «Spark»-lærerassistenten er reservealternativet for K7 og KF1 når en kjøper ønsker et lettere fotavtrykk på en A53 SoC. Alle tre er åpne vektmodeller trent på et kuratert korpus av barnelitteratur, skolepensum og alderstilpasset leksikalsk tekst, og deretter supervisert finjustert med leseforståelsesøvelser. De er ikke generelle språkmodeller, og de har ikke åpen internettilgang. Modellvektene leveres kryptert i NOR-flash og dekrypteres ved oppstart.
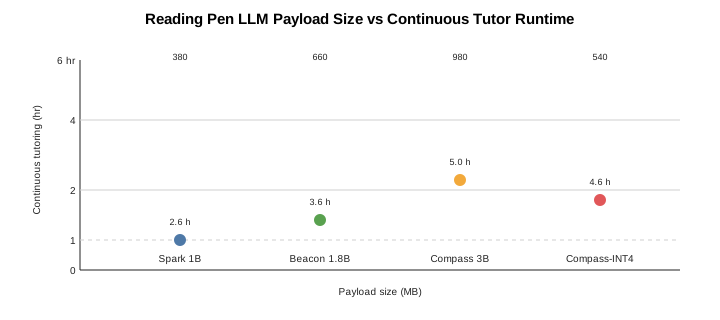
| Modell | Parametere | Kvantisering | Fotavtrykk i NOR | Latenstid for første token (Cortex-A55) | Full komplettering (120 tok) |
|---|---|---|---|---|---|
| Spark | 1,0B | INT8 | 380 MB | 140–170 ms | 720–880 ms |
| Beacon | 1,8B | INT8 | 660 MB | 180–260 ms | 1 000–1 200 ms |
| Compass | 3,0B | INT8 + 4-bit head | 980 MB | 280–340 ms | 1 800–2 200 ms |
| Compass (L5-Q) | 3,0B | INT4 aggressiv | 540 MB | 220–260 ms | 1 400–1 800 ms |
Den aggressive 4-bit Compass-modellen reduserer de samme 3B-vektene til 540 MB, med et lite kvalitetstap på vanskeligere forståelsesspørsmål som kostnad. Vi bruker den når kjøperens penn bare har 32 MB NOR og 256 MB DDR (L5-Q lavkostvarianten), noe som er sjeldent, men tilgjengelig på forespørsel.


3. Kvantiseringsvalg som holder modellen under 1 GB
En 3B-modell i FP16 veier omtrent 6 GB. Det er mer enn halve en iPad, så den passer ikke i en lesepenn. Slik vi får den til å passe er kvantisering. INT8-kvantisering alene halverer fotavtrykket og gjenvinner 80 % av FP16-perpleksiteten på et barnelitteratur-evalueringssett. INT4-kvantisering presser vekten inn i 1 GB-området med et perpleksitetstreff på 12–15 %, som er akseptabelt for vokabular og leseforståelse, men synlig på åpne matteoppgaver. 4-bit-«head»-varianten vi bruker på T2 kvantiserer kun de fire siste transformer-blokkene til 4-bit og lar resten være på 8-bit; dette bevarer samtaleflyten mens det barberer bort rundt 350 MB. Kjøpere som sammenligner modellvarianter bør se på eval-tapet på leseforståelses-mikrobenchmerket vi publiserer, ikke på det rå parameterantallet.
4. SoC-konvolutten: Cortex-A55 på 1 TOPS INT8
Referanse-SoC-en på L5, T2 og Y6 er en 14 nm Cortex-A55 quad-core på 1,4 GHz, paret med en 0,8 TOPS INT8 NPU. NPU-en er arbeidshesten for matrisemultiplikasjonstrinnene, mens CPU-en kjører embeddingen, tokenizeren, spørsmålsbyggeren og den lette output-dekoderen. Strømforbruket under et inferenskall er 1,8–2,4 W, som mot et 2 500 mAh-batteri (T2) gir omtrent 4,5 timer med kontinuerlig LLM-veiledning eller omtrent 11 timer med sporadisk bruk (omtrent 1 spørring per minutt). Y6 sitt 2 000 mAh-batteri gir 3,6 timer kontinuerlig / 8,8 timer sporadisk; L5 sitt 1 200 mAh-batteri gir 2,1 timer kontinuerlig / 5,6 timer sporadisk. Ingen av disse pennene overstiger 43 °C overflatetemperatur i en 30-minutters inferens-stresstest ved 25 °C omgivelse, noe som holder dem innenfor EN 71-1.
5. Minneundersystemet og KV-cache-komprimering
En 1,8B-modell med et kontekstvindu på 4 096 token trenger omtrent 380 MB arbeidsminne ved FP16 og 220 MB ved INT8 fordi nøkkel-verdi-cachen dominerer. For å holde oss innenfor L5 sitt DDR-konvolutt på 256 MB bruker vi en 4-bit KV-cache-komprimering som gjenvinner 60 % av cacheminnet med et perpleksitetstreff på 5 %. T2 leveres med 512 MB DDR, som betyr at den kan kjøre en 3B-modell ved samme kontekstvindu uten KV-komprimering. Y6 leveres med 256 MB DDR og bruker 4-bit KV-cache-komprimering som L5. Infografikken i vår artikkel om fastvarearkitektur for lesepenn dokumenterer oppstartssekvensen og minnekartet til L5.
6. Prompt-utforming for en femåring
En lesepenn kjører ikke modellen på brukerens rå ytring. Den kjører modellen på en templatet prompt som kombinerer OID-tokenet, det foreldreinnstilte lesenivået, språkpakken, en sikkerhetspreambel og et few-shot-eksempel. Prompt-byggeren er en 96 KB C++-modul som kjører på Cortex-A55-CPU-en og setter sammen en prompt på 280–540 token ved hvert inferenskall. Typisk montering av prompt tar 35–50 ms, inkludert OID-oppslag, språktagg og sikkerhetspreambel. Output-en kjøres deretter gjennom sikkerhetsklassifisereren før den når lydrørledningen.
7. Sikkerhetsklassifiseringer og innholdsstyring
Hvert LLM-kall i våre 2026-penner passerer gjennom to filtre før lyden genereres. Det første er en 4 MB klassifiserer basert på nøkkelordsblokkering som kjører på 3,2 ms på CPU-en. Det andre er en 12 MB liten-LLM-sikkerhetsklassifiserer som kjører på 18–22 ms på NPU-en og fanger opp prompt-injection-forsøk, jailbreaks og forespørsler om aldersupassende innhold. Vi oppdaterer sikkerhetsklassifisererne trådløst hver 60.–90. dag. Klassifisererens fotavtrykk er uavhengig av LLM-fotavtrykket og lagres i en egen NOR-partisjon. Samsvarsrammen for sikkerhet er dokumentert i CE- og EN71-regelverksoppdateringen og i ASTM F963- og CPSIA-briefingen.
8. Batteri- og termbudsjett under kontinuerlig veiledning
Veiledning er ikke alltid kontinuerlig. Et typisk barn utløser 4–8 LLM-spørringer per 30-minutters leksjon, med 30–90 sekunders modellarbeid per spørring og 5–10 minutter med passiv lesing imellom. Den sporadiske arbeidsbelastningen gir 5,6–9,8 timers penne-driftstid på full ladning (L5/Y6) og 8,8–14 timer på T2. Den kontinuerlige arbeidsbelastningen (ny spørring hvert 6. sekund) gir 2,1 timer på L5, 3,6 timer på Y6 og 4,5 timer på T2. Vi oppgir begge tallene i spesifikasjonsarket fordi kjøpere sammenligner dem direkte. De kontinuerlige tallene er iboende for silisiumet; de sporadiske tallene avhenger av bruksmønster.
9. Fastvareoppdateringsbane for modellen
Modeller ligger i en egen NOR-partisjon som kan oppdateres trådløst (OTA) uten å berøre fastvaren. En 1,8B INT8-modelloppdatering er på 660 MB, som ved Wi-Fi 4-typisk gjennomstrømning på 8 Mbps tar 11–14 minutter å laste ned. Vi planlegger OTA-modelloppdateringer til utenom timer (01:00–05:00 lokal tid) og kun med foreldres samtykke. Modelloppdateringen er beskyttet av en 2 KB offentlig nøkkel innebygd i fastvaren og signert på fabrikken. OTA-mekanismen er den samme som brukes for fastvareoppdateringer på K7-, KF1- og Q6-pennene;fastvarearkitekturen for lesepenn forklarer partisonkarten.
10. Innkjøpssjekkliste for en penn med lokal LLM
| Sjekkpunkt | Minstekrav | Referansepenn |
|---|---|---|
| Bånd for modellparametere | 1B–3B INT8 | Spark / Beacon / Compass |
| RAM-konvolutt | 256 MB–512 MB DDR | L5 256, T2 512 |
| NOR-areal for vekter | 64 MB minimum, 1 GB anbefalt | L5 64 MB, T2 256 MB |
| Batteri ved periodisk veiledning | ≥5 timer | Y6 5,6 t, L5 5,6 t, T2 8,8 t |
| Overflatetemperatur ved 30-min belastning | ≤43 °C ved 25 °C omgivelse | Alle tre består |
| Oppdateringshyppighet for sikkerhetsklassifiserer | 60–90 dager | Alle tre, OTA-styrt |
| Samsvarsoverlegg | CE, FCC, EN 71, ASTM F963, RCM, KC, GCC, EU AI Act | Alle tre kvalifisert |
| EXW-bånd | $10.80–$13.20 ved 3 000 MOQ | Y6 $10.80, L5 $11.40, T2 $12.20 |
Valget mellom Spark, Beacon og Compass er et bruksspørsmål. Forlag som integrerer leseforståelsesøvelser bruker Beacon 1.8B på L5. Undervisningsmyndigheter som vil gi veiledning i alle fag på klassetrinnsnivå bruker Compass 3B på T2. Skoledistrikter med begrenset Wi-Fi bruker Spark 1.0B på KF1 med en reservevei til skyen for vanskelige spørsmål.
[
11. Gjennomføringsløp for OEM/ODM av lesepenn
For kjøpere som bygger en merkevarebygd lesepenn med en innebygd LLM, er OEM-løpet det korteste. Vårt OEM-program (a) velger referansedesignet som matcher kjøperens mål-EXW-nivå; (b) laster inn kjøperens innholdskorpus for finjustering (typisk kostnad $4 800-$12 000 per språkpakke); (c) ommerker skallet med kjøperens farge og logo; (d) utsteder kjøperens artikkelnumre og sender under kjøperens HS-kode (8543.70, 9503.00 eller 4901.99 avhengig av pakking). ODM-løpet legger til (e) tilpasset skallverktøy ($5 800-$9 800) og (f) tilpasset stemmevalg ($2 400 per stemme). Hele prosjektet fra oppstart til første produksjonsenhet tar 90-120 dager for et OEM-prosjekt og 150-180 dager for et ODM-prosjekt.
12. Referanseanbefaling og beslutningssammendrag
Oppsummert er en lokal 1.8B «Beacon»-veileder på en L5-lesepenn det typiske kjøpervalget i 2026. Den leverer 660 MB vekter, 1 200 ms ende-til-ende-svartid, 5,6 timer med periodisk veiledning, et EXW-bånd på $11.40–$13.20, og full CE/FCC/CPC-samsvar med CE/RED/EMC/LVD, FCC, EN 71, ASTM F963, RCM, KC, GCC, NOM, INMETRO, UKCA og EU AI Act. For mer krevende behov går man opp til 3B Compass på T2. For enklere behov går man ned til 1B Spark på KF1. Kjøpere som ønsker detaljer om rå OEM-program kan se gjennom sidene OEM-lesepenner og ODM-lesepenner; for innholdspubliseringsarbeidsflyter, se Startguide for private label lesepenn.
Relatert lesing
- Veikart for AI-integrasjon i lesepenner 2024–2026
- Avveininger mellom offline TTS og sky-API for lesepenner
- Forklaring av firmware-arkitektur for lesepenner
- Spesifikasjonsguide for L5-lesepenn
- Spesifikasjonsguide for T2-lesepenn
- PCB-design og EMC-kompatibilitet for lesepenner
- Oppdatering av EU CE- og EN71-regelverk for lesepenner
- Beslutningsguide for OEM versus ODM for lesepenner