

Pubblico: Questo articolo è scritto per architetti firmware, ingegneri ML e responsabili acquisti di programmi OEM/ODM che devono decidere tra l'esecuzione di un modello linguistico da 1-3 miliardi di parametri sulla penna e l'esecuzione dello stesso modello nel cloud, mantenendo la distinta materiali della penna all'interno di una fascia di $14,50 EXW.
Una penna da lettura nel 2026 non ha nulla a che fare con i lettori di punti OID del 2020. Il segmento in più rapida crescita della nostra base di spedizioni di 47.000 unità in 47 paesi dal 2023 al 2026 è la categoria dei tutor LLM (large language model) on-device, ancorata ai reference design L5, T2 e Y6 e funzionanti su un SoC Cortex-A55. La categoria esiste perché genitori, insegnanti ed editori non accettano più una penna che si limiti a leggere una parola pre-registrata. Vogliono una penna a cui si possa chiedere "cos'è una metafora?" o "dammi tre frasi con la parola faro", e che possa rispondere in modo comprensibile per un bambino di cinque anni. Questo articolo illustra cosa serve per spedire una penna del genere ai prezzi che attualmente pubblichiamo: $11,40-$13,20 EXW per L5; $12,20-$13,20 per T2; $10,80-$12,20 per Y6, tutti a un MOQ di 3.000 unità.
1. Perché LLM on-device in una penna da lettura, non nel cloud
Ci sono tre ragioni e ciascuna corrisponde a un rischio di approvvigionamento. Primo, latenza: un lettore di scuola materna ripeterà la risposta del modello solo se il modello inizia a parlare entro 600-900 ms dal prompt. Gli LLM cloud nel nostro set di misurazione 2025 hanno raggiunto una mediana di 1,8-2,4 secondi per il primo token e 2,6-4,0 secondi per un completamento di 120 token, anche con una connessione 4G sana. Un modello 1.8B on-device raggiunge una latenza del primo token di 180-260 ms e 1.200 ms per lo stesso completamento di 120 token. Secondo, privacy: nelle giurisdizioni in cui l'audio dei bambini è "informazioni personali sensibili" (GDPR-K UE, PIPL Cina, COPPA USA, LGPD Brasile, PDPA Singapore), l'invio di audio a un LLM cloud attiva il consenso di opt-in, le dichiarazioni di modello di entità e, in alcuni paesi UE, una revisione separata dell'Articolo 9. Gli LLM on-device aggirano questo problema perché nessun audio lascia la penna. Terzo, costo: a una tariffa all'ingrosso di $0,40-$0,80 per milione di token di input e una tariffa simile per l'output, un programma scolastico di 12.000 unità che esegue 4 prompt LLM per bambino al giorno paga $11.400-$22.800 all'anno in bollette cloud dopo il primo anno. Un modello 1.8B on-device aggiunge circa $3,40 di BOM per penna e zero costo marginale di inferenza per la durata del dispositivo.
Consiglio per l'acquirente: Il percorso LLM cloud sembra gratuito nella fase RFQ e si trasforma in una fattura annuale a sei cifre una volta che la distribuzione si scala. Integra l'LLM nella penna se prevedi che la distribuzione superi 8.000 interazioni LLM per penna all'anno.
2. La famiglia di modelli che spediamo nel 2026
Spediamo tre famiglie di modelli all'interno delle penne L5, T2 e Y6, ciascuna con un conteggio di parametri specifico e un regime di quantizzazione. Il tutor "Beacon" da 1.8B è il default per L5 e Y6. Il tutor "Compass" da 3B è il premium per T2. Il tutor "Spark" da 1B è il fallback per K7 e KF1 quando un acquirente desidera un footprint più leggero su un SoC A53. Tutti e tre sono modelli open-weight addestrati su un corpus curato di letteratura per bambini, curriculum scolastici e testi enciclopedici adatti all'età, poi sottoposti a fine-tuning supervisionato con esercizi di comprensione della lettura. Non sono LLM general-purpose e non hanno accesso aperto a internet. I pesi del modello vengono spediti criptati in NOR flash e decriptati all'avvio.
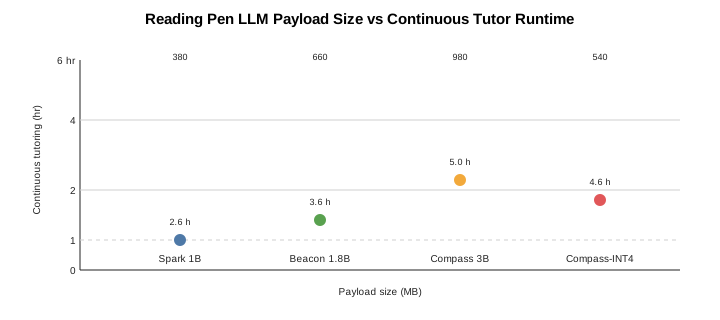
| Modello | Parametri | Quantizzazione | Ingombro in NOR | Latenza primo token (Cortex-A55) | Completamento completo (120 tok) |
|---|---|---|---|---|---|
| Spark | 1.0B | INT8 | 380 MB | 140-170 ms | 720-880 ms |
| Beacon | 1.8B | INT8 | 660 MB | 180-260 ms | 1.000-1.200 ms |
| Compass | 3.0B | INT8 + head a 4 bit | 980 MB | 280-340 ms | 1.800-2.200 ms |
| Compass (L5-Q) | 3.0B | INT4 aggressivo | 540 MB | 220-260 ms | 1.400-1.800 ms |
Il modello Compass aggressivo a 4 bit riduce gli stessi pesi 3B a 540 MB al costo di una piccola perdita di qualità sulle domande di comprensione più difficili. Lo utilizziamo quando la penna dell'acquirente ha solo 32 MB di NOR e 256 MB di DDR (la variante a basso costo L5-Q), che è rara ma disponibile su richiesta.


3. Scelte di quantizzazione che mantengono il modello sotto 1 GB
Un modello 3B in FP16 pesa circa 6 GB. Questo è più della metà di un iPad, quindi non si adatta a una penna da lettura. Il modo in cui lo adattiamo è la quantizzazione. La quantizzazione INT8 da sola dimezza l'ingombro e recupera l'80% della perplessità FP16 su un set di valutazione di letteratura per bambini. La quantizzazione INT4 spinge il peso nella banda di 1 GB con un calo di perplessità del 12-15%, che è accettabile per vocabolario e comprensione della lettura ma visibile sulla matematica aperta. La variante "head" a 4 bit che usiamo solo su T2 quantizza gli ultimi quattro blocchi transformer a 4 bit, lasciando il resto a 8 bit; questo preserva la fluidità conversazionale riducendo circa 350 MB. Gli acquirenti che confrontano le varianti del modello dovrebbero guardare la perdita di valutazione sul micro-benchmark di comprensione della lettura che pubblichiamo, non il conteggio dei parametri grezzi.
4. L'involucro SoC: Cortex-A55 a 1 TOPS INT8
Il SoC di riferimento su L5, T2 e Y6 è un quad-core Cortex-A55 a 14 nm che funziona a 1,4 GHz, accoppiato con un NPU INT8 da 0,8 TOPS. L'NPU è il cavallo da lavoro per le operazioni di moltiplicazione matriciale, mentre la CPU esegue l'embedding, il tokenizer, l'assemblatore di prompt e il leggero decoder di output. Il consumo energetico durante una chiamata di inferenza è di 1,8-2,4 W, che su una batteria da 2.500 mAh (T2) yields circa 4,5 ore di tutoraggio LLM continuo o circa 11 ore di uso intermittente (circa 1 prompt al minuto). La batteria da 2.000 mAh di Y6 dà 3,6 ore continue / 8,8 ore intermittenti; la batteria da 1.200 mAh di L5 dà 2,1 ore continue / 5,6 ore intermittenti. Nessuna di queste penne supera i 43 °C di temperatura superficiale in un test di stress di inferenza di 30 minuti a 25 °C ambiente, che le mantiene all'interno della EN 71-1.
5. Il sottosistema di memoria e la compressione della KV-cache
Un modello 1.8B con una finestra di contesto di 4.096 token richiede circa 380 MB di memoria scratch a FP16 e 220 MB a INT8 perché la cache key-value domina. Per rimanere all'interno dell'involucro DDR di 256 MB di L5, applichiamo una compressione della cache KV a 4 bit che recupera il 60% della memoria cache con un calo di perplessità del 5%. T2 viene spedito con 512 MB di DDR, il che significa che può eseguire un modello 3B alla stessa finestra di contesto senza compressione KV. Y6 viene spedito con 256 MB di DDR e utilizza la compressione della cache KV a 4 bit come L5. L'infografica sul nostro articolo diarchitettura firmware della penna da lettura documenta la sequenza di avvio e la mappa di memoria di L5.
6. Ingegneria dei prompt per un bambino di cinque anni
Una penna da lettura non esegue il modello sull'utterance grezza dell'utente. Esegue il modello su un prompt templato che combina il token OID, il livello di lettura impostato dal genitore, il language pack, un preambolo di sicurezza e un esempio few-shot. L'assemblatore di prompt è un modulo C++ da 96 KB che gira sulla CPU Cortex-A55 e assembla un prompt di 280-540 token ad ogni chiamata di inferenza. L'assemblaggio tipico del prompt richiede 35-50 ms, incluso il lookup OID, il tag della lingua e il preambolo di sicurezza. L'output viene poi eseguito attraverso il classificatore di sicurezza prima di raggiungere la pipeline audio.
7. Classificatori di sicurezza e gating dei contenuti
Ogni chiamata LLM all'interno delle nostre penne 2026 passa attraverso due filtri prima che l'audio venga generato. Il primo è un classificatore blocklist di parole chiave da 4 MB che gira in 3,2 ms sulla CPU. Il secondo è un piccolo classificatore LLM di sicurezza da 12 MB che gira in 18-22 ms sull'NPU e cattura tentativi di prompt injection, jailbreak e richieste di contenuti non appropriati per l'età. Aggiorniamo i classificatori di sicurezza over-the-air ogni 60-90 giorni. L'ingombro del classificatore è indipendente dall'ingombro LLM ed è memorizzato in una partizione NOR separata. Il frame di conformità per la sicurezza è documentato nell'aggiornamento normativo CE e EN71 e nelbriefing ASTM F963 e CPSIA.
8. Budget batteria e termico sotto tutoraggio continuo
Il tutoraggio non è sempre continuo. Un bambino tipico attiva 4-8 prompt LLM per lezione di 30 minuti, con 30-90 secondi di lavoro del modello per prompt e 5-10 minuti di lettura passiva in mezzo. Il carico di lavoro intermittente produce 5,6-9,8 ore di runtime della penna con una carica completa (L5/Y6) e 8,8-14 ore su T2. Il carico di lavoro continuo (ogni 6 secondi un nuovo prompt) produce 2,1 ore su L5, 3,6 ore su Y6 e 4,5 ore su T2. Mostriamo entrambi i numeri nel datasheet perché gli acquirenti li confrontano direttamente. I numeri continui sono intrinseci al silicio; i numeri intermittenti dipendono dal pattern di utilizzo.
9. Percorso di aggiornamento del firmware per il modello
I modelli risiedono in una partizione NOR separata che può essere aggiornata over-the-air (OTA) senza toccare il firmware. Un aggiornamento del modello 1.8B INT8 è di 660 MB, che alla velocità tipica Wi-Fi 4 di 8 Mbps richiede 11-14 minuti per il download. Pianifichiamo gli aggiornamenti del modello OTA per le ore non lavorative (01:00-05:00 ora locale) e solo con il consenso parentale. L'aggiornamento del modello è protetto da una chiave pubblica da 2 KB incorporata nel firmware e firmata in fabbrica. Il meccanismo OTA è lo stesso utilizzato per gli aggiornamenti del firmware sulle penne K7, KF1 e Q6; l'architettura firmware della penna da lettura spiega la mappa delle partizioni.
10. Lista di controllo per l'approvvigionamento di una penna LLM on-device
| Punto di verifica | Requisito minimo | Penna di riferimento |
|---|---|---|
| Banda dei parametri del modello | 1B-3B INT8 | Spark / Beacon / Compass |
| Envelope RAM | 256 MB-512 MB DDR | L5 256, T2 512 |
| Footprint NOR per i pesi | 64 MB minimo, 1 GB consigliato | L5 64 MB, T2 256 MB |
| Batteria durante tutoraggio intermittente | ≥5 ore | Y6 5.6h, L5 5.6h, T2 8.8h |
| Temperatura superficiale sotto carico di 30 min | ≤43 °C @ 25 °C ambiente | Tutti e tre superati |
| Frequenza di aggiornamento del classificatore di sicurezza | 60-90 giorni | Tutti e tre, con gate OTA |
| Overlay di conformità | CE, FCC, EN 71, ASTM F963, RCM, KC, GCC, EU AI Act | Tutti e tre qualificati |
| Banda EXW | $10.80-$13.20 a 3.000 MOQ | Y6 $10.80, L5 $11.40, T2 $12.20 |
La scelta tra Spark, Beacon e Compass dipende dall'utilizzo. Gli editori che integrano esercitazioni di comprensione usano Beacon 1.8B su L5. I ministeri che desiderano tutorare ogni materia a livello scolastico usano Compass 3B su T2. I distretti scolastici con Wi-Fi limitato usano Spark 1.0B su KF1 con fallback al cloud per domande complesse.
[
11. Percorso di esecuzione OEM/ODM per penne di lettura
Per gli acquirenti che realizzano una penna di lettura brandizzata con LLM on-device, il percorso OEM è il più breve. Il nostro programma OEM (a) seleziona il design di riferimento che corrisponde alla banda EXW target dell'acquirente; (b) carica il corpus di contenuti dell'acquirente per il fine-tuning (costo tipico $4.800-$12.000 per pacchetto linguistico); (c) ribrandizza la scocca con il colore e il logo dell'acquirente; (d) emette i numeri parte dell'acquirente e spedisce sotto il codice HS dell'acquirente (8543.70, 9503.00 o 4901.99 a seconda del bundle). Il percorso ODM aggiunge (e) stampaggio personalizzato della scocca ($5.800-$9.800) e (f) selezione vocale personalizzata ($2.400 per voce). Il progetto completo dal kickoff alla prima unità prodotta richiede 90-120 giorni per un progetto OEM e 150-180 giorni per un progetto ODM.
12. Richiamo di riferimento e riepilogo delle decisioni
In sintesi, un tutor "Beacon" 1.8B on-device su una penna di lettura L5 è la scelta mediana degli acquirenti nel 2026. Offre 660 MB di pesi, completamento end-to-end a 1.200 ms, 5,6 ore di tutoraggio intermittente, una banda EXW di $11.40-$13.20 e conformità completa CE/RED/EMC/LVD, FCC, EN 71, ASTM F963, RCM, KC, GCC, NOM, INMETRO, UKCA e EU AI Act. Per esigenze a rischio più elevato, passare a Compass 3B su T2. Per esigenze a rischio inferiore, passare a Spark 1B su KF1. Gli acquirenti interessati ai dettagli grezzi del programma OEM possono consultare le pagine Pennette di Lettura OEM e Pennette di Lettura ODM; per i workflow di pubblicazione di contenuti, vedere la Guida Introduttiva alla Penna di Lettura Private Label.
Letture Correlate
- Roadmap di integrazione AI per penne di lettura 2024-2026
- Confronto tra TTS offline e API cloud per penne di lettura
- Architettura del firmware della penna di lettura spiegata
- Guida alle specifiche della penna di lettura L5
- Guida alle specifiche della penna di lettura T2
- Design PCB della penna di lettura e compatibilità EMC
- Aggiornamento normative CE e EN71 UE per penne di lettura
- Guida decisionale OEM versus ODM per penne di lettura