

Målgruppe: Denne artikel er henvendt til firmwarearkitekter, ML-ingeniører og indkøbsansvarlige i OEM/ODM-programmer, der skal beslutte, om en sprogmodel på 1-3 milliarder parametre skal køre på pennen eller i skyen – og samtidig holde pennens stykliste (BOM) inden for et EXW-bånd på 14,50 $.
En læsepen i 2026 ligner slet ikke de OID-punktlæsere fra 2020. Det hurtigst voksende segment i vores forsendelsesbase på 47 lande og 47.000 enheder fra 2023 til 2026 er kategorien on-device store sprogmodeller (LLM) som tutor, forankret på reference designs L5, T2 og Y6, der kører på en Cortex-A55 SoC. Kategorien findes, fordi forældre, lærere og forlag ikke længere accepterer en pen, der blot læser et forhåndsindtalt ord. De vil have en pen, man kan spørge "hvad er en metafor?" eller "giv mig tre sætninger med ordet fyr", og som kan svare på en måde, en femårig forstår. Denne artikel gennemgår, hvad det kræver at sende en sådan pen på de prisniveauer, vi aktuelt offentliggør: 11,40-13,20 USD EXW for L5; 12,20-13,20 USD for T2; 10,80-12,20 USD for Y6, alle ved en MOQ på 3.000 enheder.
1. Hvorfor on-device LLM i en læsepen og ikke i skyen
Der er tre grunde, og hver især knytter sig til en indkøbsrisiko. For det første latenstid: en børnehavebarnslæser vil kun gentage en models svar, hvis modellen begynder at tale inden for 600-900 ms efter prompten. Cloud-LLM'er i vores 2025-målesæt rammer en median på 1,8-2,4 sekunder for det første token og 2,6-4,0 sekunder for en 120-token-komplettering, selv på en sund 4G-forbindelse. En on-device 1,8B-model rammer en første-token-latens på 180-260 ms og 1.200 ms for den samme 120-token-komplettering. For det andet privatliv: i jurisdiktioner hvor børns lyd er "sensitive personoplysninger" (EU GDPR-K, Kinas PIPL, USA's COPPA, Brasiliens LGPD, Singapores PDPA), udløser afsendelse af lyd til en cloud-LLM opt-in-samtykke, indberetninger om dataansvarlig og i nogle EU-lande en separat Artikel 9-gennemgang. On-device-LLM'er undgår dette, fordi ingen lyd forlader pennen. For det tredje omkostninger: ved en engrospris på 0,40-0,80 USD pr. million input-tokens og en tilsvarende pris for output, betaler et skoleprogram på 12.000 enheder, der kører 4 LLM-prompts pr. barn pr. dag, 11.400-22.800 USD om året i cloudregninger efter det første år. En on-device 1,8B-model tilføjer cirka 3,40 USD i BOM pr. pen og nul marginale inferensomkostninger over enhedens levetid.
Indkøbstip: Sky-LLM-vejen ser gratis ud på RFQ-stadiet og bliver til en sekscifret årlig regning, når udrulningen skaleres. Byg LLM'en ind i pennen, hvis I forventer, at udrulningen overstiger 8.000 LLM-interaktioner pr. pen pr. år.
2. Den modelfamilie vi leverer i 2026
Vi leverer tre modelfamilier i L5-, T2- og Y6-pennene, hver med et specifikt parametertal og kvantiseringsregime. 1,8B "Beacon"-tutoren er standard for L5 og Y6. 3B "Compass"-tutoren er premium for T2. 1B "Spark"-tutoren er fallback for K7 og KF1, når en køber ønsker et lettere fodaftryk på en A53 SoC. Alle tre er open-weight-modeller trænet på et kurateret korpus af børnelitteratur, skolepensum og alderssvarende encyklopædisk tekst, derefter supervised fine-tuned med læseforståelsesøvelser. De er ikke generelle LLM'er, og de har ikke åben internetadgang. Modelvægtene leveres krypteret i NOR-flash og dekrypteres ved opstart.
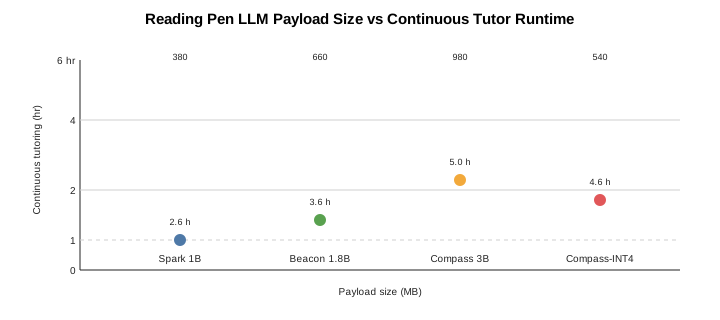
| Model | Parametre | Kvantisering | Footprint i NOR | Latenstid for første token (Cortex-A55) | Fuldkomplettering (120 tok) |
|---|---|---|---|---|---|
| Spark | 1,0B | INT8 | 380 MB | 140-170 ms | 720-880 ms |
| Beacon | 1,8B | INT8 | 660 MB | 180-260 ms | 1.000-1.200 ms |
| Compass | 3,0B | INT8 + 4-bit hoved | 980 MB | 280-340 ms | 1.800-2.200 ms |
| Compass (L5-Q) | 3,0B | INT4 aggressiv | 540 MB | 220-260 ms | 1.400-1.800 ms |
Den aggressive 4-bit Compass-model bringer de samme 3B-vægte ned på 540 MB mod et lille kvalitetstab på sværere læseforståelsesspørgsmål. Vi bruger den, når køberens pen kun har 32 MB NOR og 256 MB DDR (L5-Q lavprisvarianten), hvilket er sjældent, men kan leveres på forespørgsel.


3. Kvantiseringsvalg der holder modellen under 1 GB
En 3B-model i FP16 vejer ca. 6 GB. Det er over halvdelen af en iPad, så det passer ikke i en læsepen. Den måde, vi får det til at passe på, er kvantisering. INT8-kvantisering alene halverer footprintet og genvinder 80 % af FP16-perpleksiteten på et børnelitteratur-eval-sæt. INT4-kvantisering skubber vægtene ned i 1 GB-området med et perpleksitetstab på 12-15 %, hvilket er acceptabelt for ordforråd og læseforståelse, men synligt ved åbne matematikspørgsmål. Den 4-bit "hoved"-variant, vi bruger på T2, kvantiserer kun de sidste fire transformer-blokke til 4-bit og lader resten forblive på 8-bit; dette bevarer samtaleflyden og sparer ca. 350 MB. Købere, der sammenligner modelvarianter, bør se på eval-tabet på den læseforståelses-mikrobenchmark, vi offentliggør, og ikke på det rå parameterantal.
4. SoC-rammen: Cortex-A55 ved 1 TOPS INT8
Reference-SoC'en på L5, T2 og Y6 er en 14 nm Cortex-A55 quad-core, der kører ved 1,4 GHz, parret med en 0,8 TOPS INT8 NPU. NPU'en er arbejdshesten for matrix-multiplikationstrinene, mens CPU'en kører embedding, tokenizeren, prompt-assembleren og den lette output-dekoder. Effektforbruget under et inferenskald er 1,8-2,4 W, hvilket mod et 2.500 mAh-batteri (T2) giver ca. 4,5 timers kontinuerlig LLM-vejledning eller ca. 11 timers intermitterende brug (ca. 1 prompt pr. minut). Y6'ens 2.000 mAh-batteri giver 3,6 timers kontinuerlig / 8,8 timers intermitterende; L5'ens 1.200 mAh-batteri giver 2,1 timers kontinuerlig / 5,6 timers intermitterende. Ingen af disse penne overstiger 43 °C overfladetemperatur i en 30-minutters inferens-stresstest ved 25 °C omgivende temperatur, hvilket holder dem inden for EN 71-1.
5. Hukommelsessubsystemet og KV-cache-komprimering
En 1,8B-model med et kontekstvindue på 4.096 tokens kræver ca. 380 MB arbejdshukommelse ved FP16 og 220 MB ved INT8, fordi key-value-cachen dominerer. For at holde os inden for L5'ens 256 MB DDR-ramme anvender vi en 4-bit KV-cache-komprimering, der genvinder 60 % af cache-hukommelsen mod et perpleksitetstab på 5 %. T2 leveres med 512 MB DDR, hvilket betyder, at den kan køre en 3B-model ved samme kontekstvindue uden KV-komprimering. Y6 leveres med 256 MB DDR og bruger 4-bit KV-cache-komprimering ligesom L5. Infografikken i vores artikel om læsepennens firmware-arkitektur dokumenterer boot-sekvensen og hukommelsesmappet for L5.
6. Prompt-engineering for en femårig
En læsepen kører ikke modellen på brugerens rå ytring. Den kører modellen på en skabelonbaseret prompt, der kombinerer OID-tokenet, det forældreindstillede læseniveau, sprogpakken, en sikkerhedspræambel og et few-shot-eksempel. Prompt-assembleren er et 96 KB C++-modul, der kører på Cortex-A55-CPU'en og samler en prompt på 280-540 tokens ved hvert inferenskald. Typisk prompt-samling tager 35-50 ms, inklusive OID-opslag, sprog-tag og sikkerhedspræambel. Outputtet køres derefter gennem sikkerhedsklassificeringen, inden det når audio-pipelinen.
7. Sikkerhedsklassificering og indholdsstyring
Hvert LLM-kald i vores 2026-penne passerer gennem to filtre, inden audioen genereres. Det første er en 4 MB keyword-bloklisteklassificering, der kører på 3,2 ms på CPU'en. Det andet er en 12 MB lille-LLM-sikkerhedsklassificering, der kører på 18-22 ms på NPU'en og fanger prompt-injektionsforsøg, jailbreaks og forespørgsler om aldersupassende indhold. Vi opdaterer sikkerhedsklassificeringerne trådløst (OTA) hver 60.-90. dag. Klassificeringernes footprint er uafhængigt af LLM-footprintet og lagres i en separat NOR-partition. Overholdelsesrammen for sikkerhed er dokumenteret i CE- og EN71-reguleringsopdateringen og i ASTM F963- og CPSIA-briefingen.
8. Batteri- og termisk budget under kontinuerlig vejledning
Vejledning er ikke altid kontinuerlig. Et typisk barn udløser 4-8 LLM-prompter pr. 30-minutters lektion, med 30-90 sekunders modelarbejde pr. prompt og 5-10 minutters passiv læsning imellem. Den intermitterende arbejdsbyrde giver 5,6-9,8 timers pen-driftid på en fuld opladning (L5/Y6) og 8,8-14 timer på T2. Den kontinuerlige arbejdsbyrde (ny prompt hvert 6. sekund) giver 2,1 timer på L5, 3,6 timer på Y6 og 4,5 timer på T2. Vi angiver begge tal i databladet, fordi købere sammenligner dem direkte. De kontinuerlige tal er iboende for silicium; de intermitterende tal afhænger af brugsmønsteret.
9. Firmware-opdateringssti for modellen
Modeller lever i en separat NOR-partition, der kan opdateres trådløst (OTA) uden at firmware berøres. En 1,8B INT8-modelopdatering er 660 MB, hvilket ved Wi-Fi 4-typisk gennemløb på 8 Mbps tager 11-14 minutter at downloade. Vi planlægger OTA-modelopdateringer til uden for myldretiden (01:00-05:00 lokal tid) og kun med forældresamtykke. Modelopdateringen er beskyttet af en 2 KB offentlig nøgle indlejret i firmwaren og signeret på fabrikken. OTA-mekanismen er den samme, der bruges til firmwareopdateringer på K7-, KF1- og Q6-pennene; artiklen omlæsepennens firmware-arkitektur forklarer partitionskortet.
10. Indkøbscheckliste for en on-device LLM-pen
| Tjekpunkt | Mindstekrav | Referencepen |
|---|---|---|
| Modelparameterbånd | 1B-3B INT8 | Spark / Beacon / Compass |
| RAM-envelope | 256 MB-512 MB DDR | L5 256, T2 512 |
| NOR-fodaftryk til vægte | 64 MB minimum, 1 GB anbefales | L5 64 MB, T2 256 MB |
| Batteri ved intermitterende vejledning | ≥5 timer | Y6 5,6t, L5 5,6t, T2 8,8t |
| Overfladetemperatur ved 30 min belastning | ≤43 °C ved 25 °C omgivende | Alle tre består |
| Kadence for opdatering af sikkerhedsklassifikator | 60-90 dage | Alle tre, OTA-styret |
| Compliance-overlay | CE, FCC, EN 71, ASTM F963, RCM, KC, GCC, EU AI Act | Alle tre kvalificeret |
| EXW-prisinterval | $10.80-$13.80 ved 3.000 MOQ | Y6 $10.80, L5 $11.40, T2 $12.20 |
Valget mellem Spark, Beacon og Compass er et spørgsmål om anvendelse. Forlag, der integrerer læseforståelsesøvelser, bruger Beacon 1.8B på L5. Ministerier, der vil undervise i alle fag på klassetrin, bruger Compass 3B på T2. Skoledistrikter med begrænset Wi-Fi bruger Spark 1.0B på KF1 med fallback til skyen ved svære spørgsmål.
[
11. Eksekveringsvej for OEM/ODM af læsepenne
For købere, der bygger en brandet læsepen med en on-device-LLM, er OEM-stien den korteste. Vores OEM-program (a) vælger det reference design, der matcher køberens ønskede EXW-bånd; (b) indlæser køberens indholdskorpus til finetuning (typisk prisindeks 4.800-12.000 USD pr. sprogpakke); (c) rebrander kabinettet med køberens farve og logo; (d) udsteder køberens varenumre og sender under køberens HS-kode (8543.70, 9503.00 eller 4901.99 afhængigt af pakning). ODM-stien tilføjer (e) specialværktøj til kabinet (5.800-9.800 USD) og (f) brugerdefineret stemmevalg (2.400 USD pr. stemme). Det fulde projekt fra opstart til første produktionsenhed tager 90-120 dage for et OEM-projekt og 150-180 dage for et ODM-projekt.
12. Referencehenvisning og beslutningsoversigt
Sammenfattende er en on-device 1.8B "Beacon"-vejleder på en L5-læsepen det gennemsnitlige købervalg i 2026. Den leverer 660 MB vægte, 1.200 ms end-to-end-svartid, 5,6 timers intermitterende vejledning, et EXW-prisinterval på $11.40-$13.20 samt fuld overholdelse af CE/RED/EMC/LVD, FCC, EN 71, ASTM F963, RCM, KC, GCC, NOM, INMETRO, UKCA og EU AI Act. Til mere krævende behov kan man opgradere til 3B Compass på T2. Til mindre krævende behov kan man nedgradere til 1B Spark på KF1. Købere, der søger rå OEM-programdetaljer, kan gennemgå siden Oem læsepenne og Odm læsepenne; for arbejdsgange til indholdsudgivelse, se Starthåndbog for private label læsepenne.
Relateret læsning
- AI-integrationsplan for læsepenne 2024-2026
- Læsepen offline TTS versus cloud API-afvejninger
- Læsepen firmware-arkitektur forklaret
- L5 læsepen specifikationsguide
- T2 læsepen specifikationsguide
- Læsepen PCB-design og EMC-kompatibilitet
- Læsepen EU CE og EN71-reguleringsopdatering
- Læsepen OEM versus ODM beslutningsguide