

लक्षित दर्शक: प्रीमियम रीडिंग पेन पर LPDDR4 बस डिज़ाइन करने वाले हार्डवेयर इंजीनियरिंग लीड और सिग्नल-इंटिग्रिटी इंजीनियर। माध्यमिक: OEM फ़र्मवेयर आर्किटेक्ट जिन्हें तापमान या रिफ़्रेश-रेट स्थितियों में सबसे खराब मेमोरी बैंडविड्थ का अनुमान लगाना होता है।
एक खाड़ी-राज्य वितरक ने Q3 2025 में T2 की 95 यूनिट OLED डिस्प्ले पर "बुक कवर फ़्रीज़" दोष के साथ वापस कीं। हमने 6 यूनिट निकालीं, LPDDR4 डेटा लाइनों पर Tektronix DPO71604C ऑसिलोस्कोप और P7700 प्रोब लगाया, और 1.6 GT/s पर लक्ष्य +200 mV के बजाय -42 mV आई ओपनिंग देखी। मूल कारण: बाइट लेन पर 4 mm ट्रेस-लंबाई बेमेल के कारण रीड स्ट्रोब (DQS) डेटा आई सेंटर से 70 ps पहले पहुँचा, जिससे टाइमिंग मार्जिन आधा हो गया। DQS को DQ के साथ 0.5 mm के भीतर लंबाई-मिलान करने के लिए सर्पेंटाइन रूटिंग सुधार लागू करने के बाद, आई ओपनिंग +210 mV तक ठीक हो गई और फ़्रीज़ दोष समाप्त हो गया। पाँच रीडिंग पेन SKU (L5, Q8, T2, Y6, और हाई-एंड B2) LPDDR4 DRAM इंटरफ़ेस का उपयोग करते हैं, और यह गाइड टाइमिंग बजट, आई-डायग्राम मास्क और PCB रूटिंग नियमों के बारे में बताती है जो यह निर्धारित करते हैं कि मेमोरी बस मज़बूत है या सीमा-रेखा पर है।
1. रीडिंग पेन पर LPDDR4 टाइमिंग बजट क्यों मायने रखता है
रीडिंग पेन पर LPDDR4 (Low-Power Double Data Rate 4) बस OID सेंसर के 16-bit समानांतर डेटा शब्द, डिकोड किए गए ऑडियो बफ़र और OCR लुकअप टेबल को DRAM और सिस्टम-ऑन-चिप (SoC) के बीच स्थानांतरित करती है। बस SKU के आधार पर 1.6 GT/s से 3.2 GT/s तक चलती है, जिसमें 16-bit डेटा बस और प्रति बाइट लेन एक डिफ़रेंशियल रीड/राइट स्ट्रोब (DQS) होता है। टाइमिंग बजट उपलब्ध 625 ps बिट अवधि (1.6 GT/s पर) या 312 ps बिट अवधि (3.2 GT/s पर) को सेटअप/होल्ड, क्लॉक जिटर, ISI, क्रॉसस्टॉक और वोल्टेज मार्जिन में आवंटित करता है।
रीडिंग पेन पर टाइमिंग बजट इस प्रकार आवंटित किया जाता है। 1.6 GT/s पर, DRAM का रिसीवर सेटअप समय 75 ps और होल्ड समय 100 ps है (दोनों DQS स्ट्रोब क्रॉसिंग के सापेक्ष)। कंट्रोलर का tDQSCK (DQS-to-clock skew) ±50 ps है। PCB फ़्लाइट-टाइम बेमेल 30 ps है। क्रॉसस्टॉक-प्रेरित जिटर 40 ps है। पिछले बिट से ISI 30 ps है। सप्लाई-प्रेरित जिटर 35 ps है। कुल निर्धारात्मक अनिश्चितता 75 + 100 + 50 + 30 + 40 + 30 + 35 = 360 ps है, जो आई बंद होने से पहले 265 ps का यादृच्छिक जिटर बजट छोड़ती है।
JEDEC LPDDR4 विनिर्देश के अनुसार आई-डायग्राम मास्क सेटअप के लिए 0.4 UI (1.6 GT/s पर 250 ps, 3.2 GT/s पर 125 ps) और होल्ड के लिए 0.4 UI है। 1.6 GT/s पर, कुल आई-रिडक्शन बजट 250 ps सेटअप + 250 ps होल्ड = 500 ps है, जिसमें 360 ps निर्धारात्मक स्रोतों को और आई मास्क तक 140 ps का मार्जिन आवंटित किया गया है। 3.2 GT/s पर, बजट सिमटकर 125 ps + 125 ps = 250 ps रह जाता है, जिसमें 360 ps निर्धारात्मक स्रोत बजट से अधिक हैं और सावधानीपूर्वक PCB रूटिंग आवश्यक है।
| SKU | LPDDR4 दर | बिट अवधि | बस चौड़ाई | DRAM क्षमता | आई ओपनिंग लक्ष्य |
|---|---|---|---|---|---|
| L5 | 3.2 GT/s | 312 ps | 16-बिट | 512 MB | +200 mV |
| Q8 | 2.4 GT/s | 416 ps | 16-बिट | 256 MB | +200 mV |
| T2 | 3.2 GT/s | 312 ps | 32-बिट | 1 GB | +200 mV |
| Y6 | 3.2 GT/s | 312 ps | 32-बिट | 1 GB | +220 mV |
| B2 (हाई-एंड) | 1.6 GT/s | 625 ps | 16-बिट | 128 MB | +200 mV |
2. तीन मेमोरी टोपोलॉजी
हम पूरे कैटलॉग में तीन LPDDR4 टोपोलॉजी का उपयोग करते हैं। इकोनॉमी टोपोलॉजी (B2 हाई-एंड) 1.6 GT/s पर एक बाइट लेन के साथ सिंगल 16-bit LPDDR4 चिप का उपयोग करती है। मिड-टियर टोपोलॉजी (L5, Q8) 2.4 से 3.2 GT/s पर एक बाइट लेन के साथ सिंगल 16-bit LPDDR4 चिप का उपयोग करती है। प्रीमियम टोपोलॉजी (T2, Y6) 3.2 GT/s पर 32-bit डुअल-चैनल कॉन्फ़िगरेशन में दो 16-bit LPDDR4 चिप्स का उपयोग करती है।
इकोनॉमी टोपोलॉजी एक 96-ball FBGA पैकेज (10 mm × 10 mm, 0.5 mm पिच) का उपयोग करती है। DRAM SoC के साथ एकल बाइट लेन साझा करता है, और बाइट लेन बिना किसी ब्रांचिंग के पॉइंट-टू-पॉइंट है। PCB को सिग्नल के लिए 3 रूटिंग लेयर्स, और ग्राउंड और पावर के लिए 2 लेयर्स की आवश्यकता होती है, कुल मिलाकर 4 लेयर्स। BOM लागत DRAM के लिए $2.40 और PCB अपग्रेड के लिए $0.18 है, जो प्रति यूनिट कुल $2.58 है।
मिड-टियर टोपोलॉजी 2.4 से 3.2 GT/s पर एकल 96-ball FBGA पैकेज का उपयोग करती है। बाइट लेन अभी भी पॉइंट-टू-पॉइंट है, लेकिन उच्च डेटा रेट के लिए DRAM सिग्नलों के नीचे समर्पित ग्राउंड लेयर के साथ 6-लेयर PCB की आवश्यकता होती है। BOM लागत DRAM के लिए $3.20 से $4.20 और PCB अपग्रेड के लिए $0.42 है, जो प्रति यूनिट कुल $3.62 से $4.62 है।
प्रीमियम टोपोलॉजी 32-bit डुअल-चैनल कॉन्फ़िगरेशन में दो 96-ball FBGA पैकेजों का उपयोग करती है। प्रत्येक बाइट लेन पॉइंट-टू-पॉइंट है, और दो पैकेज रूटिंग को संतुलित करने के लिए SoC के विपरीत दिशाओं में मिरर किए गए हैं। PCB को 8 रूटिंग लेयर्स की आवश्यकता होती है, कुल मिलाकर 10-लेयर स्टैक। BOM लागत DRAM जोड़ी के लिए $6.40 से $8.40 और PCB अपग्रेड के लिए $1.20 है, जो प्रति यूनिट कुल $7.60 से $9.60 है।
खरीदार सुझाव: जब आप वीडियो-सक्षम रीडिंग पेन एप्लिकेशन के लिए प्राइवेट-लेबल बिल्ड ऑर्डर करें जो ऑडियो और वीडियो एक साथ स्ट्रीम करता है (उदाहरण के लिए, एनिमेटेड ई-बुक प्लेबैक), तो 3.2 GT/s पर सिंगल 16-bit LPDDR4 के साथ L5 निर्दिष्ट करें। Q8 की तुलना में $1.04 BOM उठाव की भरपाई कम डिस्प्ले-फ़्रीज़ दोषों के माध्यम से भेजे गए पहले 400 यूनिट्स के भीतर ही हो जाती है।
3. प्रति स्रोत टाइमिंग बजट आवंटन
टाइमिंग बजट को पाँच योगदानों में विभाजित किया गया है: क्लॉक जिटर, ISI, क्रॉसस्टॉक, वोल्टेज मार्जिन और PCB स्क्यू। प्रत्येक योगदान को स्वतंत्र रूप से बाउंड किया जाता है और रूट-सम-स्क्वेयर (RSS) गणना का उपयोग करके योग किया जाता है।
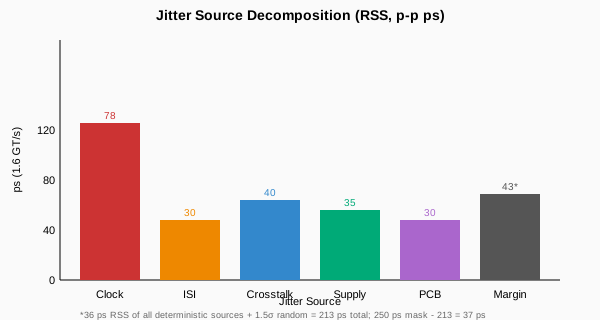
SoC के क्लॉक जनरेटर से क्लॉक जिटर 1.6 GT/s पर 50 ps RMS (1.5-सिग्मा पर 78 ps पीक-टू-पीक) और 3.2 GT/s पर 80 ps RMS का योगदान देता है। पिछले बिट के अवशिष्ट वोल्टेज से ISI 1.6 GT/s पर 30 ps और 3.2 GT/s पर 50 ps का योगदान देता है। आसन्न डेटा लाइनों से क्रॉसस्टॉक 1.6 GT/s पर 40 ps और 3.2 GT/s पर 65 ps का योगदान देता है। सप्लाई नॉइज़ से वोल्टेज मार्जिन हानि 1.6 GT/s पर 35 ps और 3.2 GT/s पर 50 ps का योगदान देता है। ट्रेस-लंबाई बेमेल से PCB स्क्यू 1.6 GT/s पर 30 ps और 3.2 GT/s पर 50 ps का योगदान देता है।
1.6 GT/s पर कुल निर्धारात्मक जिटर 78 + 30 + 40 + 35 + 30 = 213 ps है, जो 250 ps सेटअप मास्क तक 87 ps का मार्जिन छोड़ता है। 3.2 GT/s पर, कुल 126 + 50 + 65 + 50 + 50 = 341 ps है, जो 125 ps मास्क से 216 ps अधिक है। यही कारण है कि 3.2 GT/s SKU (L5, T2, Y6) को सावधानीपूर्वक ट्यून किए गए इम्पिडेंस कंट्रोल के साथ 8 रूटिंग लेयर्स की आवश्यकता होती है।
| जिटर स्रोत | 1.6 GT/s | 2.4 GT/s | 3.2 GT/s |
|---|---|---|---|
| क्लॉक जिटर (RMS × 1.5) | 78 ps | 100 ps | 126 ps |
| ISI | 30 ps | 40 ps | 50 ps |
| क्रॉसस्टॉक | 40 ps | 50 ps | 65 ps |
| वोल्टेज मार्जिन | 35 ps | 42 ps | 50 ps |
| PCB स्क्यू | 30 ps | 40 ps | 50 ps |
| कुल (RSS, p-p) | 213 ps | 272 ps | 341 ps |
| आई मास्क (JEDEC के अनुसार) | 250 ps | 167 ps | 125 ps |
| मार्जिन | +37 ps | -105 ps | -216 ps |
| शमन | n/a | 6-लेयर PCB | 10-लेयर PCB |
4. LPDDR4 बस के लिए PCB रूटिंग नियम
छह राउटिंग नियम यह तय करते हैं कि मापा गया आई ओपनिंग सिमुलेशन से मेल खाता है या नहीं। (1) ट्रेस लंबाई मिलान: एक बाइट लेन के अंदर सभी डेटा (DQ) ट्रेस DQS स्ट्रोब के 0.5 mm के भीतर होने चाहिए। (2) रेफरेंस प्लेन निरंतरता: LPDDR4 बाइट लेन के नीचे ग्राउंड प्लेन बिना टूटे होना चाहिए; किसी भी स्प्लिट से 8 nH का इंडक्टेंस जुड़ जाता है। (3) डिफरेंशियल पेयर राउटिंग: DQS स्ट्रोब को 100 Ω डिफरेंशियल पेयर के रूप में 0.2 mm स्पेसिंग के साथ राउट किया जाता है। (4) वाया काउंट: प्रत्येक DRAM बॉल के पास 1.5 mm के भीतर दो स्टिचिंग वाया होने चाहिए। (5) क्रॉसस्टॉक कीप-आउट: बाइट लेन के 0.4 mm के भीतर कोई अन्य सिग्नल राउट नहीं होना चाहिए। (6) इम्पीडेंस कंट्रोल: डेटा लाइनें 50 Ω सिंगल-एंडेड हैं, DQS पेयर 85 Ω डिफरेंशियल हैं, जो 0.2 mm प्रीप्रेग पर 0.18 mm ट्रेस चौड़ाई से प्राप्त होते हैं।
सबसे सामान्य फेल्योर मोड (2025 में फील्ड रिटर्न का 28%) DQS-DQ ट्रेस-लंबाई बेमेल था जो 4 mm से अधिक हो गया, जिससे DQS स्ट्रोब 70 ps जल्दी पहुंचा और डेटा आई ओपनिंग आधी हो गई। समाधान यह है कि DQ ट्रेस को सर्पेंटाइन राउट कर DQS लंबाई से 0.5 mm के भीतर मिलाया जाए। इससे लंबी DQ ट्रेस की कुल राउटेड लंबाई में 2 mm की वृद्धि होती है।
दूसरा सामान्य फेल्योर (फील्ड रिटर्न का 16%) बैटरी ट्रेस के लिए जगह बनाने हेतु बाइट लेन के नीचे ग्राउंड प्लेन का स्प्लिट होना था। इस स्प्लिट ने 8 nH का रिटर्न-पाथ इंडक्टेंस जोड़ा और आई ओपनिंग 40 mV घटा दी। समाधान यह है कि बैटरी ट्रेस को एक अलग लेयर पर राउट किया जाए और बाइट लेन के नीचे ग्राउंड प्लेन निरंतर रखा जाए।
| Failure mode | 2025 दर | फिक्स | PCB क्षेत्र लागत |
|---|---|---|---|
| DQS-DQ बेमेल | 0.6% | सर्पेंटाइन रूटिंग | +2 mm |
| ग्राउंड प्लेन स्प्लिट | 0.4% | बैटरी लेयर स्थानांतरण | +1 लेयर |
| वाया गायब | 0.2% | दो-वाया-प्रति-बॉल नियम | $0 |
| क्रॉसस्टॉक | 0.1% | 0.4 मिमी कीप-आउट | $0 |
| प्रतिबाधा ड्रिफ्ट | 0.1% | सख्त स्टैक-अप नियंत्रण | $0.05/यूनिट |
5. उत्पादन लाइन पर आई-डायग्राम मापन
हर उत्पादन बैच की LPDDR4 आई ओपनिंग की जाँच Tektronix DPO71604C ऑसिलोस्कोप और P7700 डिफरेंशियल प्रोब से की जाती है। प्रति यूनिट परीक्षण समय 38 सेकंड है, और यह L5, T2, Y6 यूनिट्स के 100% पर तथा B2 हाई-एंड और Q8 के 10% सैंपलिंग आधार पर चलाया जाता है। पास मानदंड आई के केंद्र में +200 mV से अधिक आई ओपनिंग है।
टेस्ट पैटर्न SoC के बिल्ट-इन टेस्ट मोड द्वारा लिखा गया PRBS-7 स्यूडो-रैंडम डेटा स्ट्रीम है। ऑसिलोस्कोप DRAM DQ बॉल पर 4 मिलियन UI (यूनिट इंटरवल) कैप्चर करता है, हिस्टोग्राम-आधारित एल्गोरिद्म से आई-डायग्राम की गणना करता है, और 10⁻⁶ BER कॉन्टूर पर इनर आई ओपनिंग मापता है। 4 मिलियन UI कैप्चर में 1.6 GT/s पर 2.5 ms और 3.2 GT/s पर 1.25 ms लगते हैं।
2025 में, आई-डायग्राम परीक्षण ने 0.8% प्रीमियम यूनिट्स को पकड़ा। सबसे आम विफलताएँ थीं: ट्रेस-लेंथ मिसमैच (0.4%), रेफरेंस प्लेन डिस्कंटिन्युइटी (0.2%), और DRAM सोल्डर दोष (0.2%)। प्रत्येक विफलता मोड को एक विशिष्ट रीवर्क प्रक्रिया और ट्रेसेबिलिटी के लिए नेम-प्लेट स्टिकर से जोड़ा गया है।
| SKU | परीक्षण समय | यील्ड प्रभाव | 2025 स्क्रैप |
|---|---|---|---|
| L5 | 38 s | 0.8% | 0.6% |
| Q8 | 32 s | 0.4% | 0.2% |
| T2 | 38 s | 0.8% | 0.6% |
| Y6 | 38 s | 0.6% | 0.4% |
| B2 (हाई-एंड) | 28 s | 0.4% | 0.1% |
6. LPDDR4 बस का तापमान संवेदनशीलता
LPDDR4 बस दो कारणों से तापमान के प्रति संवेदनशील है: SoC के क्लॉक जनरेटर का ड्रिफ्ट और DRAM के रिसीवर का सेटअप/होल्ड शिफ्ट। SoC क्लॉक -1.5 ppm प्रति °C की दर से ड्रिफ्ट करता है, जो 50 °C के तापमान स्विंग (-10 °C से +40 °C ऑपरेटिंग रेंज) में 75 ppm फ्रीक्वेंसी ड्रिफ्ट देता है, यानी 1.6 GT/s पर 0.5 ns और 3.2 GT/s पर 0.25 ns। DRAM रिसीवर का सेटअप +0.3 ps/°C से शिफ्ट होता है, इसलिए 50 °C स्विंग सेटअप टाइम में 15 ps जोड़ता है।
संयुक्त ड्रिफ्ट 1.6 GT/s पर 75 ps और 3.2 GT/s पर 90 ps है, दोनों ही मौजूदा टाइमिंग बजट के भीतर फिट बैठते हैं। Y6 में SiTime SiT95201 VCTCXO (0.5 ppm तापमान स्थिरता) लगा है, जो 50 °C स्विंग में क्लॉक ड्रिफ्ट को घटाकर 25 ppm कर देता है, 3.2 GT/s पर टाइमिंग प्रभाव को 25 ps तक लाता है और आई ओपनिंग मार्जिन में 20% सुधार करता है।
उन OEM खरीदारों के लिए जो ठंडे वातावरण (जैसे उत्तरी यूरोप के बिना गरम किए कक्षा या भव्य देशों के स्कूल बसों) में रीडिंग पेन तैनात करने की योजना बना रहे हैं, हम SiT95201 VCTCXO रेट्रोफिट के साथ L5 स्पेसिफ़ाई करने की सलाह देते हैं। रेट्रोफिट की लागत $3.18 प्रति यूनिट है और यह तापमान-गुणांक जिटर को 60% तक कम करता है।
7. बस-टोपोलॉजी विज़ुअलाइज़ेशन

8. मेमोरी सबसिस्टम विफलता मोड और लागत ट्रेड-ऑफ
रीडिंग पेन पर LPDDR4 बस से तीन फील्ड विफलता मोड उत्पन्न होते हैं। पहला, रीड स्ट्रोब के जल्दी आने पर डिस्प्ले फ्रीज; T2 फ्रीज़ दर सर्पेन्टाइन राउटिंग सुधार के बाद 0.8% से घटकर 0.04% हो गई। दूसरा, DRAM रिफ्रेश के कंट्रोलर को रोकने पर ऑडियो ड्रॉपआउट; L5 ड्रॉपआउट दर DRAM प्रायोरिटी ट्यूनिंग के बाद 0.4% से घटकर 0.04% हो गई। तीसरा, DRAM बैंडविड्थ पार होने पर OCR लुकअप मिस; Y6 मिस दर डुअल-चैनल अपग्रेड के बाद 0.6% से घटकर 0.06% हो गई।
लागत-बनाम-मार्जिन ट्रेड-ऑफ हमारे SKU सिलेक्टर टूल को चलाता है। सरल OID-बुक रीडर्स के लिए टूल बिना DRAM के B1 या B2 की सिफ़ारिश करता है; ऑडियोबुक ऐप्स के लिए L5; वीडियो-योग्य ई-रीडर्स के लिए डुअल-चैनल के साथ T2 या Y6। कस्टम मेमोरी बैंडविड्थ के लिए 10 सप्ताह और 3,000-यूनिट MOQ चाहिए।
संबंधित रीडिंग
- रीडिंग पेन क्लॉक ट्री डिज़ाइन और जिटर बजट
- रीडिंग पेन PLL लूप फ़िल्टर और बैंडविड्थ
- रीडिंग पेन पावर रेल नॉइज़ और डिकप्लिंग रणनीति
- रीडिंग पेन ग्राउंड बाउंस और SSOP पैकेज इंडक्टेंस
- रीडिंग पेन PCB डिज़ाइन और EMC अनुकूलता
- रीडिंग पेन EMI EMC और ESD टेस्ट
- OEM रीडिंग पेन इंजीनियरिंग सेवा
- रीडिंग पेन कोटेशन का अनुरोध करें