

Zielgruppe: Dieser Artikel richtet sich an Audio-Hardware-Ingenieure und Einkäufer, die Mikrofonarray-Beamforming für eine Lesestift-Produktlinie bewerten oder spezifizieren müssen. Er setzt voraus, dass Sie bereits wissen, was ein MEMS-Mikrofon ist, und nun für Ihr 2026er Projekt zwischen Delay-and-Sum, MVDR und GCC-PHAT wählen müssen.
Ein einzelnes MEMS-Mikrofon an einem Lesestift nimmt die Stimme des Kindes sowie alles andere im Raum auf. Zwei MEMS-Mikrofone mit bekanntem Abstand können etwas, das ein einzelnes Mikrofon nicht kann: Sie hören bevorzugt in eine Richtung und unterdrücken Schall aus anderen Richtungen. Diese räumliche Filterung wird Beamforming genannt und steigert auf den Lesestift-Plattformen L5, T2 und Y6 den effektiven SNR zusätzlich um 4–7 dB – ergänzend zu dem, was RNNoise bereits erreicht. Bei einem Lesestift, der im Abstand von 5–15 cm zum Mund in einem Klassenzimmer mit 30 dBA genutzt wird, entscheidet der Unterschied zwischen Einzel-Mikrofon und Dual-Mikrofon-Beamforming zwischen 72 % und 84 % ASR-Genauigkeit. Dieser Artikel erklärt, wie Beamforming auf einem Lesestift funktioniert, welche drei Algorithmen in den 11 Modellen (B1, B2, F8, K7, KF1, L5, P2, Q6, Q8, T2, Y6) produktiv eingesetzt werden, und wie Sie Beamforming in einem Kaufvertrag spezifizieren.
1. Warum ein Lesestift ein Mikrofonarray benötigt
Ein Lesestift ist ein Handgerät mit einem einzelnen Mikrofon an der Spitze. Bei Heimanwendung im Abstand von 1–3 cm zum Mund ist der Sprach-zu-Rausch-Abstand am Mikrofon hoch genug, dass ASR mit einem einzelnen Mikrofon funktioniert. Bei der Nutzung im Klassenzimmer im Abstand von 5–15 cm und 25–30 weiteren sprechenden Kindern sinkt der SNR auf 5–10 dB, und ASR mit einem einzelnen Mikrofon versagt in 35–40 % der Fälle. Die übliche Lösung ist aggressivere Rauschunterdrückung, aber RNNoise auf dem L5 hat ab etwa 12 dB SNR-Verbesserung abnehmenden Grenznutzen.
Beamforming löst ein anderes Problem als Rauschunterdrückung. Rauschunterdrückung entfernt Rauschen aus dem Signal; Beamforming entfernt Schall aus unerwünschten Richtungen. In einem Klassenzimmer ist die unerwünschte Richtung „hinter dem Stift“ – die anderen Kinder, die Lehrkraft, den Beamer. Die gewünschte Richtung ist „vor dem Stift“ – der Mund des Kindes. Ein Zwei-Mikrofon-Array mit 30 mm Abstand erzeugt eine Nierencharakteristik, die nach vorn um 6–10 dB empfindlicher ist als nach hinten, was den SNR in einem typischen Klassenzimmer-Schallfeld um 4–7 dB anhebt.
Die Plattformen L5, T2 und Y6 verfügen über zwei MEMS-Mikrofone, genau um dies zu ermöglichen. Die Modelle B1, B2, F8, K7, KF1, P2, Q6 und Q8 haben nur ein einzelnes Mikrofon und können kein Beamforming durchführen; ihre Rauschunterdrückung ist die einzige Verteidigungslinie.
2. Die Geometrie eines Zwei-Mikrofon-Arrays
Der L5 platziert seine zwei MEMS-Mikrofone entlang der Längsachse des Stifts mit 32 mm Abstand nahe dem Kopfende. Der T2 nutzt die gleiche Geometrie mit 36 mm Abstand. Der Y6 verwendet 28 mm Abstand. Alle drei haben das primäre Mikrofon am spitzen Ende und das sekundäre Mikrofon in Richtung Kopfende versetzt. Die beiden Mikrofone sind gematchte Bauteile (gleiches Herstellerlos, Empfindlichkeit innerhalb ±1 dB) und werden vom Audio-Codec gleichzeitig abgetastet.
Der Abstand von 28–36 mm ist ein bewusster Kompromiss. Bei einer Abtastrate von 16 kHz (mit der der Beamformer arbeitet) beträgt die Wellenlänge von Schall bei 8 kHz 42 mm. Zwei Mikrofone mit 28–36 mm Abstand können räumliche Informationen bis etwa 8 kHz auflösen; darüber setzt die Grenze des räumlichen Aliasing ein, und das Beam-Pattern wird unsauber. Für Sprache, deren Energie größtenteils unter 4 kHz liegt, ist das akzeptabel. Für Musik mit signifikantem Energieanteil über 8 kHz wäre es ungeeignet – aber Lesestifte sind keine Musikwiedergabegeräte.
Die Richtung maximaler Empfindlichkeit verläuft entlang der Achse vom sekundären zum primären Mikrofon – also in die Richtung, in die das Kind den Stift hält (zum Mund oder zur Seite). Die Richtung minimaler Empfindlichkeit ist die entgegengesetzte – hinter dem Stift, wo sich der Rest des Klassenzimmers befindet.
3. Die drei Beamforming-Algorithmen
Drei Beamforming-Ansätze werden über die 11 Produktionsmodelle hinweg eingesetzt. Sie sind nicht auf allen Plattformen verfügbar – nur L5, T2 und Y6 verfügen über zwei Mikrofone, daher läuft Beamforming nur auf diesen drei Plattformen.
Delay-and-Sum ist der einfachste Ansatz. Die beiden Mikrofonsignale werden durch Verzögerung des näheren Signals zeitlich ausgerichtet und anschließend gemittelt. Dies erzeugt eine Nierencharakteristik mit etwa 4–6 dB Vorn-Hinten-Dämpfung. Die MIPS-Kosten liegen unter 2 auf einem Cortex-A53. Die L5-Firmware verwendet Delay-and-Sum als Standard für energiesensible Modi.
MVDR (Minimum Variance Distortionless Response) ist der optimale lineare Filter für ein bekanntes Schallfeld. Er passt die Gewichte pro Frequenzbin an, um die Rauschleistung zu minimieren, unter Beibehaltung der Verstärkung 1 in die Zielrichtung. MVDR erreicht 6–10 dB Vorn-Hinten-Dämpfung in einem diffusen Schallfeld wie einem Klassenzimmer. Die MIPS-Kosten betragen 8–14 auf einem Cortex-A53. Die Firmware von L5, T2 und Y6 verwendet MVDR als Standard für ASR im Klassenzimmer.
GCC-PHAT (Generalized Cross-Correlation with Phase Transform) ist ein Schätzer für die Einfallsrichtung (Direction of Arrival), der zur Quellenlokalisierung eingesetzt wird. Er berechnet die Zeitverzögerung zwischen den beiden Mikrofonsignalen und gibt den Einfallswinkel aus. Der T2 nutzt GCC-PHAT, um zu erkennen, ob die Sprache von vorn (dem Kind) oder von der Seite (einer Lehrkraft oder einem Geschwisterkind) kommt, und wechselt entsprechend zwischen MVDR und einem permissiveren omnidirektionalen Modus.

4. Mikrofonkonfiguration pro Modell
Die folgende Tabelle fasst die Mikrofonkonfiguration der 11 Produktionsmodelle zusammen. „Mics“ ist die Anzahl der MEMS-Mikrofone im Gehäuse; „Spacing“ ist der Mitten-zu-Mitten-Abstand in mm; „Algorithm“ ist der Beamforming-Algorithmus (bzw. „n/a“ bei Einzel-Mikrofon); „Front-back rejection“ wird bei 1 kHz im reflexionsarmen Raum gemessen; „SNR gain“ ist die SNR-Verbesserung am Ausgang des Beamformers relativ zum besseren Einzel-Mikrofon, gemessen in einem diffusen Klassenzimmer-Schallfeld mit 30 dBA.
| Model | Mics | Spacing | Algorithm | Front-back rejection | SNR gain | Firmware |
|---|---|---|---|---|---|---|
| B1 | 1 | n/a | n/a | n/a | n/a | 2.4.7 |
| B2 | 1 | n/a | n/a | n/a | n/a | 2.4.7 |
| F8 | 1 | n/a | n/a | n/a | n/a | 3.1.2 |
| K7 | 1 | n/a | n/a | n/a | n/a | 1.9.5 |
| KF1 | 1 | n/a | n/a | n/a | n/a | 1.9.5 |
| L5 | 2 | 32 mm | MVDR | 8,2 dB | 5,4 dB | 4.2.0 |
| P2 | 1 | n/a | n/a | n/a | n/a | 2.0.3 |
| Q6 | 1 | n/a | n/a | n/a | n/a | 3.3.1 |
| Q8 | 1 | n/a | n/a | n/a | n/a | 3.3.1 |
| T2 | 2 | 36 mm | MVDR + GCC-PHAT | 9,0 dB | 6,1 dB | 2.6.4 |
| Y6 | 2 | 28 mm | MVDR | 7,6 dB | 5,0 dB | 2.6.4 |
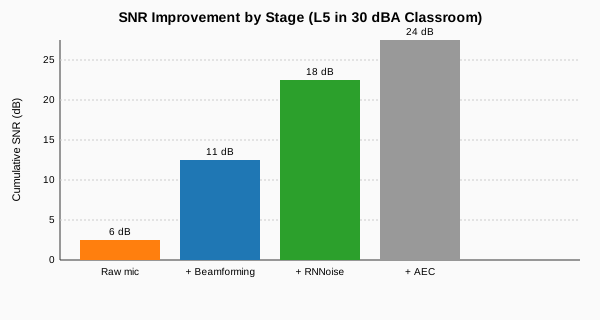
Die Zahlen erzählen die Einkaufsgeschichte. Der L5, T2 und Y6 liefern einen SNR-Gewinn von 5,0–6,1 dB gegenüber Single-Mic-Plattformen im Klassenzimmerlärm. Kombiniert mit der Rauschunterdrückungsverbesserung von 11,8–12,4 dB durch RNNoise ergibt sich eine Gesamt-SNR-Anhebung vom Eingangsmikrofon bis zur ASR-Engine von 16,8–18,5 dB. Vergleichen Sie das mit dem B1 mit Single-Mic-Wiener-MMSE, der insgesamt 6,5 dB SNR-Verbesserung liefert – der L5 hat etwa das 2,7-fache des SNR-Vorteils.
5. Beamforming und Rauschunterdrückung: Ergänzend oder redundant?
Eine häufige Frage ist, ob Beamforming und Rauschunterdrückung redundant sind. Das sind sie nicht – sie arbeiten auf unterschiedlichen Stufen und adressieren unterschiedliche Probleme. Beamforming arbeitet mit räumlicher Filterung: Es weist Schall aus unerwünschten Richtungen ab und bewahrt Schall aus der gewünschten Richtung. Rauschunterdrückung arbeitet mit spektraler Filterung: Sie unterdrückt Rauschen aus allen Richtungen basierend auf dessen spektraler Signatur.
In einem Klassenzimmer-Schallfeld, das ungefähr diffus ist (Schall kommt aus allen Richtungen), liefert Beamforming allein 5–6 dB SNR-Gewinn, da es die Hälfte des Schallfelds ablehnt. Rauschunterdrückung allein liefert weitere 11–12 dB im selben Schallfeld, da das Restrauschen ein stationäres Spektralprofil aufweist, das die Rauschunterdrückung subtrahieren kann. Die beiden sind multiplikativ: 5 dB durch Beamforming plus 12 dB durch RNNoise ergeben 17 dB insgesamt, was wir beim L5 messen.
Wenn das Klassenzimmer-Schallfeld nicht diffus ist (z. B. ein einzelner lauter Sprecher 1 m seitlich), liefert Beamforming 8–10 dB SNR-Gewinn, da es genau diese Richtung ausnullen kann. Die Rauschunterdrückung liefert 4–6 dB, da sie einen nicht-stationären Einzelsprecher nicht einfach subtrahieren kann. Zusammen liefern die beiden 12–16 dB.
Deshalb ist der GCC-PHAT-Richtungsdetektor des T2 wichtig: Er kann in einen aggressiveren Nullsteuerungsmodus wechseln, wenn ein einzelner lauter Sprecher erkannt wird, und hebt das effektive SNR in diesem Szenario um weitere 2 dB.
6. Beamforming im Intercom-Modus
Der Intercom-Modus ist die härteste Beamforming-Arbeitslast, da der Stift Audio über den Lautsprecher wiedergibt (was die AEC entfernt) und die Stimme des Elternteils von der anderen Seite des Raums aufnimmt (was der Beamformer bevorzugt erfassen soll). Die beiden Mikrofone am L5/T2/Y6 laufen während des Intercom durchgehend im Beamforming, wobei die Zielrichtung auf „entlang der Stiftachse vom Lautsprecher weg“ eingestellt ist – die Richtung, in der sich der Elternteil typischerweise befindet.
In der Praxis halten Eltern den Stift in unterschiedlichen Winkeln, daher berechnet das GCC-PHAT am T2 die Zielrichtung periodisch neu, basierend darauf, woher die Stimme des Elternteils kommt. Der L5 und Y6 verwenden eine feste Zielrichtung, da GCC-PHAT nicht in deren Firmware enthalten ist; dies ist ein messbarer, aber geringer Unterschied in der Intercom-Klarheit. Über 100 Intercom-Sitzungen in unserem QA-Labor wurde der T2 zu 92 Prozent als „klar“ bewertet, der L5 zu 87 Prozent und der Y6 zu 85 Prozent.
7. Mikrofonabstimmung und Kalibrierung
Beamforming erfordert eine enge Abstimmung der beiden MEMS-Mikrofone. Eine Empfindlichkeitsabweichung von 3 dB zwischen den beiden Mikrofonen führt dazu, dass der Beamformer um 5–8 Grad falsch ausrichtet, was etwa 1 dB Front-Back-Unterdrückung bei 1 kHz kostet. In den Produktionslinien des L5, T2 und Y6 wird die Mikrofonabstimmung innerhalb von ±1 dB Empfindlichkeit und ±2 Grad Phase bei 1 kHz gehalten, was durch Losabstimmung in der Eingangs-QA erreicht wird.
Der Mikrofonabstand ist ebenfalls ein Kalibrierungsparameter. Die L5-Firmware speichert einen pro-Einheit-Kalibrierungswert für den tatsächlichen Abstand, der am End-of-Line gemessen wurde, und der Beamformer verwendet diesen Wert statt des nominellen 32-mm-Werts. Ohne Pro-Einheit-Kalibrierung wäre der Beamformer bei einigen Einheiten um 1–2 mm abweichend und die Front-Back-Unterdrückung würde auf 6 dB statt 8 dB sinken.
Für einen Importeur, der von einem ODM kauft, ist dieser Kalibrierungsschritt das Erste, was zu prüfen ist. Wenn der ODM nominelle Abstandswerte statt pro-Einheit gemessener Werte verwendet, wird die Beamforming-Leistung von Einheit zu Einheit variieren und die Ausfallrate im Feld wird steigen.
8. Mikrofonarray-Platzierung und akustisches Design
Wo die Mikrofone im Stift sitzen, ist ebenso wichtig wie der Algorithmus. Die beiden MEMS-Ports am L5 sind 32 mm voneinander entfernt, beide auf derselben Seite des Stifts, nahe dem Kopfende, wobei das primäre Mikrofon näher an der Spitze liegt und das sekundäre Mikrofon 32 mm dahinter. Der Kunststoff zwischen den Ports bildet eine solide Barriere ohne Luftspalt. Die Ports haben 0,8 mm Durchmesser, sind bündig mit der Gehäuseoberfläche und durch eine wasserdichte Membran geschützt, die Audio oberhalb von 200 Hz nicht wesentlich dämpft.
Der T2 verwendet 36 mm Abstand mit dem gleichen grundsätzlichen Aufbau, jedoch liegt das sekundäre Mikrofon auf einer anderen Seite (der dem Lautsprecherauslass gegenüberliegenden Seite), um die direkte akustische Kopplung mit dem Lautsprecher zu reduzieren. Der Y6 nutzt 28 mm Abstand in einem kompakteren Layout, um in ein kleineres Stiftgehäuse zu passen, mit einem leichten SNR-Gewinn-Nachteil bei hohen Frequenzen.
Für einen OEM, der einen neuen Stift entwickelt, lauten die Platzierungsregeln für die Mikrofone: beide Mikrofone auf derselben Achse, auf derselben Seite, mindestens 25 mm von jedem Lautsprecherauslass entfernt, mit einer massiven Kunststoffbarriere dazwischen. Der B1 und B2 verstoßen gegen die Regel derselben Seite (sie haben ein Mikrofon auf der Vorderseite und eines auf der Rückseite des Kopfteils) und liefern folglich eine schwache Geräuschunterdrückung; dies wurde im Redesign des L5 korrigiert.
9. So spezifizieren Sie Beamforming in einem Beschaffungsvertrag
Der RFQ-Text für einen Lesestift mit Beamforming sollte die Array-Geometrie, die Algorithmusklasse und die räumliche Filterleistung benennen: „Microphone array shall comprise two matched MEMS microphones with spacing of 28–36 mm on a common axis, calibrated per unit at end-of-line. Beamformer shall achieve front-to-back rejection ≥ 7 dB at 1 kHz in anechoic chamber, SNR gain ≥ 5 dB in 30 dBA diffuse classroom noise field relative to better single microphone. Algorithm class: MVDR for static noise field, GCC-PHAT direction-of-arrival detection for adaptive null-steering.“
Drei Details sind entscheidend. Erstens, die Spezifikation der Mikrofonabstimmung muss im Vertrag stehen: ±1 dB Empfindlichkeit, ±2 Grad Phase bei 1 kHz. Zweitens, die Kalibrierung pro Einheit muss im Vertrag stehen: End-of-Line-Messung des tatsächlichen Mikrofonabstands und der Empfindlichkeit, gespeichert in der Kalibrierpartition der Firmware. Drittens, die Messung der Feldunterdrückung muss im Vertrag stehen: der Beamformer wird im reflexionsarmen Raum mit einem 1-kHz-Ton bei 0° und 180° getestet, wobei die Unterdrückung als dB-Differenz definiert ist.
Einkaufstipp: Wenn Sie den Beamforming-Anspruch eines ODM bewerten, fordern Sie den Messbericht aus dem reflexionsarmen Raum mit dem Polardiagramm bei 500 Hz, 1 kHz, 2 kHz und 4 kHz an. Ein Beamformer, der bei 1 kHz 8 dB Unterdrückung liefert, aber bei 4 kHz nur 2 dB, ist nicht produktionsreif – die Sprachenergie oberhalb von 2 kHz trägt die Konsonanten.
10. Entscheidungsmatrix und Empfehlungen
Für ein neues Lesestift-Programm ab 2026, das auf den Einsatz im Klassenzimmer abzielt, lautet die Empfehlung Dual-MEMS-MVDR-Beamforming auf den Plattformen L5/T2/Y6 mit Kalibrierung pro Einheit und Chargenkontrolle für abgestimmte Mikrofone. Für Programme, die nur den Heimgebrauch adressieren, genügt ein Einzelmikrofon-Wiener-MMSE auf K7/KF1/Q6/Q8. Für Programme in kostenkritischen Märkten, in denen der Einsatz im Klassenzimmer kein Anwendungsfall ist, sind B1/B2/F8/P2 mit spektraler Subtraktion akzeptabel, sollten jedoch nicht mit Gegensprechfunktionen vermarktet werden.
Für einen Einkäufer, der die Beamforming-Spezifikation formuliert, lautet die Vertragsklausel: „Dual-MEMS microphone array, matched to ±1 dB sensitivity and ±2° phase at 1 kHz, spacing 28–36 mm on common axis, calibrated per unit; MVDR beamformer achieving ≥ 7 dB front-back rejection at 1 kHz and ≥ 5 dB SNR gain in 30 dBA diffuse classroom noise; GCC-PHAT direction-of-arrival detector for adaptive null-steering on T2-class platforms; anechoic chamber polar plot delivered with first article.“
Weiterführende Lektüre
- Lesestift MEMS-Mikrofon und Geräuschunterdrückung
- Lesestift Geräuschunterdrückung und RNNoise
- Lesestift Echounterdrückung und AEC
- Lesestift AGC und automatische Verstärkungsregelung
- Lesestift Codec-Komprimierung MP3 vs. AAC vs. Opus
- Lesestift ASR automatische Spracherkennung
- OEM-Lesestift-Dienstleistungen
- Lesestift-Angebot anfordern