

Audiência: Este artigo destina-se a engenheiros de hardware áudio e responsáveis de compras que necessitam avaliar ou especificar beamforming de array de microfones numa linha de canetas de leitura. Parte do princípio de que já sabe o que é um microfone MEMS e que agora precisa de escolher entre delay-and-sum, MVDR e GCC-PHAT para a sua construção de 2026.
Um único microfone MEMS numa caneta de leitura capta a criança e tudo o resto na sala. Dois microfones MEMS colocados a uma distância conhecida podem fazer algo que um único microfone não consegue: ouvir preferencialmente numa direção e rejeitar som de outras direções. Esta filtragem espacial chama-se beamforming, e nas plataformas de caneta de leitura L5, T2 e Y6 eleva o SNR efetivo em mais 4–7 dB além do que o RNNoise já alcança. Para uma caneta de leitura usada a 5–15 cm da boca numa sala de aula de 30 dBA, a diferença entre beamforming com um e dois microfones é a diferença entre 72% e 84% de precisão de ASR. Este artigo explica como o beamforming funciona numa caneta de leitura, os três algoritmos em produção nos 11 modelos (B1, B2, F8, K7, KF1, L5, P2, Q6, Q8, T2, Y6) e como especificar o beamforming num contrato de compra.
1. Porque é que uma caneta de leitura precisa de um array de microfones
Uma caneta de leitura é um dispositivo portátil com um único microfone na ponta. Em uso doméstico, a 1–3 cm da boca, a relação sinal-ruído no microfone é suficientemente alta para que o ASR com um microfone funcione. Em uso na sala de aula, a 5–15 cm, com outras 25–30 crianças a falar, o SNR cai para 5–10 dB e o ASR com um microfone falha 35–40% das vezes. A solução convencional é uma supressão de ruído mais agressiva, mas o RNNoise no L5 tem rendimentos decrescentes após cerca de 12 dB de melhoria de SNR.
O beamforming resolve um problema diferente do da supressão de ruído. A supressão de ruído remove ruído do sinal; o beamforming remove som de direções indesejadas. Numa sala de aula, a direção indesejada é «atrás da caneta» — as outras crianças, o professor, o projetor. A direção pretendida é «em frente da caneta» — a boca da criança. Um array de dois microfones com 30 mm de espaçamento pode produzir um padrão de captação cardioide que é 6–10 dB mais sensível à frente do que atrás, o que eleva o SNR em 4–7 dB num campo de ruído típico de sala de aula.
As plataformas L5, T2 e Y6 têm dois microfones MEMS especificamente para possibilitar isto. As B1, B2, F8, K7, KF1, P2, Q6 e Q8 têm um único microfone e não podem fazer beamforming; a supressão de ruído é a sua única linha de defesa.
2. A geometria de um array de dois microfones
O L5 coloca os seus dois microfones MEMS ao longo do eixo longitudinal da caneta, com 32 mm de separação, perto da cabeça. O T2 usa a mesma geometria com 36 mm de espaçamento. O Y6 usa 28 mm de espaçamento. Os três têm o microfone principal na ponta e o microfone secundário deslocado para a cabeça. Os dois microfones são peças emparelhadas (mesmo lote do fabricante, sensibilidade dentro de ±1 dB) e são amostrados em simultâneo pelo codec de áudio.
O espaçamento de 28–36 mm é uma opção deliberada de design. A uma taxa de amostragem de 16 kHz (a taxa à qual o beamformer opera), o comprimento de onda do som a 8 kHz é 42 mm. Dois microfones separados por 28–36 mm conseguem resolver informação espacial até cerca de 8 kHz; acima disso, o limite de aliasing espacial entra em ação e o padrão de beam torna-se irregular. Para a fala, que tem a maior parte da sua energia abaixo dos 4 kHz, isto é aceitável. Para música, que tem energia significativa acima dos 8 kHz, não seria — mas as canetas de leitura não são dispositivos de reprodução musical.
A direção de sensibilidade máxima é ao longo do eixo que vai do microfone secundário ao microfone principal, que é a direção para a qual a criança aponta a caneta (em direção à boca ou à página). A direção de sensibilidade mínima é a oposta — atrás da caneta, onde está o resto da sala de aula.
3. Os três algoritmos de beamforming
Três abordagens de beamforming são utilizadas nos 11 modelos de produção. Não estão todas disponíveis em todas as plataformas — apenas as L5, T2 e Y6 têm dois microfones, pelo que só essas três plataformas executam beamforming.
Delay-and-sum é o mais simples. Os sinais dos dois microfones são alinhados no tempo atrasando o mais próximo e, em seguida, somados. Isto produz um padrão cardioide com cerca de 4–6 dB de rejeição frente-trás. O custo em MIPS é inferior a 2 num Cortex-A53. O firmware do L5 utiliza delay-and-sum como predefinição para os modos sensíveis ao consumo.
MVDR (Minimum Variance Distortionless Response) é o filtro linear ótimo para um campo de ruído conhecido. Adapta os pesos por bin de frequência para minimizar a potência do ruído, sujeito a manter ganho unitário na direção alvo. O MVDR produz 6–10 dB de rejeição frente-trás num campo de ruído difuso como uma sala de aula. O custo em MIPS é 8–14 num Cortex-A53. O firmware do L5, T2 e Y6 utiliza MVDR como predefinição para o ASR em sala de aula.
GCC-PHAT (Generalized Cross-Correlation with Phase Transform) é um estimador de direção de chegada utilizado para localização da fonte. Calcula o atraso temporal entre os sinais dos dois microfones e indica o ângulo de chegada. O T2 utiliza GCC-PHAT para detetar se a fala vem da frente (a criança) ou do lado (um professor ou irmão) e alterna entre MVDR e um modo omnidirecional mais permissivo em conformidade.

4. Configuração de microfones por modelo
A tabela abaixo resume a configuração de microfones nos 11 modelos de produção. «Mics» é o número de microfones MEMS na caixa; «Spacing» é a distância centro-a-centro em mm; «Algorithm» é o algoritmo de beamforming (ou «n/a» se for mono-mic); «Front-back rejection» é medida a 1 kHz numa câmara anecoica; «SNR gain» é a melhoria de SNR à saída do beamformer em relação ao melhor microfone individual, medida num campo de ruído difuso de sala de aula de 30 dBA.
| Modelo | Mics | Spacing | Algorithm | Front-back rejection | SNR gain | Firmware |
|---|---|---|---|---|---|---|
| B1 | 1 | n/a | n/a | n/a | n/a | 2.4.7 |
| B2 | 1 | n/a | n/a | n/a | n/a | 2.4.7 |
| F8 | 1 | n/a | n/a | n/a | n/a | 3.1.2 |
| K7 | 1 | n/a | n/a | n/a | n/a | 1.9.5 |
| KF1 | 1 | n/a | n/a | n/a | n/a | 1.9.5 |
| L5 | 2 | 32 mm | MVDR | 8,2 dB | 5,4 dB | 4.2.0 |
| P2 | 1 | n/a | n/a | n/a | n/a | 2.0.3 |
| Q6 | 1 | n/a | n/a | n/a | n/a | 3.3.1 |
| Q8 | 1 | n/a | n/a | n/a | n/a | 3.3.1 |
| T2 | 2 | 36 mm | MVDR + GCC-PHAT | 9,0 dB | 6,1 dB | 2.6.4 |
| Y6 | 2 | 28 mm | MVDR | 7,6 dB | 5,0 dB | 2.6.4 |
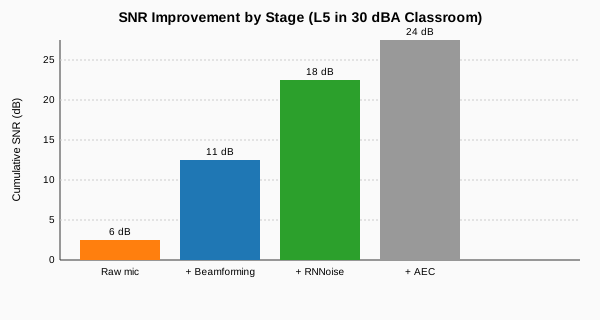
Os números contam a história para o comprador. Os L5, T2 e Y6 garantem um ganho de SNR de 5,0–6,1 dB face a plataformas com um único microfone, em ruído de sala de aula. Combinado com os 11,8–12,4 dB de melhoria na supressão de ruído da RNNoise, o aumento total de SNR, do microfone de entrada ao motor de ASR, é de 16,8–18,5 dB. Compare-se com o B1, com Wiener MMSE de microfone único, que oferece 6,5 dB de melhoria total de SNR; o L5 apresenta cerca de 2,7× mais vantagem de SNR.
5. Beamforming e supressão de ruído: camadas ou redundância?
Uma pergunta frequente é se o beamforming e a supressão de ruído são redundantes. Não são — operam em etapas distintas e resolvem problemas diferentes. O beamforming atua no domínio espacial: rejeita som das direções indesejadas preservando o som da direção pretendida. A supressão de ruído atua no domínio espectral: rejeita ruído em todas as direções com base na sua assinatura espetral.
Num campo sonoro de sala de aula aproximadamente difuso (som a chegar de todas as direções), o beamforming por si só garante 5–6 dB de ganho de SNR porque rejeita metade do campo de ruído. A supressão de ruído sozinha garante mais 11–12 dB no mesmo campo de ruído porque o ruído residual tem um perfil espetral estacionário que a supressão de ruído consegue subtrair. Os dois efeitos são multiplicativos: 5 dB do beamforming mais 12 dB da RNNoise dão 17 dB no total, que é o que medimos no L5.
Se o campo sonoro da sala de aula não for difuso (por exemplo, um único interlocutor alto a 1 m de lado), o beamforming garante 8–10 dB de ganho de SNR porque consegue anular essa direção específica. A supressão de ruído garante 4–6 dB porque não consegue subtrair facilmente um único interlocutor não estacionário. As duas em conjunto garantem 12–16 dB.
É por isto que o detetor de direção de chegada GCC-PHAT do T2 é importante: permite mudar para um modo de anulação mais agressivo quando é detetado um único interlocutor alto, elevando o SNR efetivo em mais 2 dB nesse cenário.
6. Beamforming no modo intercomunicador
O modo intercomunicador é a carga de trabalho mais exigente para o beamforming porque a caneta reproduz áudio através do altifalante (que o AEC remove) e capta a voz do progenitor do outro lado da sala (que o beamformer deve privilegiar). Os dois microfones do L5/T2/Y6 executam beamforming continuamente durante o intercomunicador, com a direção alvo definida como «ao longo do eixo da caneta, afastando-se do altifalante» — a direção onde tipicamente estará o progenitor.
Na prática, os progenitores seguram a caneta em ângulos variáveis, pelo que o GCC-PHAT do T2 recalcula periodicamente a direção alvo com base na proveniência da voz do progenitor. O L5 e o Y6 usam uma direção alvo fixa porque o GCC-PHAT não está disponível no seu firmware; trata-se de uma diferença mensurável mas pequena na clareza do intercomunicador. Em 100 sessões de intercomunicador no nosso laboratório de QA, o T2 foi classificado como «claro» 92 % das vezes, o L5 87 % e o Y6 85 %.
7. Emparelhamento e calibração dos microfones
O beamforming exige que os dois microfones MEMS estejam bem emparelhados. Uma diferença de sensibilidade de 3 dB entre os dois microfones faz o beamformer desalinhar 5–8 graus, o que custa cerca de 1 dB de rejeição frente-trás a 1 kHz. Nas linhas de produção do L5, T2 e Y6, o emparelhamento dos microfones é mantido dentro de ±1 dB de sensibilidade e ±2 graus de fase a 1 kHz, conseguido através de emparelhamento por lote no QA de entrada.
O espaçamento entre microfones é também um parâmetro de calibração. O firmware do L5 guarda um valor de calibração por unidade para o espaçamento real medido em fim de linha, e o beamformer usa este valor em vez do valor nominal de 32 mm. Sem calibração por unidade, o beamformer teria um erro de 1–2 mm em algumas unidades e a rejeição frente-trás cairia para 6 dB em vez de 8 dB.
Para um importador que compra a um ODM, este passo de calibração é a primeira coisa a verificar. Se o ODM estiver a usar valores de espaçamento nominais em vez dos valores medidos por unidade, o desempenho do beamforming variará de unidade para unidade e a taxa de falhas em campo aumentará.
8. Posicionamento da matriz de microfones e conceção acústica
A localização dos microfones na caneta é tão importante como o algoritmo. As duas portas MEMS do L5 estão separadas 32 mm, na mesma face da caneta, perto da extremidade da cabeça, com o microfone principal mais próximo da ponta e o microfone secundário 32 mm atrás. O plástico entre as portas é uma barreira sólida sem folga de ar. As portas têm 0,8 mm de diâmetro, alinhadas com a superfície da caixa, e estão protegidas por uma membrana impermeável que não atenua significativamente o áudio acima de 200 Hz.
O T2 utiliza um espaçamento de 36 mm com a mesma disposição geral, mas o microfone secundário está numa face diferente (o lado oposto à porta do altifalante) para reduzir o acoplamento acústico direto com o altifalante. O Y6 utiliza um espaçamento de 28 mm numa disposição mais compacta para se adaptar a uma caneta de chassis mais pequeno, com uma ligeira penalização de ganho de SNR nas frequências altas.
Para um OEM a desenhar uma nova caneta, as regras de colocação dos microfones são: ambos os microfones no mesmo eixo, na mesma face, a pelo menos 25 mm de qualquer porta de altifalante, com uma barreira plástica sólida entre eles. Os modelos B1 e B2 violam a regra da mesma face (possuem um microfone na face frontal e outro na face traseira da cabeça) e, consequentemente, apresentam uma supressão de ruído fraca; este problema foi corrigido na reformulação do L5.
9. Como Especificar Beamforming num Contrato de Compras
A linguagem do pedido de cotação para uma caneta de leitura com conformação de feixe deve designar a geometria do arranjo, a classe do algoritmo e o desempenho da filtragem espacial: «O arranjo de microfones será constituído por dois microfones MEMS emparelhados com espaçamento de 28–36 mm num eixo comum, calibrados por unidade no final da linha de fabrico. O conformador de feixe deve alcançar uma rejeição frente-trás ≥ 7 dB a 1 kHz em câmara anecoica, ganho de SNR ≥ 5 dB num campo de ruído difuso de sala de aula de 30 dBA relativamente ao melhor microfone individual. Classe do algoritmo: MVDR para campo de ruído estático, deteção de direção de chegada GCC-PHAT para orientação adaptativa de nulos.»
Três detalhes são importantes. Primeiro, microphone matching spec deve constar no contrato: sensibilidade de ±1 dB, fase de ±2 graus a 1 kHz. Segundo, per-unit calibration deve constar no contrato: medição em fim de linha do espaçamento real dos microfones e da sensibilidade, armazenada na partição de calibração do firmware. Terceiro, field rejection measurement deve constar no contrato: o beamformer é testado numa câmara anecoica com um tom de 1 kHz a 0° e 180°, sendo a rejeição definida como a diferença em dB.
Dica para o comprador: Ao avaliar a alegação de beamforming de um ODM, solicite o relatório de medição em câmara anecoica que mostre o padrão polar a 500 Hz, 1 kHz, 2 kHz e 4 kHz. Um beamformer que apresenta 8 dB de rejeição a 1 kHz, mas apenas 2 dB a 4 kHz, não está pronto para produção — a energia da fala acima de 2 kHz transporta as consoantes.
10. Matriz de Decisão e Recomendações
Para um programa de canetas de leitura totalmente novo, com início em 2026 e destinado a implementação em sala de aula, a recomendação é dual-MEMS MVDR beamforming on the L5/T2/Y6 platforms com calibração por unidade e controlo de lote de microfones emparelhados. Para programas destinados exclusivamente a uso doméstico, o Wiener MMSE com microfone único nas plataformas K7/KF1/Q6/Q8 é suficiente. Para programas direcionados a mercados sensíveis ao preço onde a implementação em sala de aula não é um caso de uso, os modelos B1/B2/F8/P2 com subtração espectral são aceitáveis, mas não devem ser vendidos com funcionalidades de modo intercomunicador.
Para um responsável de compras a redigir a especificação de conformação de feixe, a cláusula que encerra o contrato lê-se: «Arranjo de microfones MEMS duplos, emparelhados com sensibilidade de ±1 dB e fase de ±2° a 1 kHz, espaçamento de 28–36 mm em eixo comum, calibrados por unidade; conformador de feixe MVDR que atinge rejeição frente-trás ₹7 dB a 1 kHz e ganho de SNR ₹5 dB em ruído difuso de sala de aula de 30 dBA; detetor de direção de chegada GCC-PHAT para orientação adaptativa de nulos em plataformas de classe T2; diagrama polar em câmara anecoica entregue com o primeiro artigo.»
Leitura Relacionada
- Microfone MEMS e Cancelamento de Ruído da Caneta de Leitura
- Supressão de Ruído e RNNoise da Caneta de Leitura
- Cancelamento de Eco e AEC da Caneta de Leitura
- AGC e Controlo Automático de Ganho da Caneta de Leitura
- Compressão de Codec da Caneta de Leitura MP3 vs AAC vs Opus
- ASR Reconhecimento Automático de Voz da Caneta de Leitura
- Serviços OEM de Canetas de Leitura
- Solicite um Orçamento para Caneta de Leitura